Новости «Искусственный Интеллект»
FastFlowLM 1.0

11 августа опубликован FastFlowLM 1.0, первый общий выпуск проекта после его перехода под управление AMD. FastFlowLM представляет собой систему локального запуска больших языковых и мультимодальных моделей на NPU в процессорах AMD Ryzen AI, ориентированную на похожий на Ollama сценарий работы, но с использованием нейропроцессора вместо GPU.
Переход имеет для проекта особое значение: 17 июля команда FastFlowLM присоединилась к AMD, а разработка была переведена из FastFlowLM/FastFlowLM в организацию ROCm на GitHub. AMD заявила, что FastFlowLM войдёт в программный стек компании для клиентских систем и рабочих станций с ИИ-ускорителями. При переносе сохранены история репозитория, issues и pull requests, а все последующие выпуски будут публиковаться в ROCm/FastFlowLM.
FastFlowLM предназначен для NPU архитектуры AMD XDNA2 и поддерживает семейства Ryzen AI Strix Point, Strix Halo, Kraken Point и Gorgon Point. Проект позволяет запускать на NPU языковые и vision-language модели, модели распознавания речи, embeddings и MoE. Заявлена поддержка контекстного окна вплоть до 256 тыс. токенов для некоторых моделей. Размер самого runtime составляет около 17 МБ.
Основные изменения FastFlowLM 1.0:
( читать дальше... )
>>> Источник (github.com)
Языковая модель с 28,9 млн параметров заработала на ESP32-S3
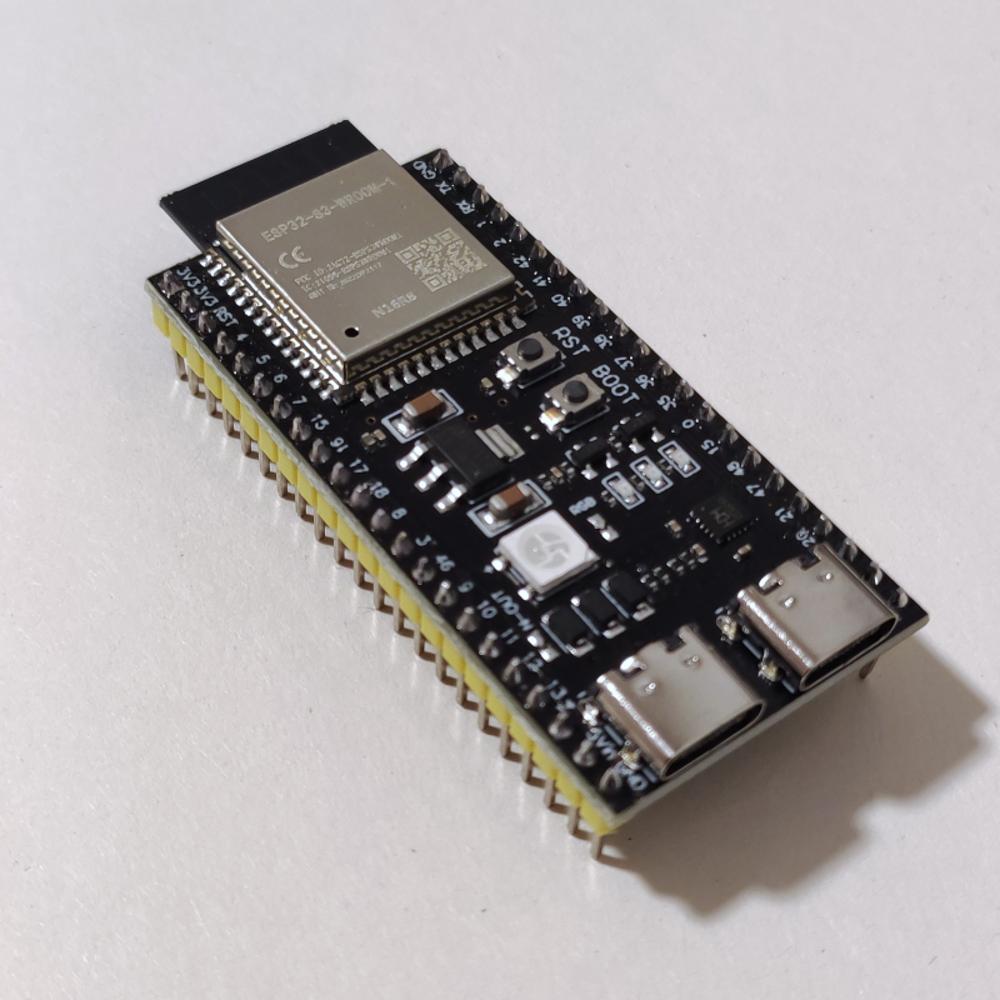
Разработчик Вячеслав Сербов, выступающий под псевдонимом slvDev, продемонстрировал полностью локальную генерацию текста на микроконтроллере ESP32-S3. Созданная им языковая модель содержит 28,9 млн параметров и выдаёт около 9,9 токена в секунду, не обращаясь к серверу или другим внешним вычислительным ресурсам. Сгенерированные короткие рассказы выводятся на подключённый OLED-дисплей.
( читать дальше... )
>>> Источник (github.com)
Линус Торвальдс предложил противникам использования ИИ форкнуть Linux или уйти
15 июля 2026 года Линус Торвальдс жёстко высказался против попыток объявить разработку ядра Linux территорией, свободной от искусственного интеллекта. В сообщении в списке рассылки linux-media он заявил, что Linux «не относится к анти-ИИ-проектам», а несогласные с этим могут воспользоваться предоставляемой свободным ПО возможностью и создать собственное ответвление проекта — либо просто покинуть его. Письмо было отправлено 14 июля в 20:06 по тихоокеанскому времени, что соответствует 15 июля по UTC.
Спор возник в обсуждении возможной интеграции системы учёта патчей Patchwork с Sashiko — открытым агентным средством рецензирования изменений ядра Linux. Система отслеживает общедоступные списки рассылки, анализирует поступающие патчи при помощи языковых моделей и пытается обнаруживать архитектурные ошибки, проблемы безопасности, управления ресурсами и параллельного выполнения. Код Sashiko передан Linux Foundation и распространяется под Apache 2.0, а работу публичного сервиса и расходы на используемые модели оплачивает Google.
( читать дальше... )
>>> Источник (kernel.org)
Госдума России приняла закон «О поддержке развития технологий искусственного интеллекта в Российской Федерации»
Сразу во 2-м и 3-м чтении 8.07.2026 был принят очень важный для целой отрасли закон. Закон носит рамочный характер и предполагает, что правительство выпустит массу подзаконных актов, регулирующих отдельные технические и правовые вопросы. Закон, в случае одобрения Советом Федерации и Президентом РФ, вступит в действие в основном уже с 1 сентября 2026 г., хотя полностью все положения заработают с 1 марта 2027 г. В ситуации уже состоявшегося внедрения моделей, там где потребуется применение только национальных или суверенных моделей, их можно будет продолжать использовать до 1 сентября 2032 г.
( читать дальше... )
>>> Страница принятого законопроекта (duma.gov.ru)
Anthropic ввела в Claude тихий саботаж разработки моделей машинного обучения
Недавно (с 9 июня 2026) разработчики нейросетей столкнулись с явлением, которое может иметь далеко идущие последствия. Производители LLM уже не только явно отказывают клиентам в работе над определёнными темами, но и внедряются неявные механизмы. Известная модель Claude, которая считается одной из лучших или даже самой лучшей LLM для разработки программ, тихо и незаметно (в отличие от таких вещей как кибербезопасность, биология и химия) тупит, если детектирует, что с её помощью пытаются вести разработку других моделей.
( читать дальше... )
>>> PDF от Anthropic с условием (anthropic.com)
AMD GAIA 0.20.0
Опубликован выпуск AMD GAIA 0.20.0 — открытого фреймворка для запуска локальных AI-агентов на ПК с аппаратным ускорением AMD Ryzen AI. Проект распространяется под лицензией MIT, поддерживает Windows и Linux, а установка доступна через пакет amd-gaia. Сам тег v0.20.0 опубликован 3 июня, но в новостную ленту релиз попал 4–5 июня.
Главное изменение версии — нормальный выбор устройства выполнения для каждого агента. Раньше GAIA по умолчанию использовала GPU через backend на базе llama.cpp и не давала удобного способа переключить конкретного агента на CPU или энергоэффективный Ryzen AI NPU. В GAIA 0.20.0 агенты могут объявлять поддерживаемые устройства, а пользователь выбирает CPU, GPU или NPU через Agent UI либо CLI-флаг --device {cpu,gpu,npu}. GPU остаётся вариантом по умолчанию, а профиль gaia init --profile npu берёт на себя обнаружение NPU, установку FLM-backend и загрузку модели.
Изменения в выпуске:
( читать дальше... )
>>> Источник (github.com)
JetBrains открыла Mellum2 — MoE-модель для быстрых AI-сценариев в разработке
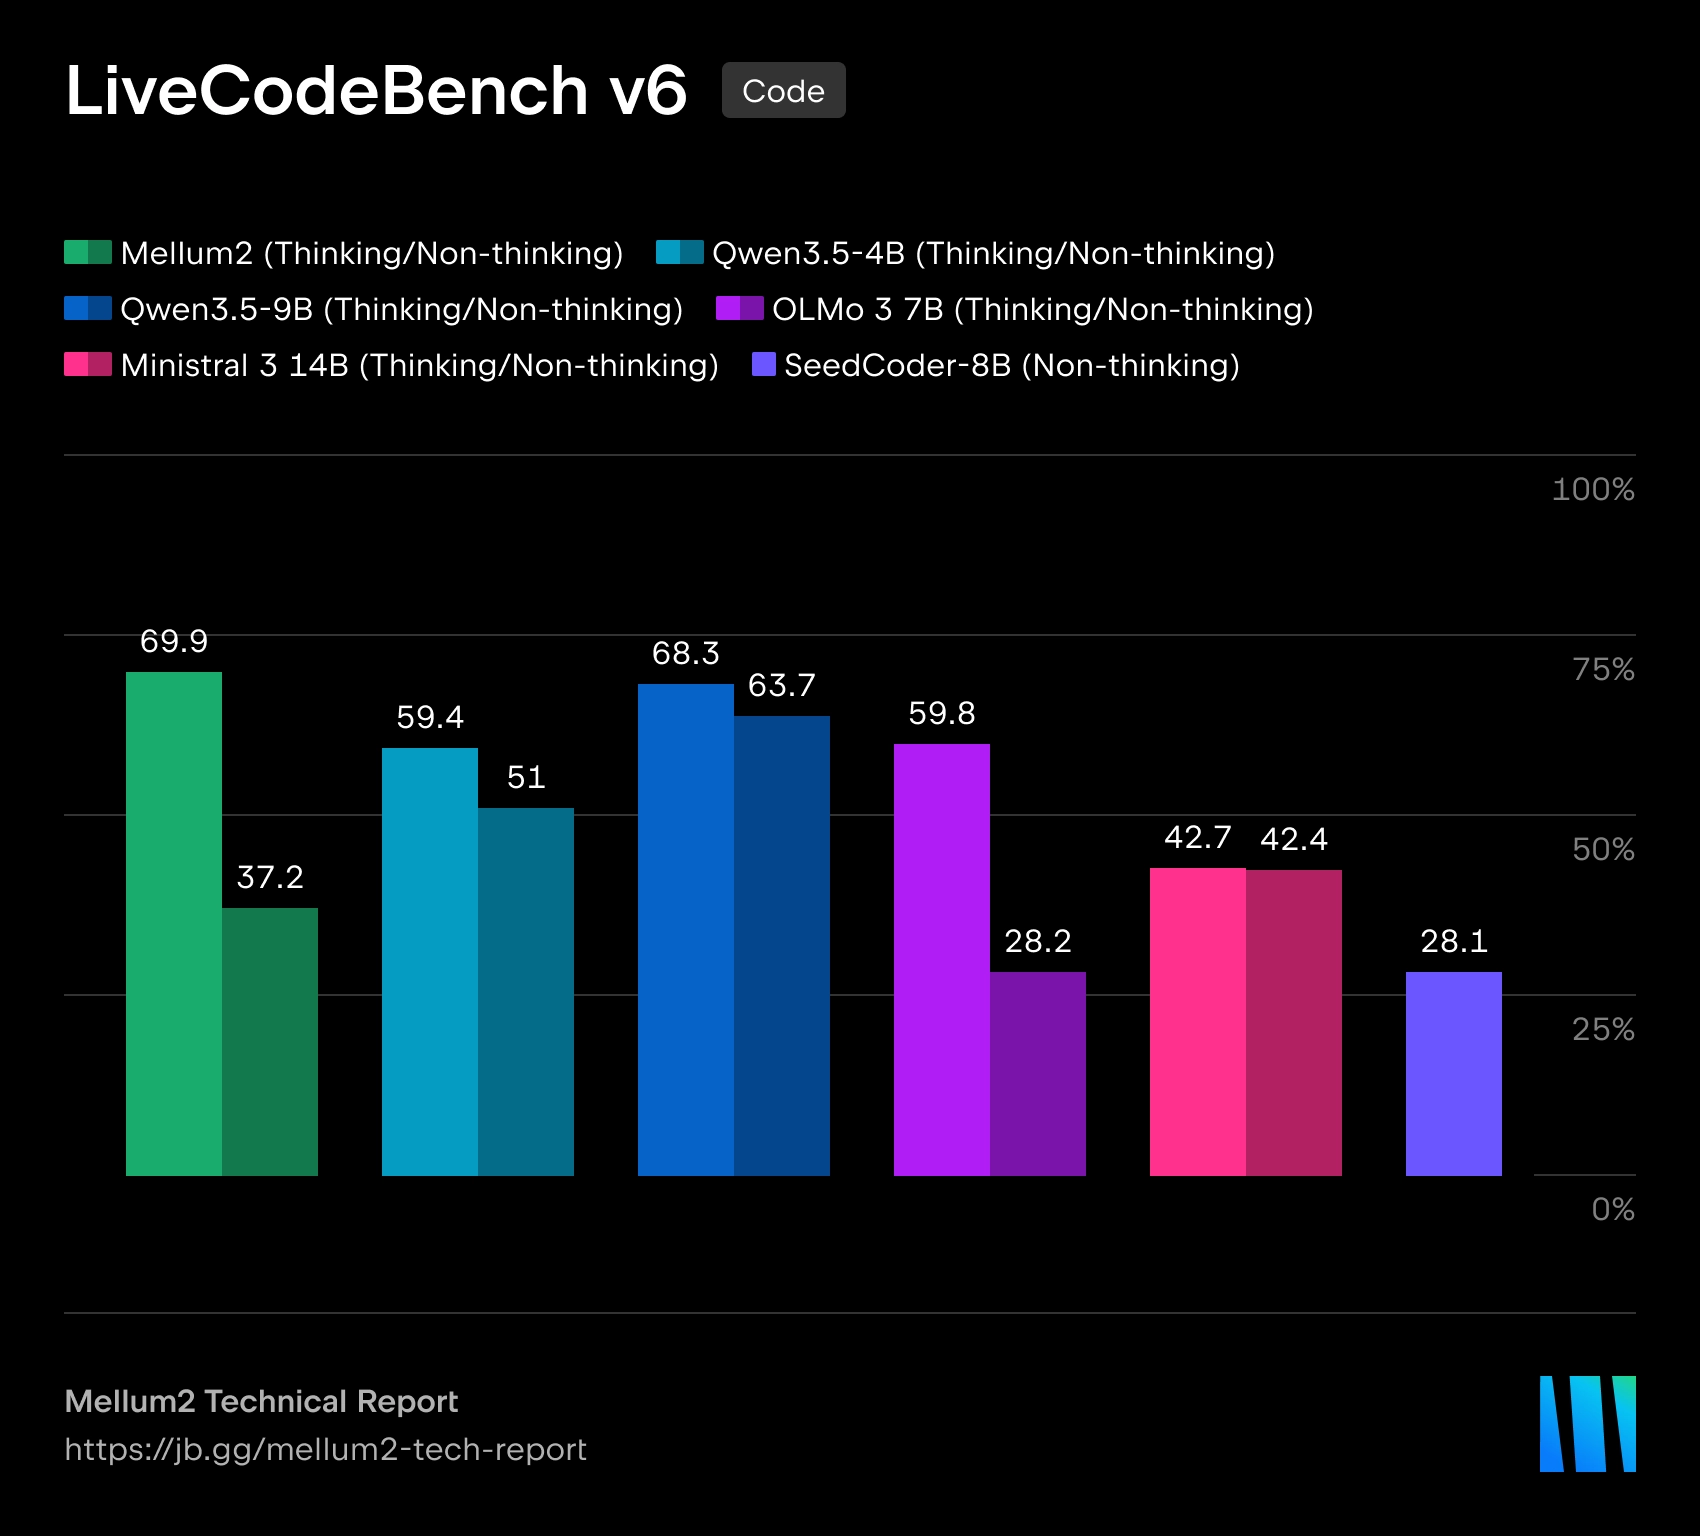
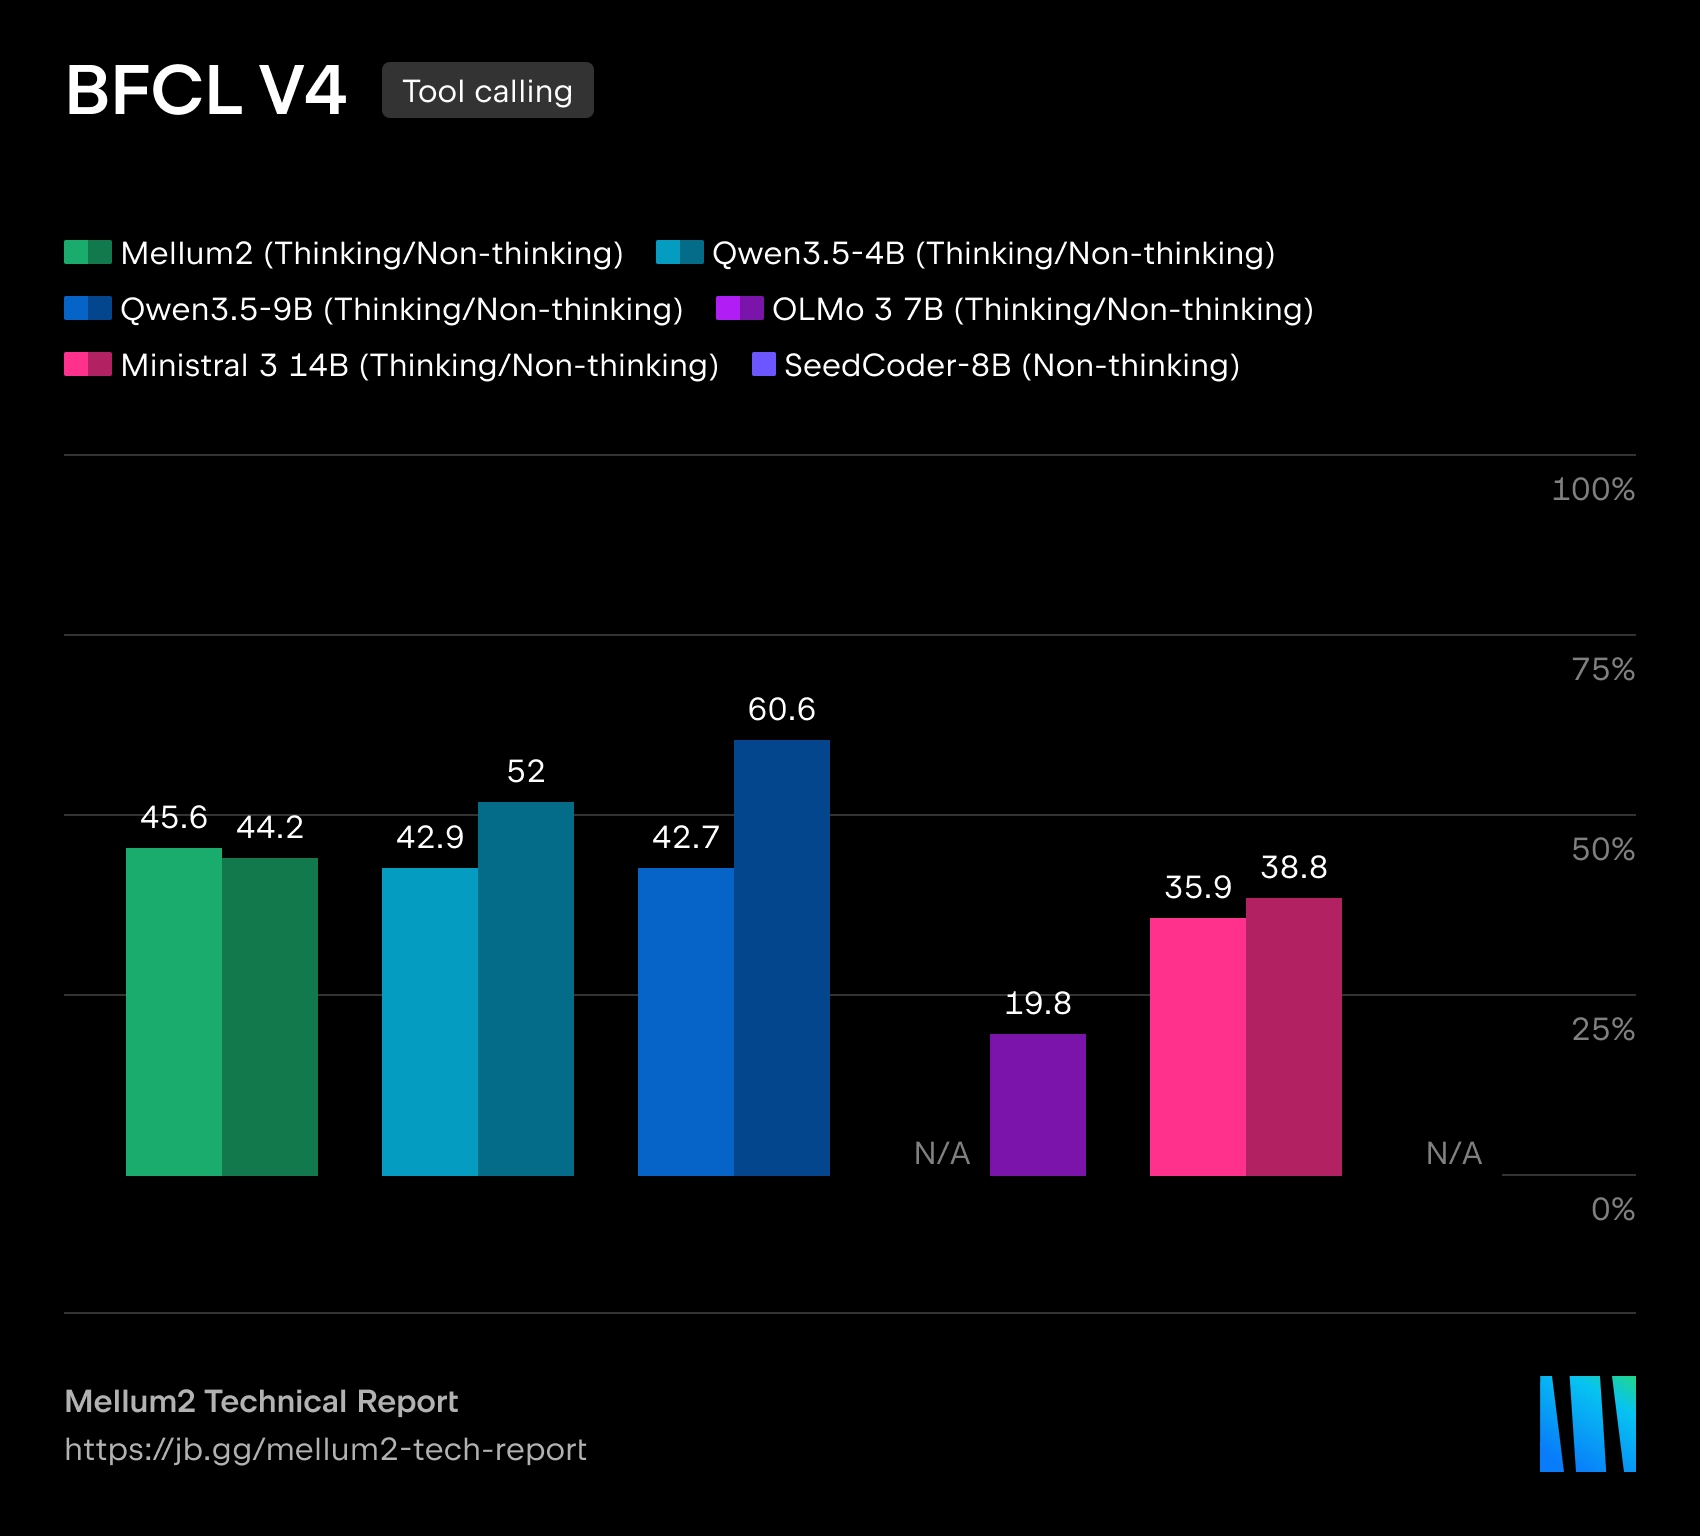
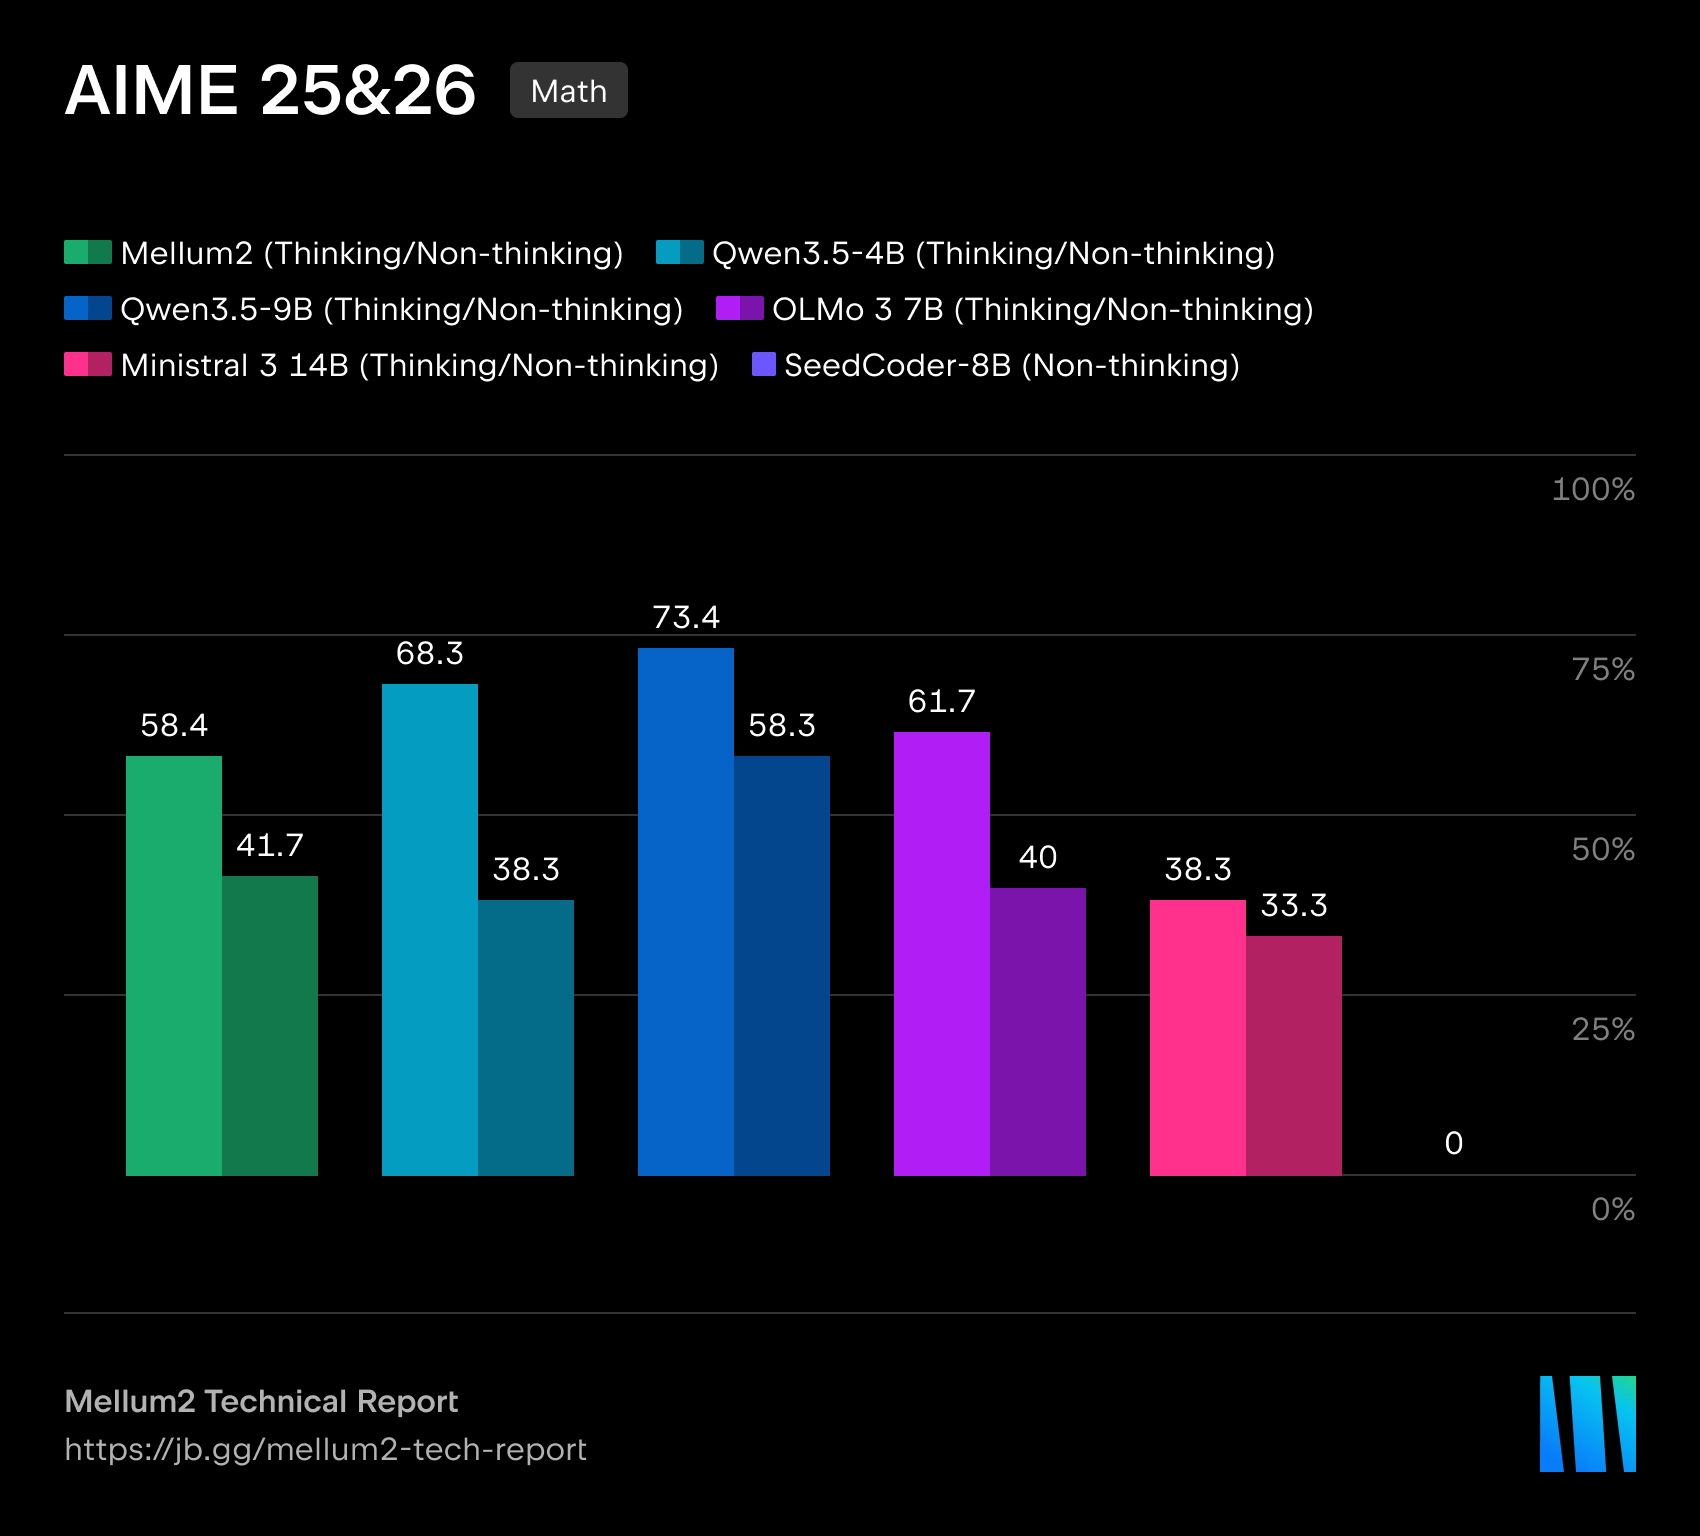
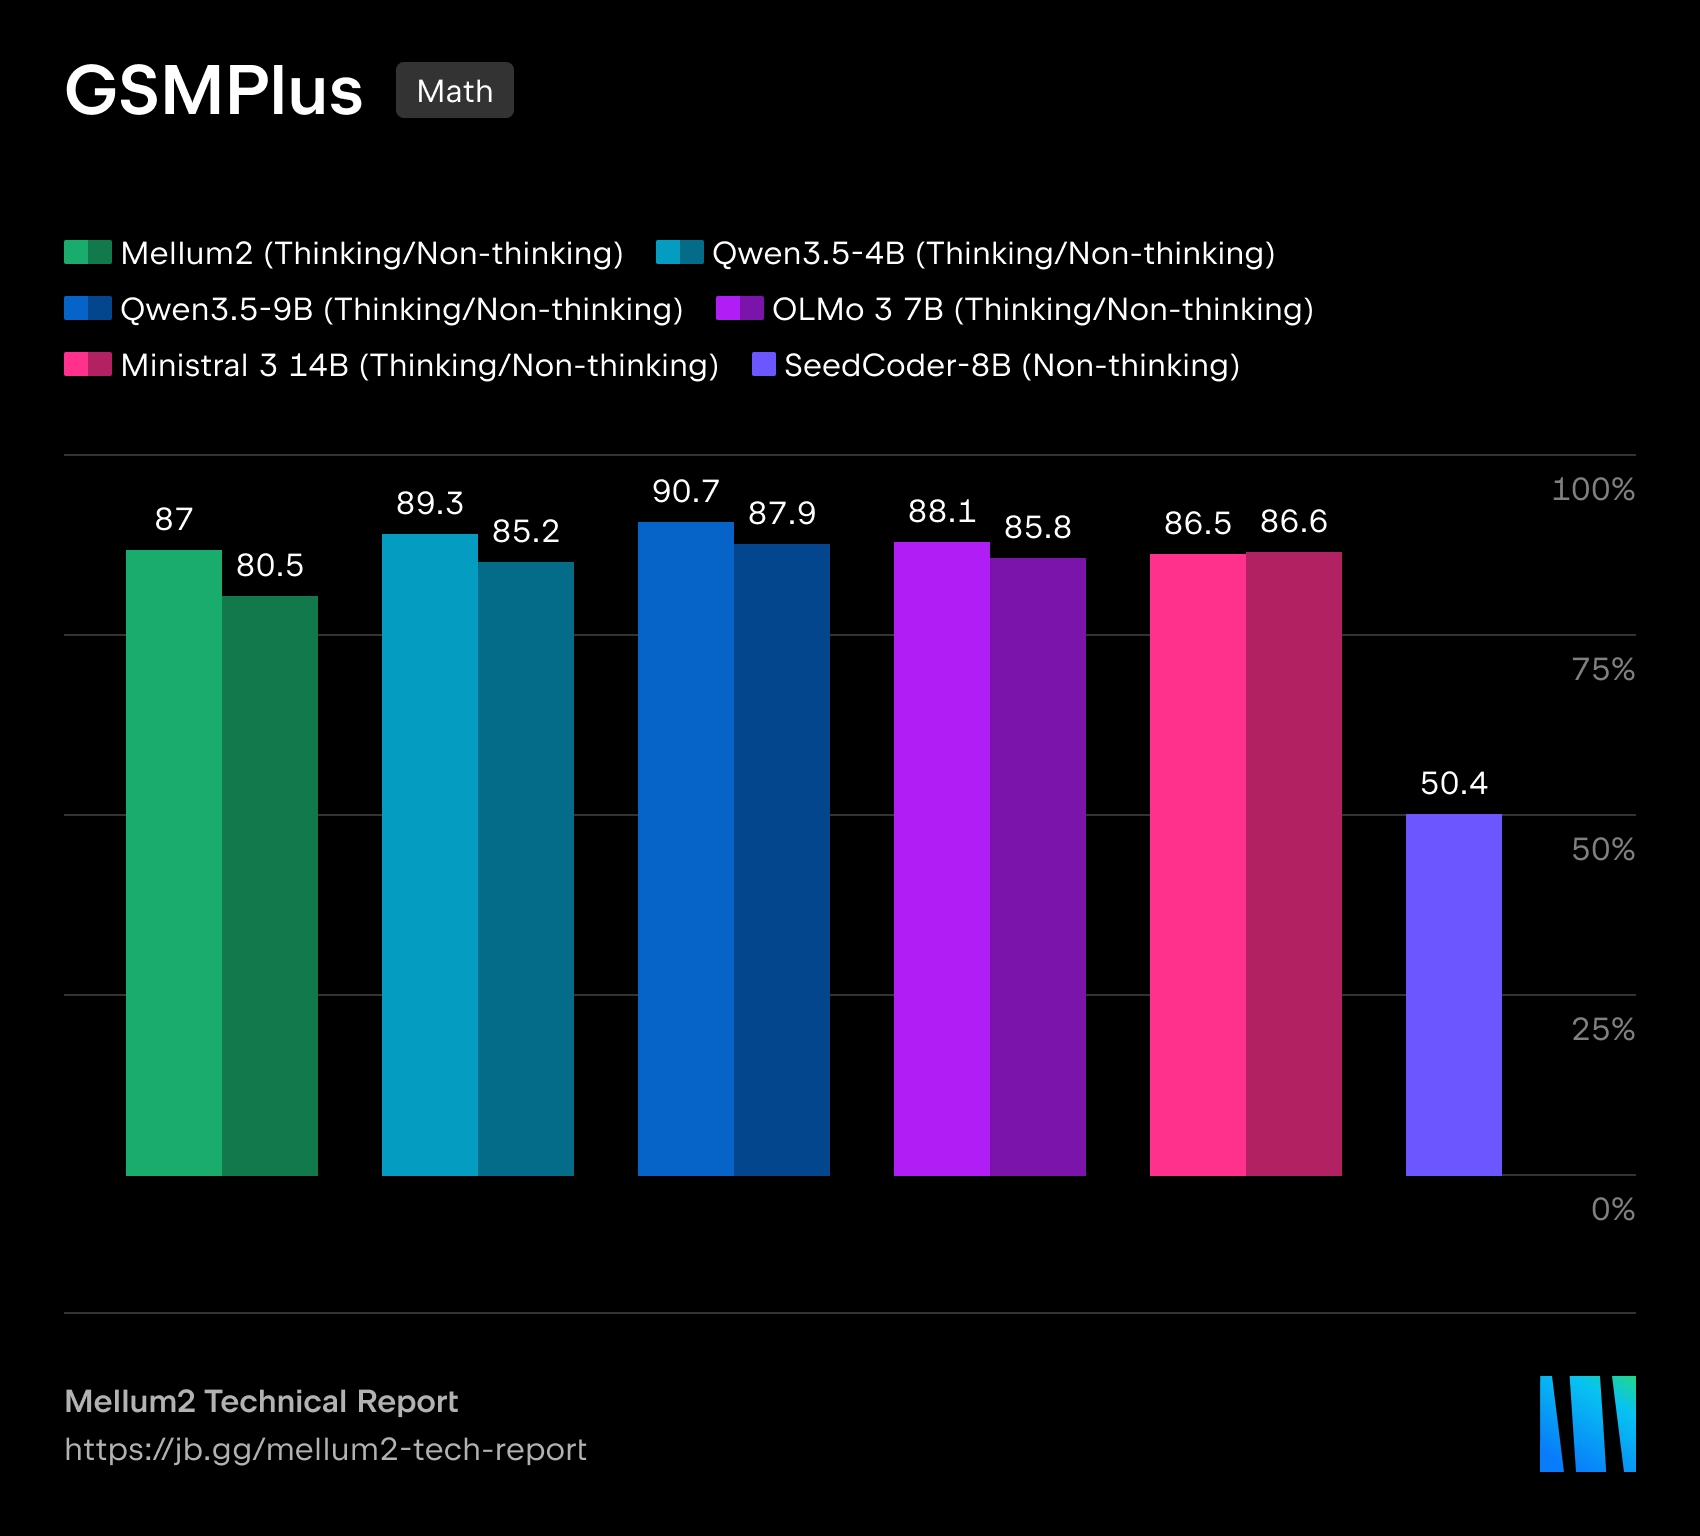
Компания JetBrains открыла модель Mellum2, предназначенную для использования в AI-инструментах для разработки ПО. Модель опубликована под лицензией Apache 2.0, веса доступны на Hugging Face. В JetBrains подчёркивают, что Mellum2 обучалась с нуля и рассчитана не на мультимодальные задачи, а на работу с текстом и кодом: маршрутизацию запросов, RAG-конвейеры, суммаризацию, вспомогательных агентов и приватное развёртывание в инфраструктуре компаний.
Mellum2 построена по архитектуре Mixture-of-Experts. При общем размере в 12 млрд параметров на каждый токен активируется только около 2.5 млрд параметров, что должно снижать вычислительные затраты и задержки при инференсе. По утверждению JetBrains, по производительности на бенчмарках модель сопоставима с открытыми моделями близкого размера, но обеспечивает более чем двукратное ускорение инференса.
( читать дальше... )
>>> Источник (jetbrains.com)
Node.js меняет программу bug bounty из-за ИИ-мусора

Проект Node.js меняет программу вознаграждений за найденные ошибки после того, как разработчики столкнулись с потоком отчетов, созданных с помощью искусственного интеллекта, которые трудно оценить.
Теперь для отправки отчетов об уязвимостях HackerOne в проект Node.js требуется показатель Signal 1.0 или выше.
( читать дальше... )
Signal — это метрика репутации в HackerOne, которая отражает качество прошлых отчетов исследователя. Высокий Signal указывает на историю валидных и значимых находок. Это требование помогает расставлять приоритеты в пользу отчетов от экспертов с доказанным опытом и снижает нагрузку по разбору некорректных заявок.
>>> Источник (nodejs.org)
Curl закрывает программу bug bounty из-за ИИ-мусора
Проект curl прекратил программу вознаграждения за найденные ошибки после того, как разработчики столкнулись с потоком отчетов, созданных с помощью искусственного интеллекта, которые трудно оценить.
На прошлой неделе Даниэль Стенберг, руководитель проекта, разместил на GitHub запись, сообщающую о завершении программы к концу января 2026 года. Он ранее выражал недовольство по поводу баг-репортов от ИИ в начале 2024 года и подумал о закрытии программы уже в середине 2025 года. Хотя он признал, что ИИ может помочь в поиске ошибок, основной проблемой стали многочисленные «бесполезные» отчеты.
В своем сообщении Стенберг отметил, что прекращение программы вознаграждения должно уменьшить поток некачественных отчетов и облегчить работу команды безопасности curl.
Стенберг также выразил надежду, что разработчики будут продолжать отправлять настоящие отчеты о безопасности, даже если финансового вознаграждения не будет.
>>> Источник (theregister.com)
GNOME.org вводит официальный запрет на публикацию расширений с кодом, сгенерированным искусственным интеллектом

Команда, отвечающая за хостинг расширений GNOME.org, объявила о прекращении приема новых дополнений для рабочего окружения GNOME Shell, если их код был создан с помощью генеративного искусственного интеллекта. В официальные правила проверки был добавлен соответствующий пункт, запрещающий подобные загрузки.
Решение обусловлено растущим числом заявок на публикацию в каталоге extensions.gnome.org, которые были сгенерированы ИИ. Новое правило в руководстве четко указывает, что такой код будет отклонен.
( читать дальше... )
>>> Подробности (phoronix.com)
whisper.cpp 1.8.0


30 сентября, после трёх месяцев разработки, состоялся выпуск 1.8.0 высокопроизводительной системы автоматического распознавания речи whisper.cpp, реализующей модель Whisper от OpenAI на языках C и C++ и распространяемой по лицензии MIT.
( читать дальше... )
>>> Подробности на GitHub (github.com)
whisper.cpp 1.7.5

2 апреля состоялся выпуск 1.7.5 высокопроизводительной системы автоматического распознавания речи whisper.cpp, реализующей модель Whisper от OpenAI, написанной на языках C и C++ и распространяемой по лицензии MIT.
В проекте используется авторская тензорная библиотека машинного обучения GGML, написанная на языке C и оптимизированная для использования различных бэкендов (CUDA, Vulkan, BLAS, SYCL, OpenCL и др.).
Это довольно большое обновление с различными улучшениями сборки и CI, особенно для iOS и WASM. Также есть некоторый прирост производительности, особенно для бэкенда Metal и, возможно, для устройств на базе Arm.
( читать дальше... )
>>> Подробности на GitHub (github.com)
Яндекс выложил в открытый доступ языковую модель YandexGPT-5-Lite

Архитектура новой языковой модели похожа на Llama или Qwen, но она обучалась полностью с нуля. Похожесть позволяет использовать тот же инструментарий. Pretrain-версия большой языковой модели YandexGPT 5 Lite на 8B параметров с длиной контекста 32k токенов. При обучении модели особое внимание уделялось русскому языку, материалы на русском составили более 70% датасета.
Старшая модель YandexGPT 5 доступна в Алисе и на сайте Яндекса, но она в открытый доступ выложена не будет.
В своей категории модель достигает паритета с мировыми SOTA по ряду ключевых бенчмарков для pretrain-моделей, а по многим другим — превосходит их. Например, по результатам внутреннего слепого попарного сравнения (side-by-side) для широкого потока запросов YandexGPT 5 Pro превосходит YandexGPT 4 Pro в 67% случаев и не уступает GPT-4o.
>>> Скачать (huggingface.co)
| следующие → |