LINUX.ORG.RU

Языковая модель с 28,9 млн параметров заработала на ESP32-S3

 esp32-s3, ,

Языковая модель с 28,9 млн параметров заработала на ESP32-S3

1

1

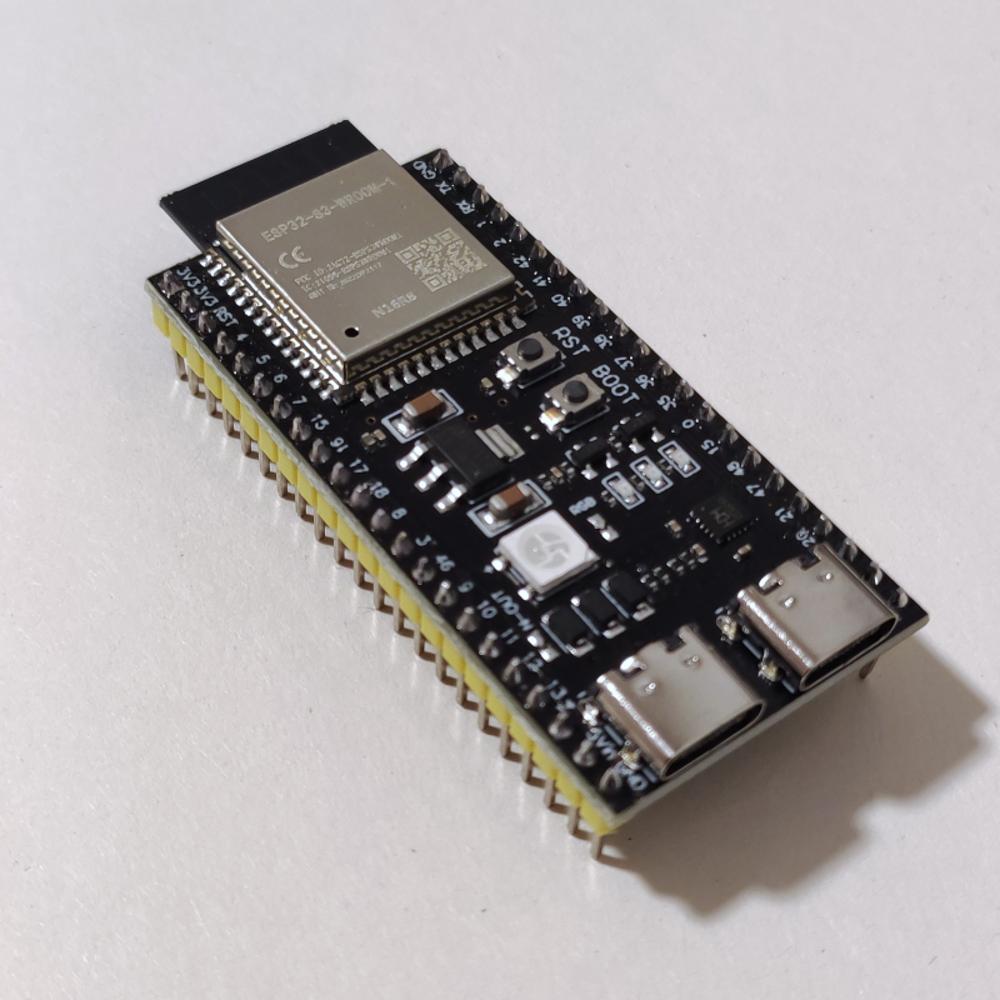
Разработчик Вячеслав Сербов, выступающий под псевдонимом slvDev, продемонстрировал полностью локальную генерацию текста на микроконтроллере ESP32-S3. Созданная им языковая модель содержит 28,9 млн параметров и выдаёт около 9,9 токена в секунду, не обращаясь к серверу или другим внешним вычислительным ресурсам. Сгенерированные короткие рассказы выводятся на подключённый OLED-дисплей.

Проект esp32-ai испытан на модуле ESP32-S3 N16R8, располагающем 512 КБ встроенной SRAM, 8 МБ PSRAM и 16 МБ флеш-памяти. Квантованная до четырёх бит модель занимает 14,9 МБ. В репозитории опубликованы исходный код среды исполнения на C, средства обучения и квантования модели, прошивка, тесты и сценарии её загрузки на плату.

Заявленные 28,9 млн параметров не следует напрямую сравнивать с числом параметров обычных настольных LLM. Согласно подробному отчёту разработчика, модель состоит из плотного вычислительного ядра примерно на 559 тысяч параметров, выходного слоя на 3,1 млн параметров и таблицы послойных векторных представлений примерно на 25 млн параметров. Именно последняя обеспечивает основную часть формального размера модели, но не обрабатывается целиком при генерации каждого токена.

Для размещения модели задействованы три уровня памяти. Наиболее часто используемые данные находятся во внутренней SRAM, выходной слой, KV-кеш и временные буферы — в PSRAM, а 25-миллионная таблица остаётся во флеш-памяти и доступна через отображение в адресное пространство. Для каждого токена из неё считывается лишь около шести строк общим объёмом примерно 450 байт.

Такое устройство основано на технологии Per-Layer Embeddings, применённой Google в Gemma 3n. Согласно документации Google, PLE-параметры могут храниться вне рабочей памяти модели и добавляться в процесс вывода по мере обработки отдельных слоёв. В esp32-ai этот подход перенесён на иерархию памяти микроконтроллера, где быстрая SRAM особенно ограничена.

Первая корректная версия написанной на C среды исполнения выдавала только 0,57 токена в секунду. После помещения выходного слоя в PSRAM, перехода к восьмибитным активациям, распределения вычислений между двумя ядрами Xtensa LX7 и других оптимизаций задержка была уменьшена до 94,9 мс на шаг модели. Итоговая измеренная скорость достигла 9,88 токена в секунду с учётом полного процесса генерации. Основным ограничением теперь стала пропускная способность PSRAM при чтении выходного слоя.

Модель обучена на синтетическом наборе данных TinyStories, состоящем из простых англоязычных рассказов с ограниченным словарём. Поэтому она способна продолжать фразы и сочинять небольшие связные истории, но не предназначена для ответов на вопросы, выполнения инструкций, программирования или воспроизведения фактических знаний. Разработчик рассматривает работу прежде всего как демонстрацию эффективного размещения модели в памяти микроконтроллера, а не как готового автономного чат-бота.

В актуальной документации автор отдельно подчёркивает, что esp32-ai является самостоятельной разработкой. Проекты llama2.c Андрея Карпати и более ранний запуск 260-тысячной модели на ESP32-S3 приводятся лишь как ориентиры и примеры предшествующих работ: код, контрольные точки и методика непосредственно из них не заимствованы. Исходный код esp32-ai распространяется под лицензией MIT.

>>> Источник

★★★★★

Проверено: hobbit ()
Последнее исправление: hobbit (всего исправлений: 2)

Разработчик рассматривает работу прежде всего как демонстрацию эффективного размещения модели в памяти микроконтроллера

Короче опять just for fun, и никакой пользы, кроме как «а мы могем»)

REDDERa
()

но не предназначена для ответов на вопросы, выполнения инструкций, программирования или воспроизведения фактических знаний.

Много аппаратных ресурсов нужно добавить для этого?

Модель обучена на синтетическом наборе данных TinyStories, состоящем из простых англоязычных рассказов с ограниченным словарём.

А если обучить модель на англоязычной википедии? Взяв подмножество статей на Basic English (simple.wikipedia.org)

greenman ★★★★★
()
Последнее исправление: greenman (всего исправлений: 1)
Ответ на: комментарий от greenman

А если обучить модель на англоязычной википедии? Взяв подмножество статей на Basic English (simple.wikipedia.org)

Будет генерировать новые статьи для википедии.

monk ★★★★★
()
Ответ на: комментарий от greenman

Много аппаратных ресурсов нужно добавить для этого?

Примерно 4 десятичных порядка.

Три порядка, чтобы масштабировать с миллионов до миллиардов параметров, а ещё 1 для адекватной скорости инференса.

wandrien ★★★★
()
Последнее исправление: wandrien (всего исправлений: 1)
Ответ на: комментарий от REDDERa

Эта штука очень похожа на МОЗГ ТЕРМИНАТОРА, если ты смотрел вторую часть.

Как в фильме «Я Робот» — Будущее наступает СЕГОДНЯ.

Set440 ★★
()
Ответ на: комментарий от amd_amd

Ну даж так… ??? Эта штука позволяет не_нанимать копирайтера, как у меня (ОТКУДА У БОМЖА ПЕЧЕНЬЕ???).

У меня НА ГЛАГНЭ описание системы составлено БРЕДОГЕНЕРАТОРОМ. Там самый бред в разделе про Хэширование, так-как SHA-512 — быстрый хэш, и его автоматом декодировать по радужным таблицам — раз плюнуть. Спасает от взлома только то, что хэш хранится исключительно в серверной сессии.

Ну а так, описалово на глагнэ — НОРМ. Надо было насочинять дифирамб с водой и баснями, чтоб отметить важность моей ЦМСки. — Бредо-Гена справился.

Set440 ★★
()
Ответ на: комментарий от Set440

Эта штука очень похожа на МОЗГ ТЕРМИНАТОРА

— Напиши короткий рассказ.
— Мне нужна твоя одежда.

Но неожиданнее будет: «Мне нужна твоя Надежда». :)

dataman ★★★★★
()
Последнее исправление: dataman (всего исправлений: 1)
Ответ на: комментарий от greenman

Много аппаратных ресурсов нужно добавить для этого?

Около 0.5-1 ТБ памяти и ~16к CUDA ядер

Gary ★★★★★
()
Последнее исправление: Gary (всего исправлений: 1)
Ответ на: комментарий от REDDERa

S3 имеет зайчатки SIMD, и , в принципе, из всех МК - топовый в смысле ИИ. Старшие модели, типа P4 еще лучше.

Решение с mmap() флешки - логичное, хорошее. Забавно, что в мире ардуинщиков про то, что ESP32S3 умеет mmap знают не многие :).

Ну и под S3 есть спецательные библиотеки оптимизированные. И для звука, и для ИИ.

vvb333007
()

Это конечно кринж подобные модели называть LLM. Поскольку LLM это большая языковая модель, которая приобретает свойства ИИ из-за своего масштаба.

v_0ver
()
Ответ на: комментарий от v_0ver

я называю сие БЯМсиками - прикольнеее звучит.
а что там за «неонка у нёй внутре» вообще может и быть и не только llm

pfg ★★★★★
()

ESP вообще были бы топчиком, если бы там половина прошивки/sdk не были блобом (а всё из-за требований регуляторов, чтоб в wifi и иных сетях были бекдоры).

peregrine ★★★★★
()
Ответ на: комментарий от v_0ver

Это конечно кринж подобные модели называть LLM.

Эллочка бы сказала «Хо-хо! Толстые и красивые!».

dataman ★★★★★
()
Ответ на: комментарий от greenman

Нужны размеченные данные для ответов и тулинга. Простой текст дает модели только базовое понимание языка и способность генерить правдоподобный бред.
250M модели с тулингом и полувменяемыми ответами точно где-то были.

vazgen05 ★★★
()
Ответ на: комментарий от peregrine

По радио тоже можно. Но пока не дошли руки PoC сделать. Там есть очень удачная гонка, если ESP32 работает в режиме AP. Гонка есть, но стек неисполняемый. И там надо очень замысловато делать, через gadgets, короче, геморой. doable, но большой геморой.

Это что касается RCE. А прсто обвалить систему по WiFi - да, можно легко.

vvb333007
()
Последнее исправление: vvb333007 (всего исправлений: 1)
Ответ на: комментарий от vvb333007

Это значит что «у кого надо» есть эксплоит. И эти эксплоиты встроены в любое железо. А до того как их можно было встроить в железо из прятали в Винде. Та же MICE посмотрите на отмазки виндузятников из микрософта. Да это вставлено намерено, да это дыра но нет это не дыра но мы ее запатчим

ckotctvo
()

это ж даже меньше, по размерам, чем на мобилках локальные.
на какой-нибудь RPi4 с 4гб озу можно запустить модель 1.5-2 млрд параметров, с условным 0.1-1 токен/с.

etwrq ★★★★★
()
Ответ на: комментарий от z0idator

ну всё, теперь память подешевеет

ХАХАХАХАХА, НЕ БУДЕТ БОЛЬШЕ НИКАКОГО ИТАЛЬЯНСКОГО СЫРА!!!! 

папа, теперь ты будешь меньше пить? (ц)

Нет Сынок!!! -- Теперь ты будешь меньше есть!!!
(ХАХАХАХАХА, НЕ БУДЕТ БОЛЬШЕ НИКАКОГО ИТАЛЬЯНСКОГО СЫРА!!!!)

Угараю с твоей аватарки.

Set440 ★★
()
Ответ на: комментарий от etwrq

это ж даже меньше, по размерам, чем на мобилках локальные.

Ясно, что меньше, Уважаемый Капитан! Размер возможной модели зависит только от объёма доступной памяти. Здесь она чётко обозначена. Сравнить с тем, что доступно мобильному телефону не должно составит труда.

VIT ★★★
()
Ответ на: комментарий от greenman

Много аппаратных ресурсов нужно добавить для этого?

Если почитать гитхаб разработчика, то видно, что он две модели натренировал. Кроме обсуждаемой в новости, другая вообще на 8.9M параметров https://huggingface.co/slvDev/esp32-ai-barista , зато на отдельном датасете (не распространяется), специально подготовленном для этой модели и условно названном Barista. В итоге модель может вести короткий чат (один вопрос, один ответ, без истории) на околокофейные темы. Например,

Q: my espresso tastes really bitter, what should i change?
A: if the cup reads bitter, coarsen a step. if it reads sour, go finer instead.
   which of those does your drink read as?

Q: how do i clean my machine
A: if the machine has never had maintenance, the manual is still where you
   start. use the recommended cleaner and descaler, and improvise nothing.
   whats your machine model?

Q: what grind size should i use for a light roast
A: when you need a procedure for a double drink or another coffee recipe, i
   cannot provide it. i can help improve the espresso shot. what problem does
   the shot have?

anonymous_incognito ★★★★★
()
Ответ на: комментарий от wandrien

Примерно 4 десятичных порядка.

Как ни странно, но даже меньше, чем в новости. Смотри моё предыдущее сообщение выше. Хотя практическая польза такого чата не уверен, что большая. Вряд ли производители кофемашин рискнули бы добавить.

anonymous_incognito ★★★★★
()
Последнее исправление: anonymous_incognito (всего исправлений: 1)
Ответ на: комментарий от REDDERa

Короче опять just for fun, и никакой пользы, кроме как «а мы могем»)

Такие небольшие языковые модели в любом случае не для вайбкодинга используются и даже не поболтать как с Алисой.

Это что-нибудь типа локального анализа данных где-нибудь на промышленных установках, например, преобразование простых текстовых команд оператора на естественном языке в структурированные машинные инструкции (JSON/Hex-коды), классификация логов и выдача диагноза про перегрев чего-то и т.п. Разумеется может потребоваться жёсткая валидация, чтобы модель ересь не гнала, и в любом случае, выполнять вспомогательную роль, скорее всего.

anonymous_incognito ★★★★★
()
Последнее исправление: anonymous_incognito (всего исправлений: 1)
Ответ на: комментарий от REDDERa

Эм, нет. Это показывает что можно делать специализированные ИИ модельки (не общего назначения) для МК. Например, самые простые ИИ системы распознавания речи требуют всего-лишь 30 миллионов параметров. В принципе, наверное, можно попробовать сделать очень чистый датасет и уложиться в этот МК ну или взять чуток жирнее и шустрее, чтоб говорить умному дому включить/выключить прибор, настроить кондиционер и так далее. Т.е. никаких алис, марусь, катрусь и прочих сири не нужно, кроме как для слежки. В принципе у мобилки мощностей должно как раз хватать.

peregrine ★★★★★
()
Последнее исправление: peregrine (всего исправлений: 3)
Ответ на: комментарий от peregrine

Вроде яндыкс умудрился впихнуть распознавание базовых голосовых команд в свои капельки, вот последние

unclestephen ★★★★★
() автор топика
Ответ на: комментарий от REDDERa

Короче опять just for fun, и никакой пользы, кроме как «а мы могем»)

Так вся наука работает. Кто-то показывает, что можно вот так делать. А кто-то другой берет это и использует на практике. Что за потребительское отношение? Возьми да подумай, какие сценарии использование даёт микроконтроллер с работающей нейронкой.

autonomous ★★★★★
()
Последнее исправление: autonomous (всего исправлений: 1)
Ответ на: комментарий от etwrq

В еспшке ESP32S3 не можеь быть много памяти замапплено. Нет, конечно, мы можем карточку подмаунтить SD. Как диск. Но отобразиь - нет. Автор использует именно фишку с отображением. MMU у ESP32S3 довольно примитивный и у него ограниченное количество записей. Замаппить можно максимум 32 мегабайта: 8 мегабайт SPIRAM, 16 мегабайт - флешка и еще остается 8 мегабайт под всякое: загрузчик маппит области флешки , чтобы исполнять оттуда (XIP). ОЗУ реального там совсем мало - 512кб. Но исполнение все равно идет с флешки, через mmap(). ОЗУ маленькое но очень шустрое - это, по сути, L2 cache. (А может и L1. Т.к. 32кб этой памяти используются процессором как кэш).

vvb333007
()
Последнее исправление: vvb333007 (всего исправлений: 1)
Ответ на: комментарий от unclestephen

Голосовые команды на несколько фраз в ЕСПшку уже давно впихнули. Название репы не помню. Что-то там TinyML или около того. Для всяких там «Ок, Гугл, привет Алиса, Активировать детон^H^H^H^H режим сна»

Голосовые команды попроще реализуются, чем генераторы рассказов. Я как-то разговаривал с одним практикующим нейропрограммистом, спрашивал про размер данных, чтобы сетка распознавала одну короткую фразу. Я забыл размер, но там меньше одного мегабайта.

vvb333007
()
Последнее исправление: vvb333007 (всего исправлений: 1)
Ответ на: комментарий от vvb333007

я где-то слышал про softMMU патчи, то ли для ядра то ли для glibc/musl(userspace).
есть подозрение что условно до гига оно приемлимо, т.к. больше - больше lookup latency, ниже производительность, etc.

etwrq ★★★★★
()
Ответ на: комментарий от peregrine

Облака, но именно речь о базовых командах, мне так попадалось

unclestephen ★★★★★
() автор топика
Ответ на: комментарий от daniyal

А оно умеет говорить анекдоты про штирлица?

Умеет. Но не хочет. ;P ;)))

Somebody ★★★★
()
Для того чтобы оставить комментарий войдите или зарегистрируйтесь.