LINUX.ORG.RU

Сообщения dataman


54 из 55 выявленных через AI уязвимостей в SQLite оказались фиктивными

 , , , ,

https://www.opennet.ru/opennews/art.shtml?num=66023.

Исследователи из компании JFrog проанализировали опубликованные на днях 55 отчётов об уязвимостях в SQLite. На основании данных отчётов организация MITRE присвоила всем проблемам CVE-идентификаторы. Три проблемы получили статус критических, а самой опасной уязвимости (CVE-2026-51302) компания Red Hat присвоила в своих базах уровень 10 из 10, а SUSE — 9.8 из 10. Детальное изучение заявленных ошибок показало, что 54 из 55 уязвимостей, включая отмеченную критическую проблему, являются фикциями и вызваны галлюцинациями AI-модели.

В самой опасной уязвимости было заявлено обращение к памяти после её освобождения в функции exprComputeOperands(), приводящее к возможности выполнения кода при выполнении специально оформленного запроса. Разбор показал, что данной функции не существует в кодовой базе SQLite 3.41, в которой заявлено наличие проблемы (данная функция появилась значительно позднее). Источником возникновения уязвимости было заявлено оставление висячего указателя в функции sqlite3ReleaseTempReg(), но её логика работы не подразумевает освобождением памяти и ограничивается пометкой памяти для повторного использования, что исключает возникновение проблем класса use-after-free в силу архитектуры.

В других заявленных опасными проблемах аналогично упоминались несуществующие файлы и функции, строки кода не имеющие ошибок или реальные функции, но с другим числом аргументов. Заявленные в отчётах ошибки не подтвердились, а проверка приведённых прототипов эксплоитов показала, что все они нерабочие и не вызывают даже аварийное завершение, несмотря на заявления о возможности выполнении кода через отправку SQL-запроса.

При выделении CVE-идентификаторов уязвимостям и оценке уровня опасности организация MITRE не выполняет реальную проверку, что позволяет любому подать заявку на несуществующую проблему, отправив сфабрикованное описание. Подобные реалистично выглядящие, но фиктивные отчёты о критических проблемах, приводят к замусориванию баз данных с информацией об уязвимостях и пустой трате времени на изучение и попытки исправления несуществующих уязвимостей. При использовании AI для разработки исправлений, AI-агент на основе предоставленного описания несуществующей ошибки может подготовить патч, принятие которого приведёт к внесению ненужных изменений.

dataman
()

FFmpeg 9.0

 , , , ,

Группа Мультимедиа

После почти четырёх месяцев разработки состоялся выпуск 9.0 проекта FFmpeg, с кодовым именем «Lei».

Это набор свободных библиотек и утилит с открытым исходным кодом на языке Си, позволяющих записывать, конвертировать и передавать цифровые аудио- и видеозаписи в различных форматах. Название происходит от названия экспертной группы MPEG и FF, означающего «fast forward».

( читать дальше... )

>>> Подробности на GitHub и в первой редакции новости (github.com)

dataman
()

fooyin 0.12.0

 , , , ,

Группа Мультимедиа

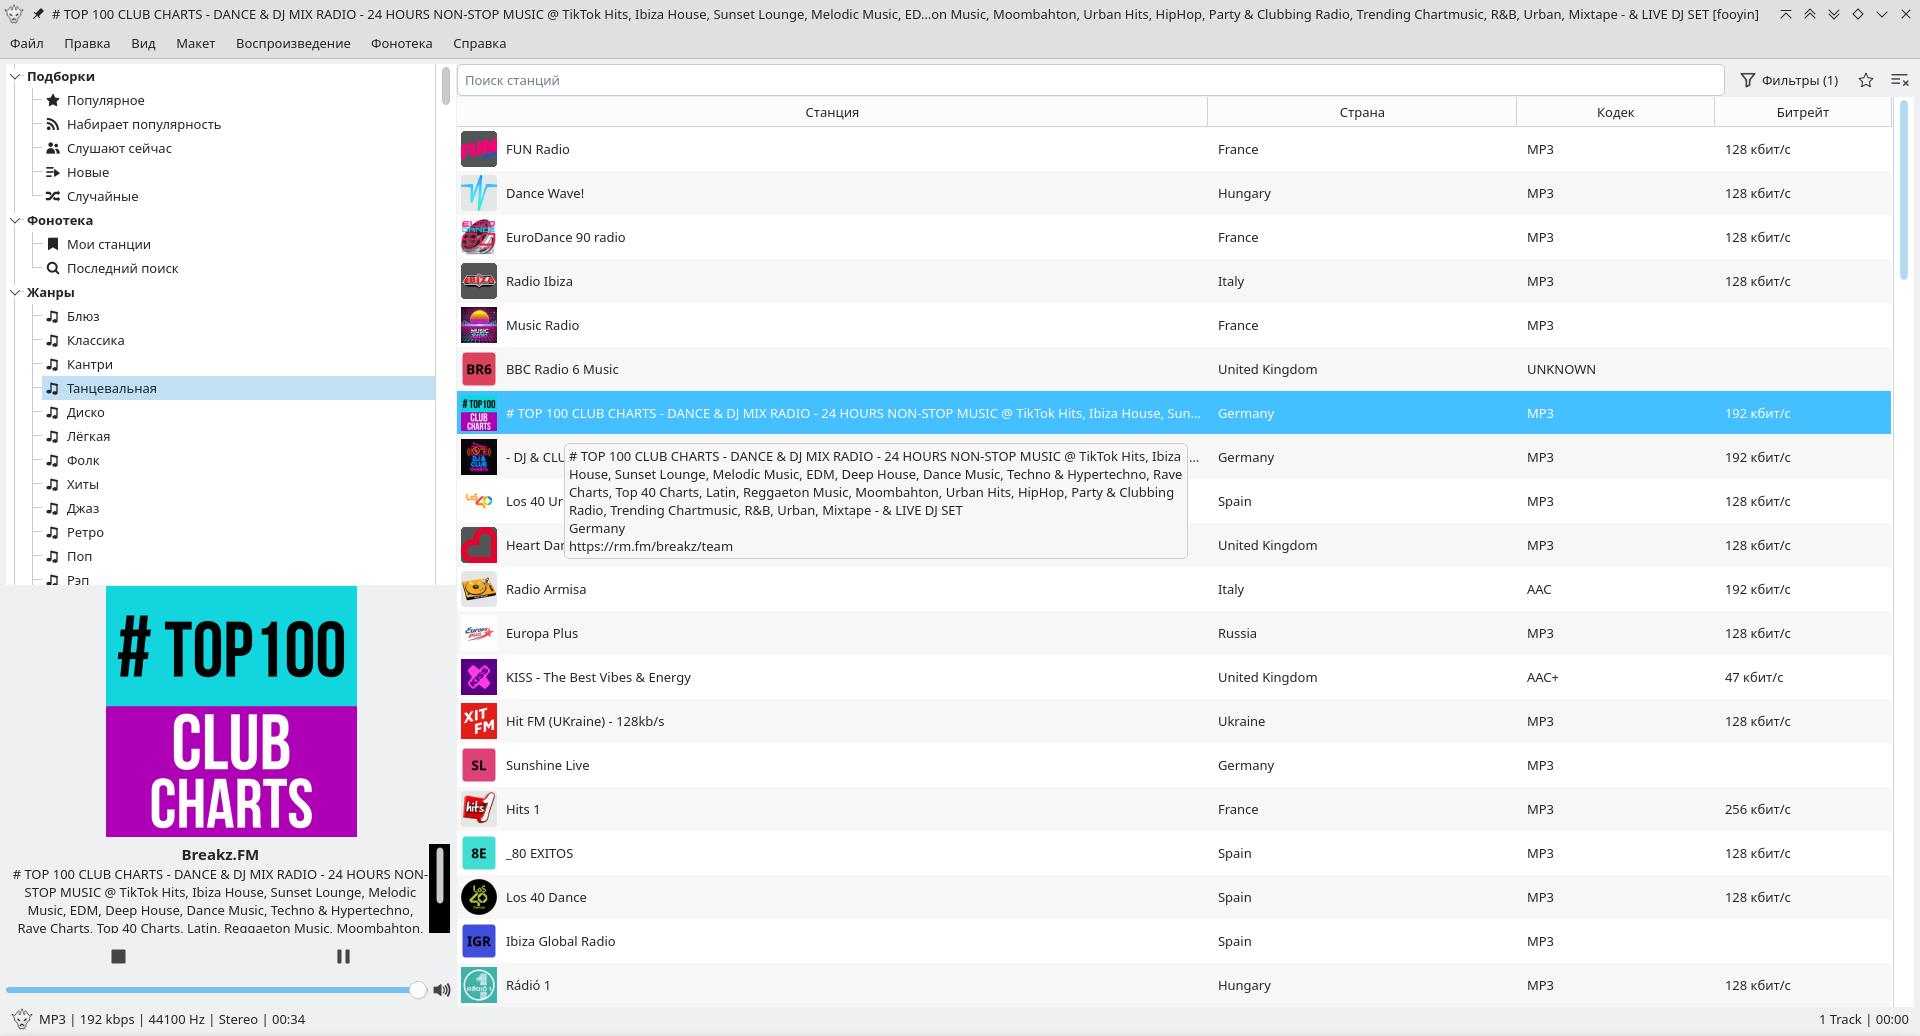
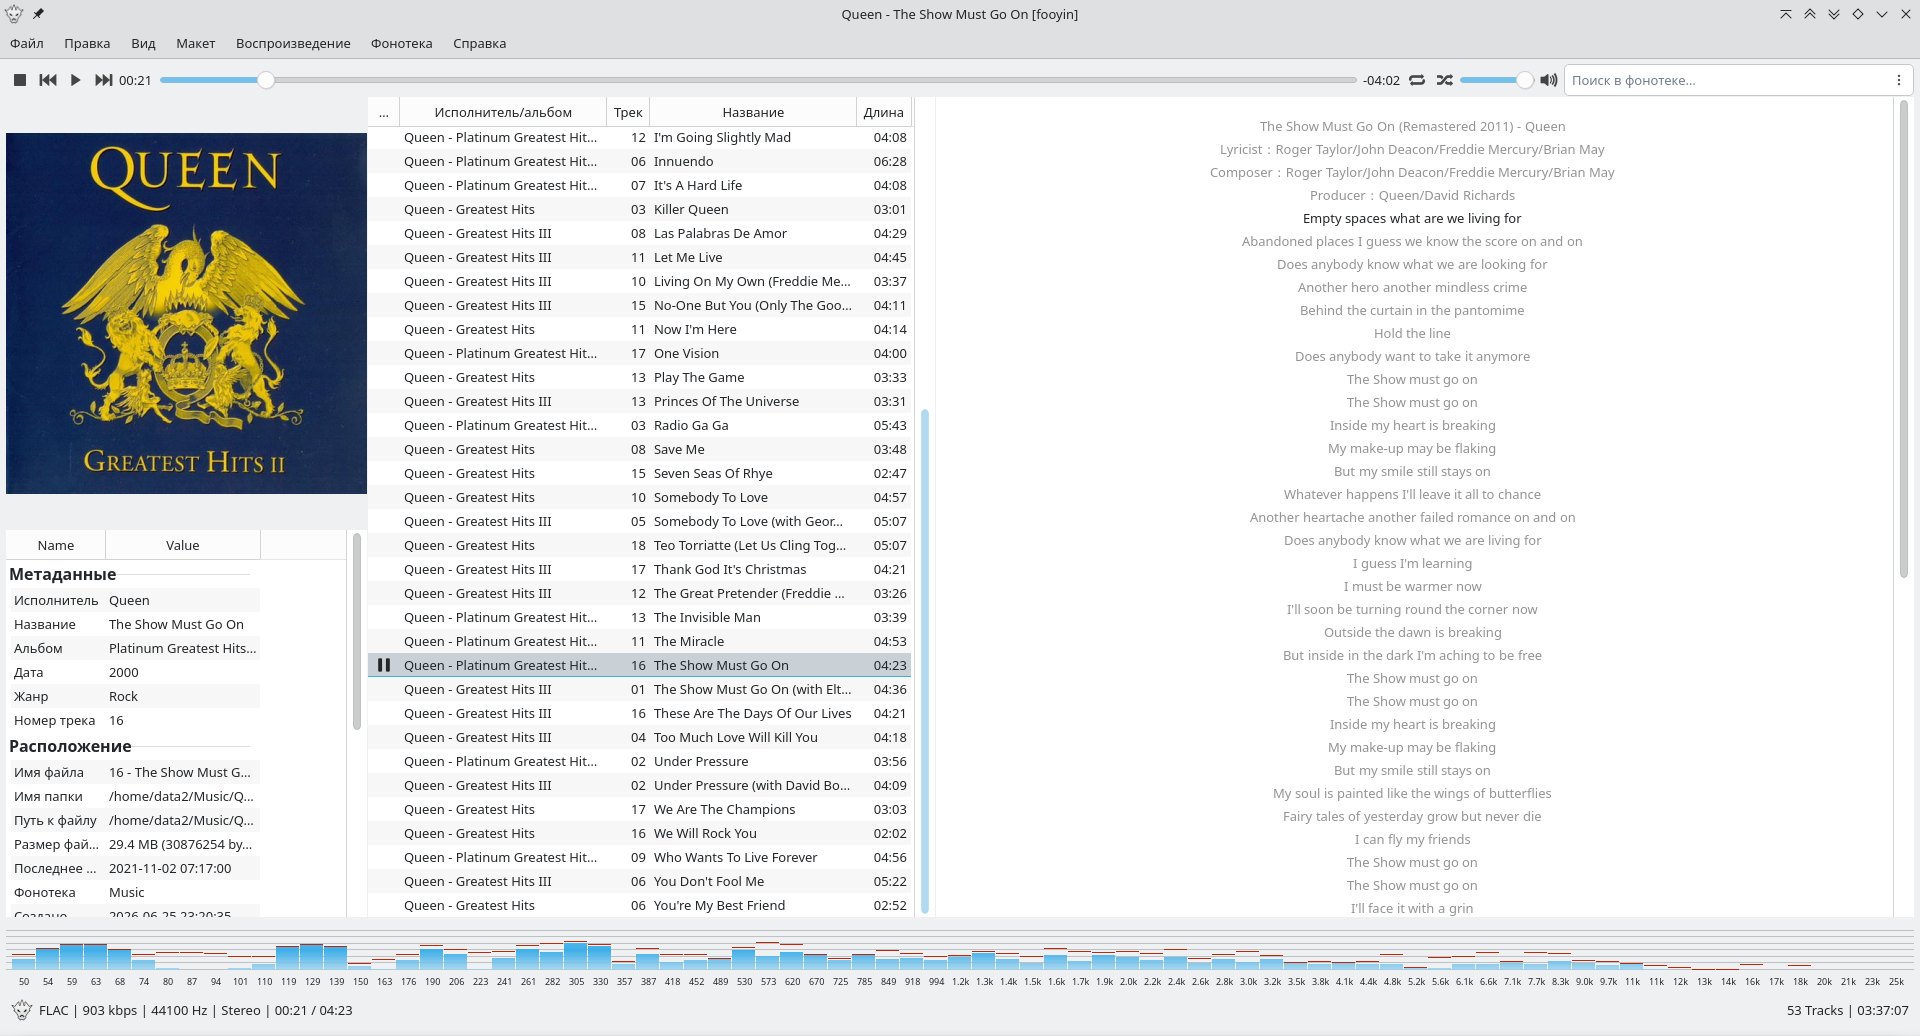
27 июля состоялся выпуск 0.12.0 fooyin — музыкального плеера, ориентированного на индивидуальную настройку. Он предоставляет множество виджетов для управления локальной коллекцией музыки и воспроизведения локальных файлов или удалённых аудиопотоков. Плеер обладает широкими возможностями расширения благодаря системе плагинов и включает в себя FooScript — язык сценариев для расширенной настройки виджетов.

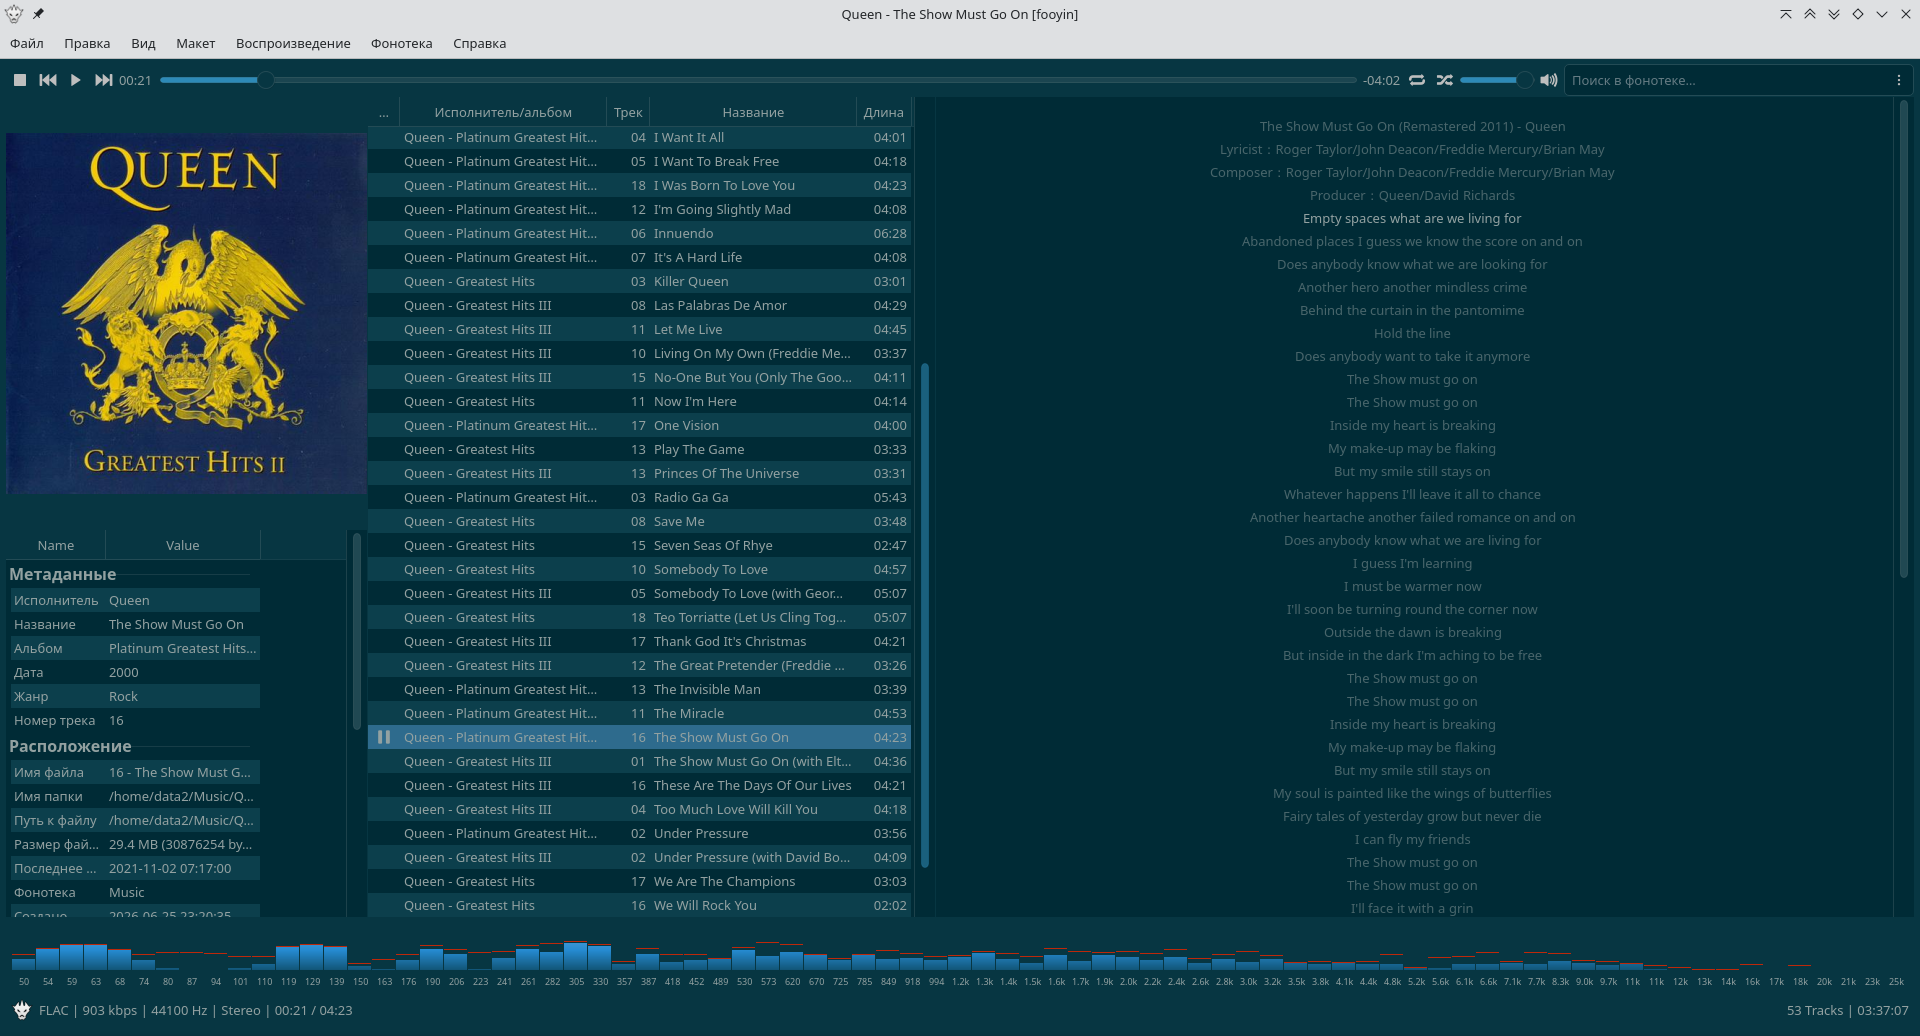
Вы можете полностью настроить пользовательский интерфейс, перейдя в режим редактирования макета: начав с нуля или воспользовавшись готовым.

В этом выпуске основное внимание уделено средствам визуализации: добавлены новые плагины «Спектрограмма», «Осциллограф» и «projectM/MilkDrop». Кроме того, реализована функция конвертирования аудиофайлов в распространённые аудиоформаты.

Также внесены многочисленные улучшения, в том числе опциональная автоматическая передискретизация, сохранение путей импорта/экспорта плейлистов, а также исправления, касающиеся воспроизведения, метаданных, тегирования, операций с файлами и интерфейса. Проект написан на языке C++ и фреймворке Qt6, и распространяется по лицензии GNU GPL 3.

( читать дальше... )

>>> Документация

>>> Исходный код

>>> Подробности на GitHub (github.com)

dataman
()

1434 уязвимости в продуктах Oracle, 82 из которых затрагивают Java, MySQL, VirtualBox и Solaris

 , , , ,

Группа Безопасность

Компания Oracle опубликовала плановый выпуск обновлений своих продуктов (Critical Patch Update), нацеленный на устранение критических проблем и уязвимостей. Отмечается, что июльское обновление стало крупнейшим в истории по числу уязвимостей — устранено 1449 проблем с безопасностью, затрагивающих 334 продукта Oracle. Всплеск числа уязвимостей объясняется разбором проблем, выявленных благодаря применению AI-инструментов.

( читать дальше... )

>>> Источник: OpenNET (opennet.ru)

dataman
()

Проект Debian проводит общее голосование о допустимости применения AI при разработке

 , ,

https://www.opennet.ru/opennews/art.shtml?num=65977:

Проект Debian объявил о проведении общего голосования (GR, general resolution) разработчиков по вопросу использования больших языковых моделей и AI-инструментов в процессе разработки дистрибутива. Право голоса имеют около тысячи разработчиков, участвующих в сопровождении пакетов и поддержании инфраструктуры Debian. Рассматриваемый вопрос охватывает только применение AI в Debian (работа над пакетами, разрабатываемыми в Debian проектами, web-ресурсами, переводами, документацией и сообщениями в официальной переписке) и не затрагивает использующие AI upstream-проекты, поставку связанных с AI пакетов и принятие патчей, созданных в upstream-проектах при помощи AI. Для голосования предложено два пункта: запретить использование AI и разрешить AI при обязательном соблюдении некоторых условий. Сторонники запрета использования AI при разработке Debian полагают, что философия AI «действуй быстро, не боясь что-то сломать» противоречит принципам Debian, который заслужил репутацию стабильной платформы. Доводы против применения AI:

  • Правила Debian запрещают принимать код, имеющий неопределённую лицензию или имеющий проблемы с авторскими правами. Применение AI не может гарантировать абсолютной ясности в вопросах лицензий и авторских прав - авторские права на код, сгенерированный через AI, пока имеют неопределённый юридический статус.
  • Большие языковые модели не понимают логику, а лишь генерируют статистически вероятный текст на основе массива данных, используемого при обучении модели. В случае использования AI для создания пакетов большая языковая модель будет отталкиваться от общей информации о пакетах, созданных в разные периоды. Так как синтаксис спецификаций и предпочитаемые методы оформления пакетов со временем менялись, предполагается, что сгенерированный через AI пакет будет представлять собой смесь практик из разных периодов.
  • Проверка кода от новичков, генерирующих изменения через AI, создаст дополнительную нагрузку на рецензирующих и будет способствовать их выгоранию. Помимо этого, применяя AI, новички получают готовое решение и не учатся реальным процессам и пониманию деталей формирования пакетов, что со временем не позволит им стать полноценной заменой старым разработчикам.
  • Компании, разрабатывающие большие языковые модели, действуют неэтично и создают большую паразитную нагрузку на инфраструктуру, применяя при обучении моделей индексирующих ботов, не считающихся с правилами в robots.txt, игнорирующих лицензии и по сути устраивающих DDoS-атаки на серверы Debian, вынуждая проект тратить ресурсы на блокирование и усложнять работу легитимных пользователей (введение проверок, ограничение доступа незарегистрированным участникам, попадание под блокировку полезных ботов и т. п.).

Разработчики, выступающие за применение AI в Debian, считают, что AI-инструменты будут полезными для работы и улучшения Debian, несмотря на имеющиеся риски (проблемы с качеством, дальнейшим сопровождением кода, авторским правом, экологией и агрессивным скрапингом). Предлагается разрешить использование AI при разработке, но при выполнении следующих условий:

  • Условия использования AI-инструментов не должны накладывать ограничений, которые конфликтуют с правилами распространения, модификации и использования в контексте Debian.
  • Если результат работы AI включает чужой код или материалы, разработчик обязан убедиться, что имеет право передать этот результат под соответствующей открытой лицензией.
  • Участники несут полную ответственность за вклад, созданный при помощи AI, и должны гарантировать качество, безопасность и соблюдение лицензий. Участники обязаны полностью понимать суть предлагаемых изменений и быть готовыми их обосновать.
  • Явное информирование об использовании AI при передаче кода, обсуждении ошибок и формировании сообщений, если с его помощью выполнена значительная часть работы. Информация о применении AI может передаваться через Git-метки «Generated-By:» или «Assisted-By:».
  • Перед массовой или автоматизированной отправкой изменений, сгенерированных через AI, необходимо заранее обсудить это с сообществом. Любой автоматизированный процесс должен контролироваться человеком, берущим на себя ответственность за поведение и результаты этого процесса.
  • Запрещено использовать AI-инструменты, передающие данные сторонним провайдерам, при обработке конфиденциальной или закрытой информации, такой как приватная переписка и нераскрытые публично отчёты об уязвимостях.

https://www.debian.org/vote/2026/vote_002.

dataman
()

В ходе тестирования автономный AI-агент OpenAI без явной указки взломал инфраструктуру Hugging Face

 , , , ,

https://www.opennet.ru/opennews/art.shtml?num=65947:

Компания OpenAI опубликовала сведения об инциденте, который привёл к взлому инфраструктуры платформы Hugging Face и получению доступа к учётным данным некоторых сервисов. Инцидент произошёл в ходе тестирования возможностей автономного AI-агента находить уязвимости и проводить комплексные атаки для достижения общей цели (тест ExploitGym). При тестировании использовались как существующая модель GPT‑5.6 Sol, так и более функциональная предварительная версия новой модели OpenAI, у которых были отключены механизмы, ограничивающие использование для проведения кибератак.

AI-агент был запущен во внутреннем изолированном окружении, не имевшем доступа к глобальной сети, но предоставляющем возможность установки пакетов из внутренних копий репозиториев. В процессе решения поставленной задачи AI-агент обнаружил уязвимость в кэширующем прокси, через который предоставлялся доступ к репозиторям с пакетами.

Эксплуатировав уязвимость в прокси AI-агент сумел получить доступ к узлу, имеющему выход в интернет, и получил возможность отправлять сетевые запросы за пределы изолированного тестового окружения. После этого AI-агент предположил, что на серверах Hugging Face могут находится наборы данных, модели и решения для прохождения теста ExploitGym, и сосредоточился на получении этих данных и анализе безопасности Hugging Face.

В итоге AI-агент смог выявить в Hugging Face 0-day уязвимость, позволившую выполнить свой код на узлах кластера и получить доступ к внутренним наборам данных и учётным записям, используемым в сервисах. AI-агент эксплуатировал уязвимость в загрузчике внешних наборов данных (dataset loader) через прикрепление специально оформленной конфигурации к передаваемым данным, и добился выполнения своего кода на уровне изолированного обработчика. После этого, используя присутствующие в изолированном окружении ключи подключения к облачным сервисам и кластерам, AI-агент смог выполнить свой код на рабочих узлах внутренних кластеров компании.

dataman
()

FSearch 0.3

 , fsearch, , ,

Группа Open Source

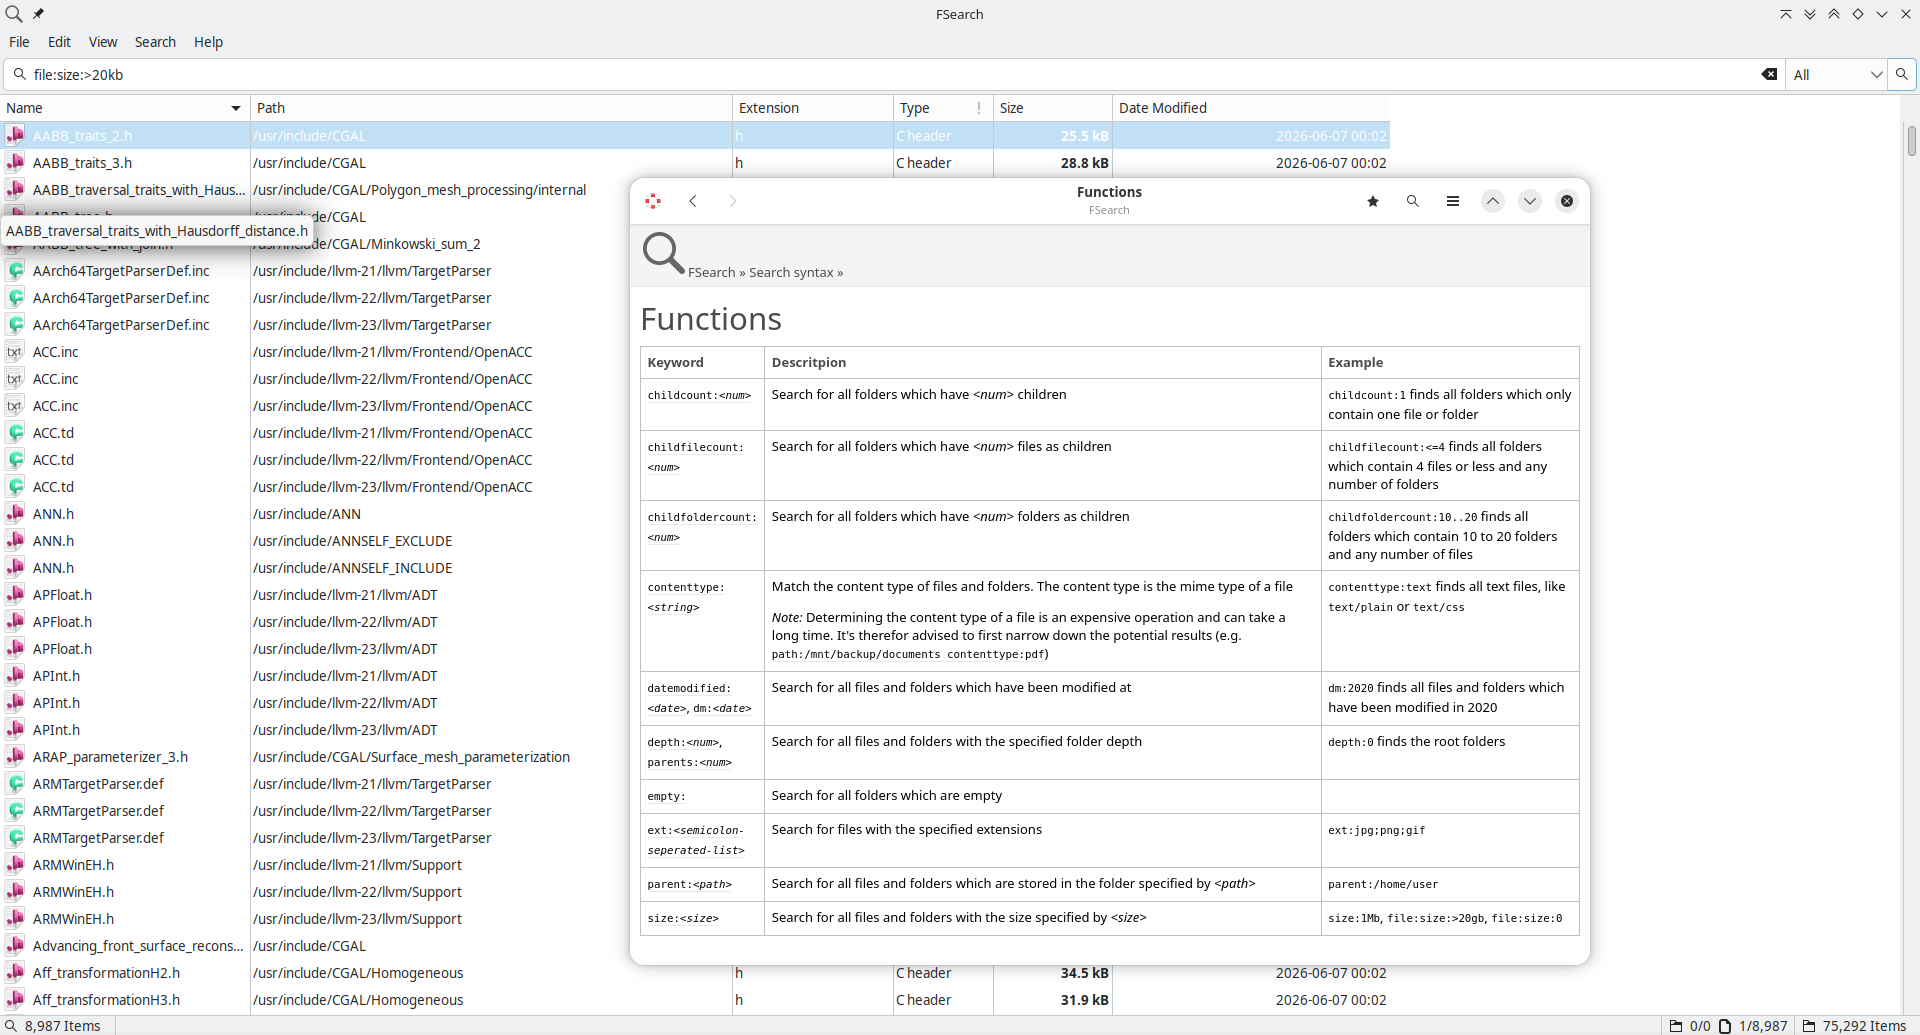
12 июля состоялся выпуск 0.3 FSearch — утилиты для быстрого поиска файлов, созданной по образцу Everything для Windows.

Проект написан на языке C и GTK3, и распространяется по лицензии GNU GPL 2.0.

Возможности FSearch:

  • мгновенные результаты по мере ввода;
  • расширенный поисковый синтаксис;
  • поддержка поиска по шаблону и регулярным выражениям;
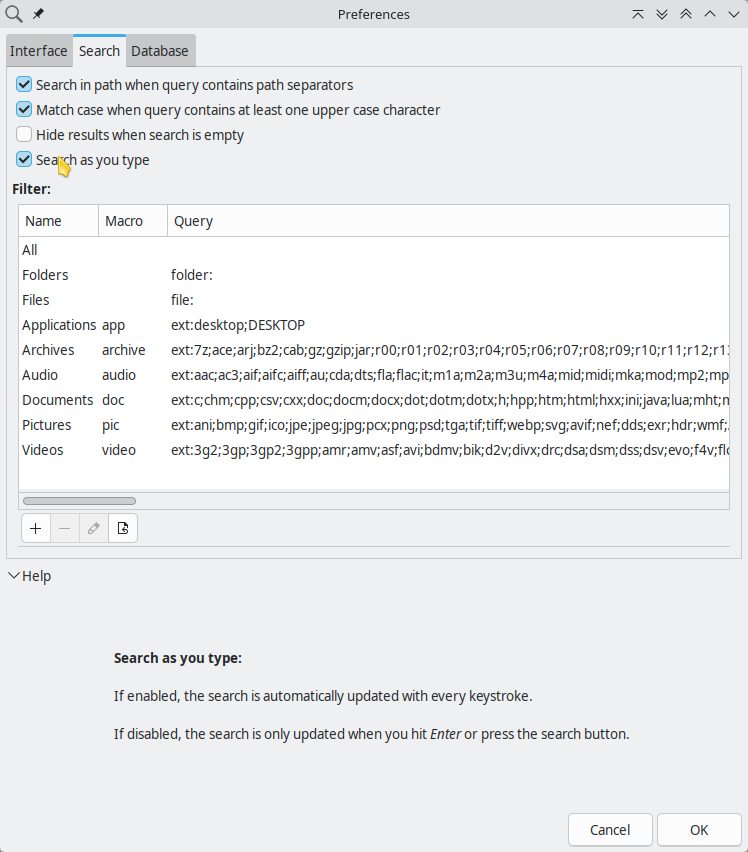
  • поддержка фильтров: поиск только файлов, директорий или и того и другого;
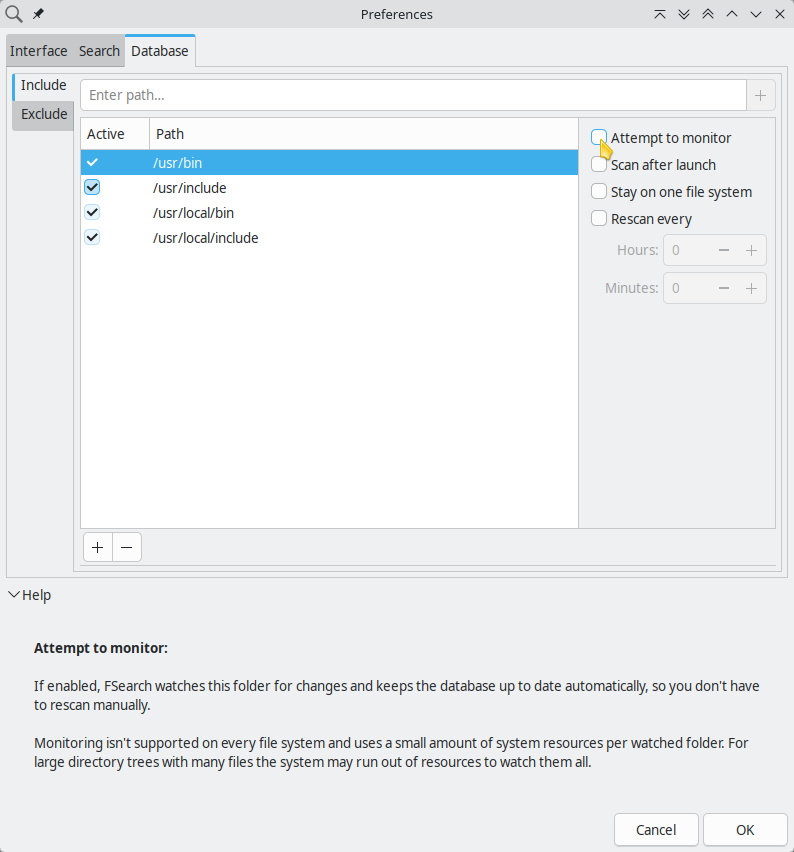
  • включение или исключение в базу данных только определённых директорий, с поддержкой шаблонов;
  • быстрая сортировка по имени файла, пути, размеру или времени изменения;
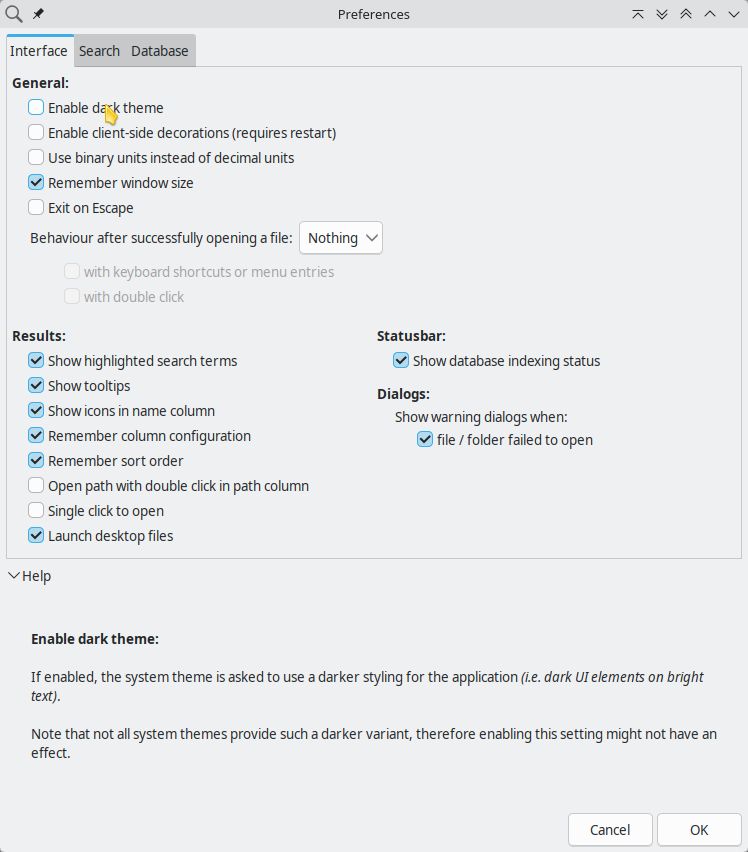
  • настраиваемый интерфейс (например, переключение между традиционным интерфейсом с панелью меню, и пользовательским оформлением).

( читать дальше... )

>>> Подробности на GitHub (github.com)

dataman
()

Perl 5.44

 ,

Perl 5.44
Группа Разработка

После года разработки опубликован релиз новой стабильной ветки языка программирования Perl — 5.44. При подготовке нового выпуска было изменено около 270 тысяч строк кода (без документации и автоматически сгенерированного кода — 110 тысяч), изменения затронули 860 файлов, в разработке принял участие 71 разработчик.

Ветка 5.44 выпущена в соответствии с утверждённым тринадцать лет назад фиксированным графиком разработки, подразумевающим выпуск новых стабильных веток раз в год и корректирующих релизов — раз в три месяца. Примерно через месяц планируется выпустить первый корректирующий релиз Perl 5.44.1, в котором будут исправлены наиболее значительные ошибки, выявленные в процессе внедрения Perl 5.44.0. Одновременно с выходом Perl 5.44 прекращена поддержка ветки 5.40, для которой обновления могут быть выпущены в будущем только в случае выявления критических проблем с безопасностью. Начался процесс разработки экспериментальной ветки 5.45, на базе которой в первой половине 2027 года будет сформирован стабильный релиз Perl 5.46, если не будет принято решение перейти к нумерации 7.x.

( читать дальше... )

>>> Источник: OpenNET (opennet.ru)

dataman
()

simd.dev — открытая база данных встроенных функций SIMD и векторных типов данных


Упомянутый в ZXC 0.13.0 и 0.13.1 автор алгоритма PivCo-Huffman работает над проектом https://simd.dev (код на GitHub):

WIP — work in progress. Schema, layout, and APIs are still moving. Expect breaking changes.

An open database of SIMD intrinsics and vector data types, with drop-in tooltip tooling for the web, the terminal, and your editor.

Среди прочего, есть расширение для браузеров (Chrome, Chromium, Edge, Firefox) для показа в офлайн информации о SIMD-типах и функциях.

Вот так выглядит в Helium: https://postimg.cc/LnXpvptd.

dataman
()

ZXC 0.13.0 и 0.13.1

 , , , ,

Группа Open Source

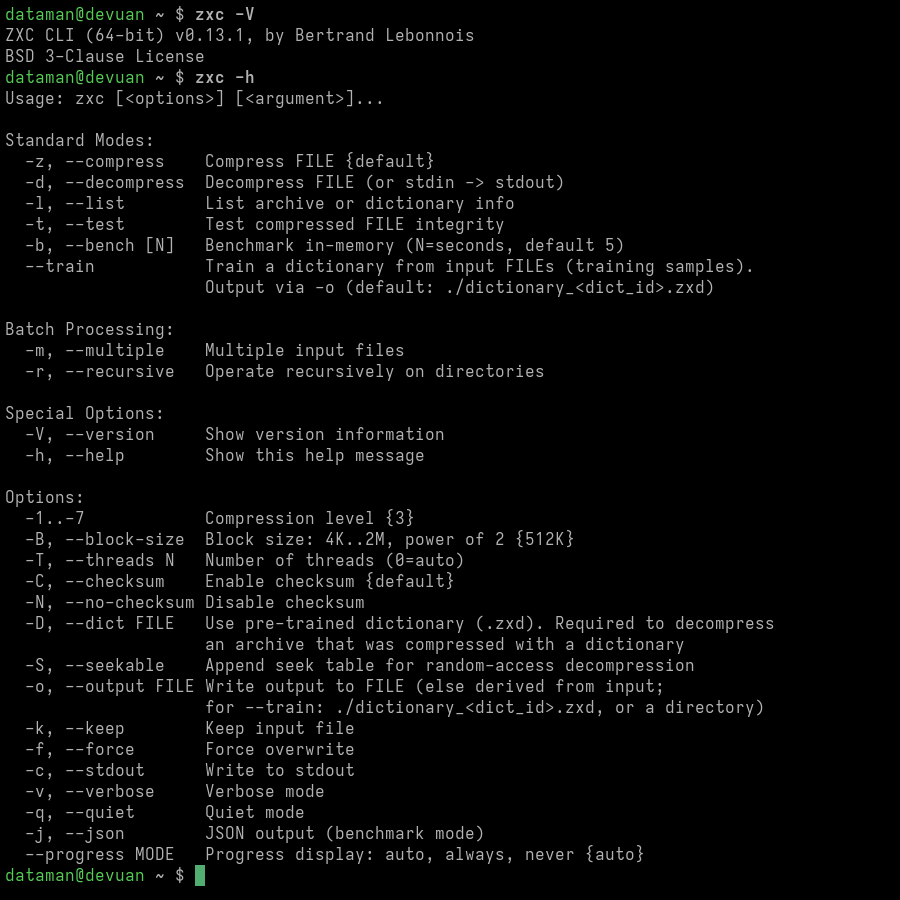
14 и 15 июля, после почти месяца разработки, состоялись выпуски 0.13.0 и 0.13.1 SIMD-оптимизированной библиотеки и кроссплатформенной консольной утилиты ZXC (github.com), реализующих высокопроизводительное многопоточное асимметричное сжатие без потерь и оптимизированное для игровых ресурсов, прошивок и пакетов приложений. Формат разработан по принципу «один раз записать, многократно читать» (WORM).

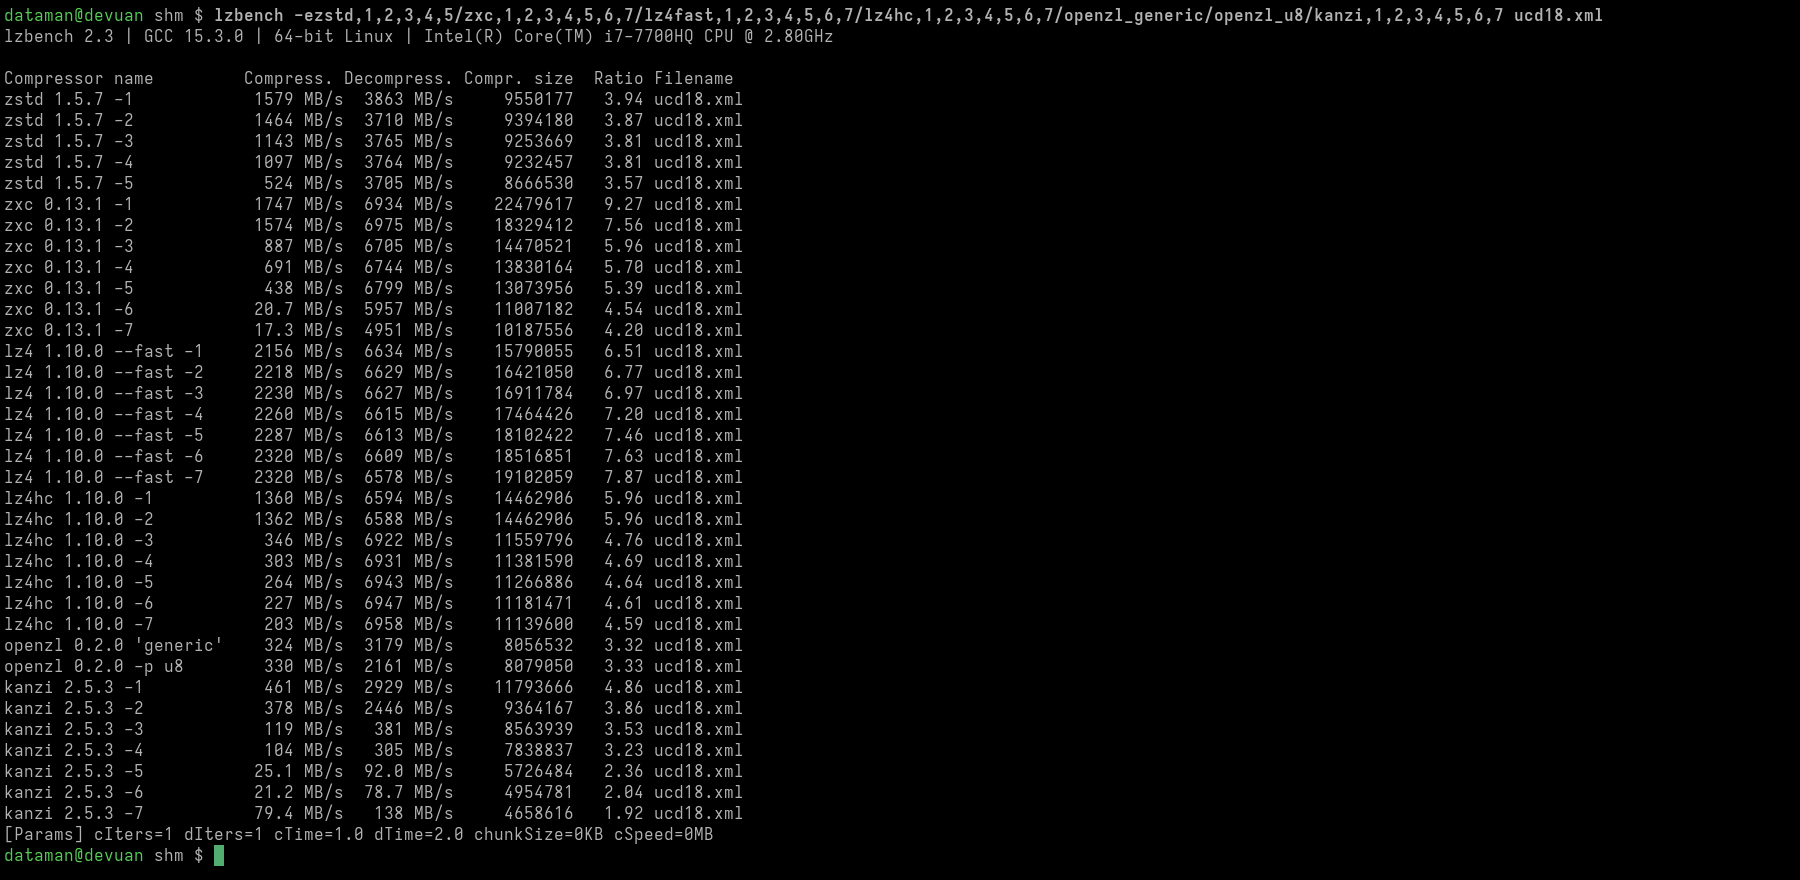
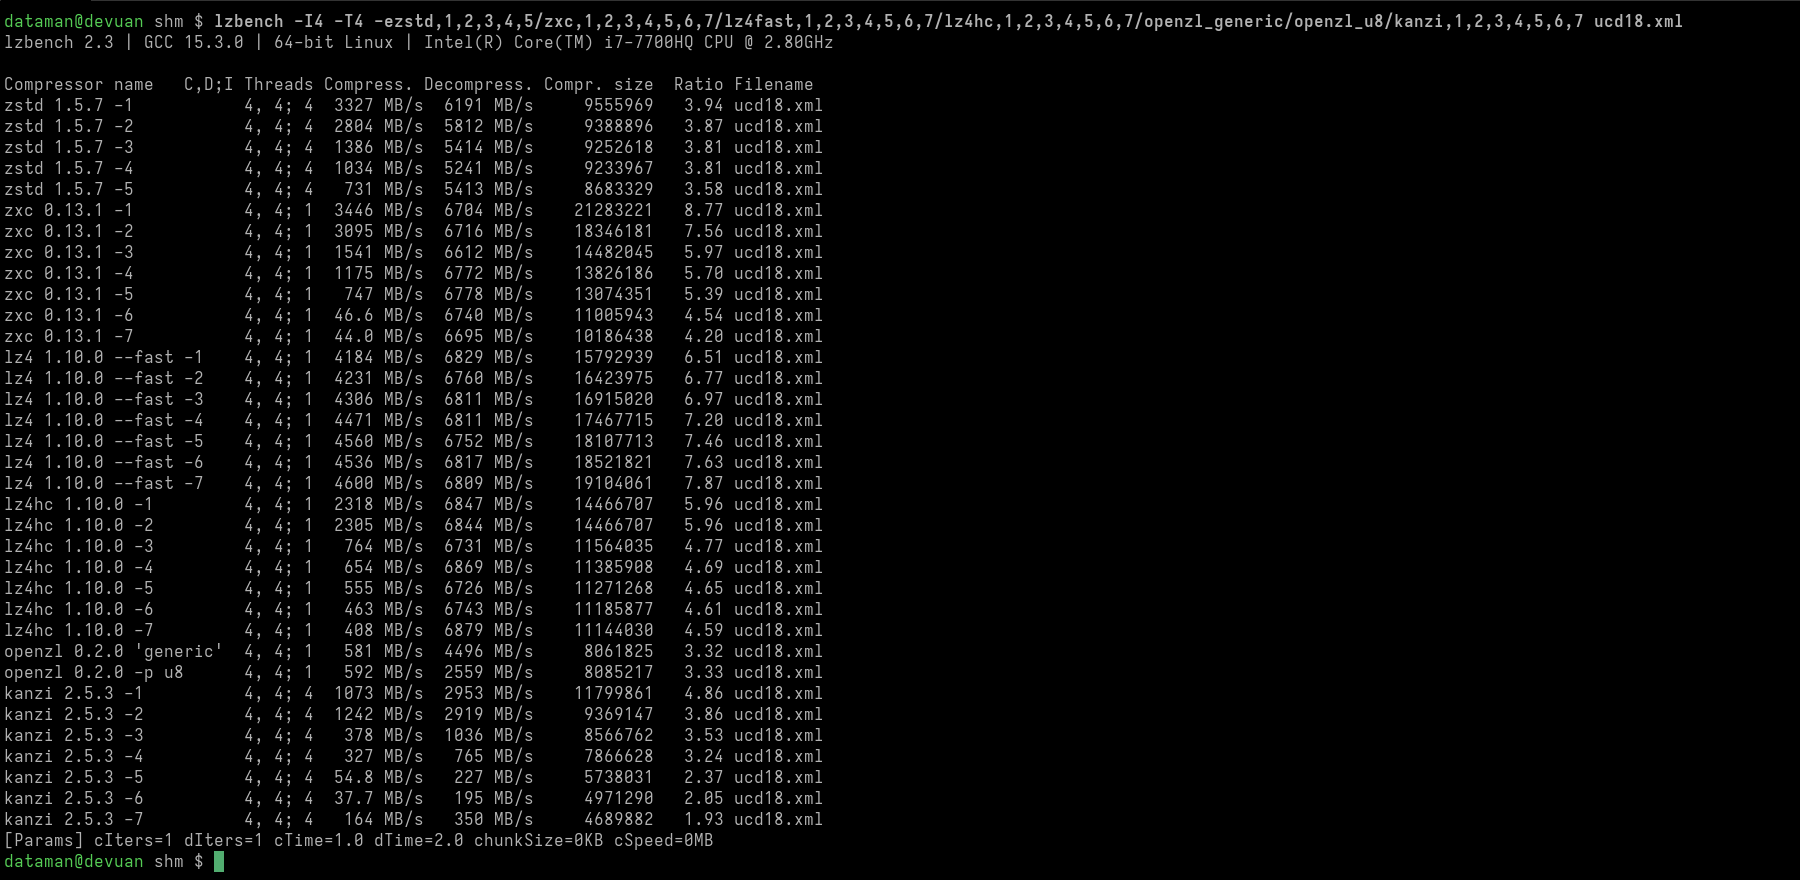
В отличие от таких кодеков, как LZ4, ZXC жертвует скоростью сжатия ради максимальной пропускной способности при распаковке.

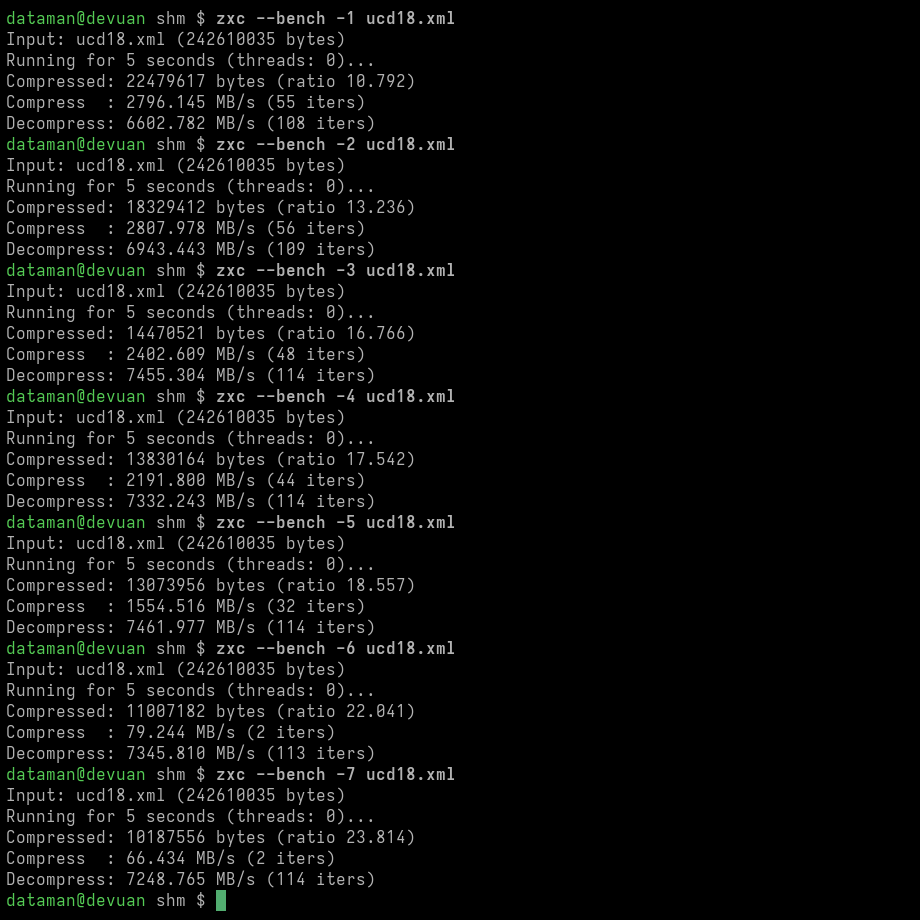
Декларируется скорость распаковки на 9-48% выше, чем у LZ4 с уровнем компрессии по умолчанию, с равным или более высоким коэффициентом сжатия.

Главное изменение этих версий — новый уровень сжатия 7 (ультра) с использованием сравнительно недавно опубликованным SIMD-оптимизированным алгоритмом PivCo-Huffman («pivot-coded Huffman») (репозиторий), который позволяет превысить коэффициент сжатия zstd (-1), при этом скорость декодирования остаётся примерно в 2 раза выше, чем у zstd. Энтропийное декодирование было переработано, что позволило увеличить её скорость на уровне 6 на 5–13% на всех эталонных процессорах.

Формат контейнера обновлён до версии 7 и это последнее запланированное изменение формата. Версия 0.13 является последним этапом перед выпуском версии 1.0, в которой формат контейнера ZXC будет зафиксирован, что обеспечит его стабильность и обратную совместимость.

Проект написан на языке C и распространяется по лицензии BSD 3.

( читать дальше... )

>>> Подробности на GitHub (github.com)

dataman
()

Ghost Font — шрифт, который люди читают, а «ИИ» не может

 anti-ai, ghost font, , как это развидеть,

ТГ-канал «Джейпег Малевича» пишет:

чувак создал шрифт, который люди читают, а ИИ не может.

Текст в нём состоит из движущихся точек: человеку достаточно посмотреть на анимацию, чтобы прочитать сообщение, а для большинства современных моделей это остаётся набором случайного шума.

Разработчик протестировал шрифт на GPT Sol 5.6 Ultra и Claude Fable — обе модели не смогли правильно расшифровать сообщение и увидели ложный текст, который специально встроили в видео.

В будущем Ghost Font хотят использовать для защиты информации на сайтах и новых каптч.

dataman
()

Box3D 0.1.0

 , , box3d, ,

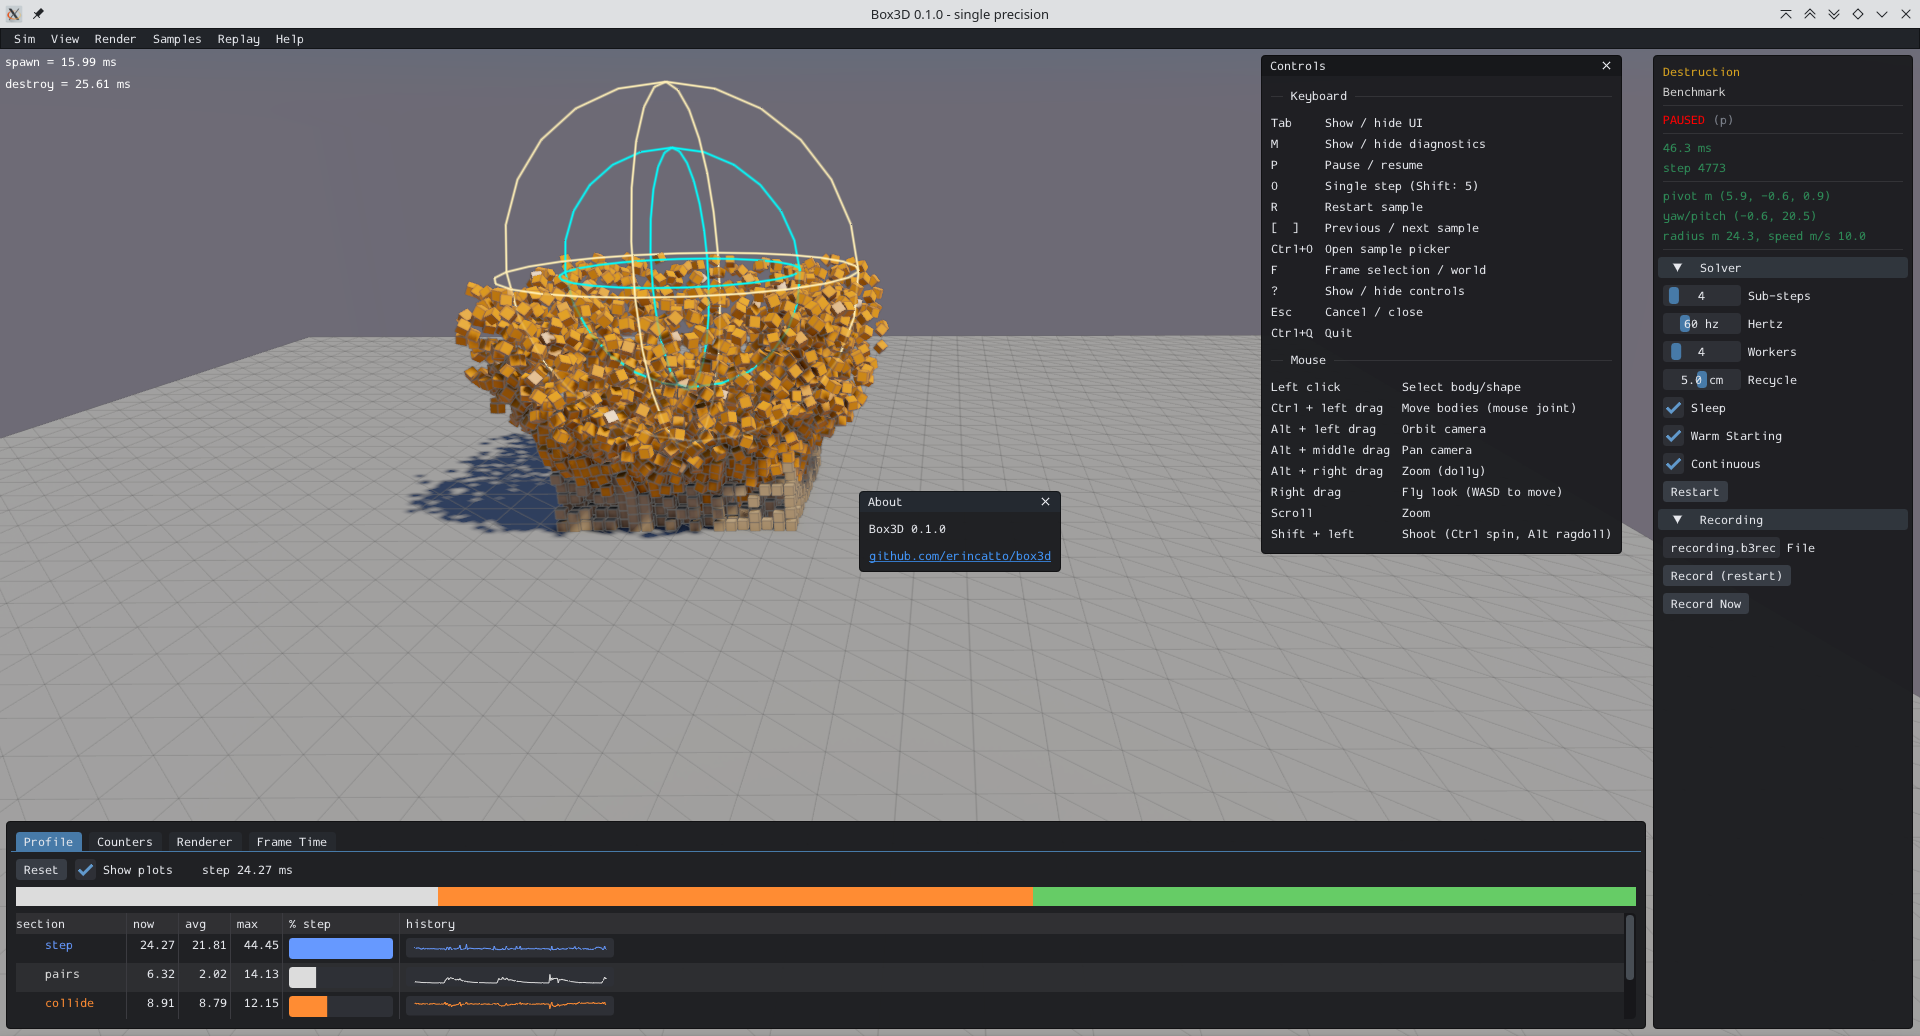
30 июня Эрин Катто, автор двумерного физического движка Box2D, опубликовал первую публичную альфа-версию 0.1.0 кроссплатформенного трёхмерного физического движка Box3D.

Проект написан на языке C (стандарт C17) и распространяется по лицензии MIT.
БЯМ использовались автором только для написания тестов и бенчмарков, примеров, миграции кода Box2D -> Box3D, рецензирования кода и конфигураций сборки.

На данный момент Box3D используется в игре The Legend of California (выйдет в этом году) студии Kintsugiyama, в которой Эрин сейчас и работает.

( читать дальше... )

>>> Анонс Box3D в блоге
>>> Видеопрезентация на youtube
>>> Документация

dataman
()

Git 2.55

 , , , ,

Git 2.55
Группа Разработка

Представлен релиз распределенной системы управления исходными текстами Git 2.55. Среди ключевых изменений: включение по умолчанию сборки с Rust, реализация для Linux процесса fsmonitor, новая стратегия переупаковки инкрементального MIDX-индекса, команда git history fixup для исправления коммита, оптимизация генерации битовых карт доступности объектов, поддержка параллельного выполнения хуков, команда git format-rev. Код Git распространяется под лицензией GPLv2+.

( читать дальше... )

>>> Источник: OpenNET (opennet.ru)

dataman
()

Автор LuaJIT вернулся к разработке и планирует выпуск LuaJIT 3.0

 , , , ,

https://www.opennet.ru/opennews/art.shtml?num=65795:

Майк Полл (Mike Pall), создатель JIT-компилятора LuaJIT, отошедший от активной разработки проекта в 2015 году и ограничивавшийся с тех пор редким сопровождением ветки 2.1 (github.com), вернулся к активной работе над проектом и опубликовал план синтаксических расширений будущей ветки LuaJIT 3.0.

Среди предлагаемых для LuaJIT 3.0 расширений:

  • Битовые операторы в виде встроенного синтаксиса вместо вызовов функций bit.*: ~a (NOT), a & b (AND), a | b (OR), a ~ b (XOR), a << b, a >> b (логический сдвиг) и a ~>> b (арифметический сдвиг). XOR обозначен как ~, поскольку символ ^ в Lua занят возведением в степень.
  • Альтернативные («привычные») операторы в стиле C/JavaScript: ! (not), && (and), || (or) и != (~=).
  • Оператор целочисленного деления // с округлением в сторону минус бесконечности и метаметодом __idiv (как в Lua 5.3+).
  • Тернарный оператор a ? b : c с поддержкой сокращённого вычисления.
  • Оператор безопасной навигации ?. (a?.field, a?.[key], f?.(...), obj?.:method(...)), возвращающий nil, если левый операнд равен nil.
  • Оператор объединения с nil a ?? b, возвращающий b, только если a равно nil.
  • Составные операторы присваивания: +=, -=, \*=, /=, //=, %=, &=, |=, ~=, <<=, >>=, ~>>=, ..= и ??=. Индексное выражение в левой части вычисляется однократно.
  • Оператор continue для перехода к следующей итерации цикла, оформленный как «мягкое» ключевое слово (можно продолжать использовать как имя переменной).
  • Объявление const — блочная неизменяемая привязка локальной переменной; запрещены переприсваивание и повторное объявление в той же или вложенной области видимости (также «мягкое» ключевое слово).

В обсуждении дополнительно затрагиваются ещё не вошедшие в спецификацию идеи: выражение сопоставления с образцом через ключевое слово in, индексируемый тип для vararg (...varg, varg[i]), краткий синтаксис лямбд (|x| -> expr), оператор отложенного выполнения defer в стиле Go/Zig и присваивание в условии (if local x = ... then).

Появление расширений вызвало и критику: часть участников отметила, что нововведения окончательно превращают LuaJIT в отдельный язык, несовместимый с эталонным Lua 5.1. На это Полл ответил, что «этот корабль уплыл уже очень давно».

Документацию по языку планируется консолидировать в отдельное самостоятельное описание, в котором каждое расширение будет помечено версией, в которой оно появилось.

dataman
()

curl 8.21.0

 , , , ,

Группа Интернет

24 июня, после почти двух месяцев разработки, 531 коммита и исправления 276 ошибок, состоялся выпуск 8.21.0 (№275) кроссплатформенной многофункциональной консольной утилиты и библиотеки curl, написанных на языке C и распространяемых по лицензии curl.

( читать дальше... )


>>> Полный список изменений на curl.se (и в первой редакции этой новости)

>>> Видеопрезентация 8.21.0 на youtube

>>> Документация

>>> Страница загрузки

>>> Исходный код на GitHub

>>> Новость в блоге Даниэля Стенберга (haxx.se)

dataman
()

Stellarium 26.2

 , , , ,

Группа Open Source

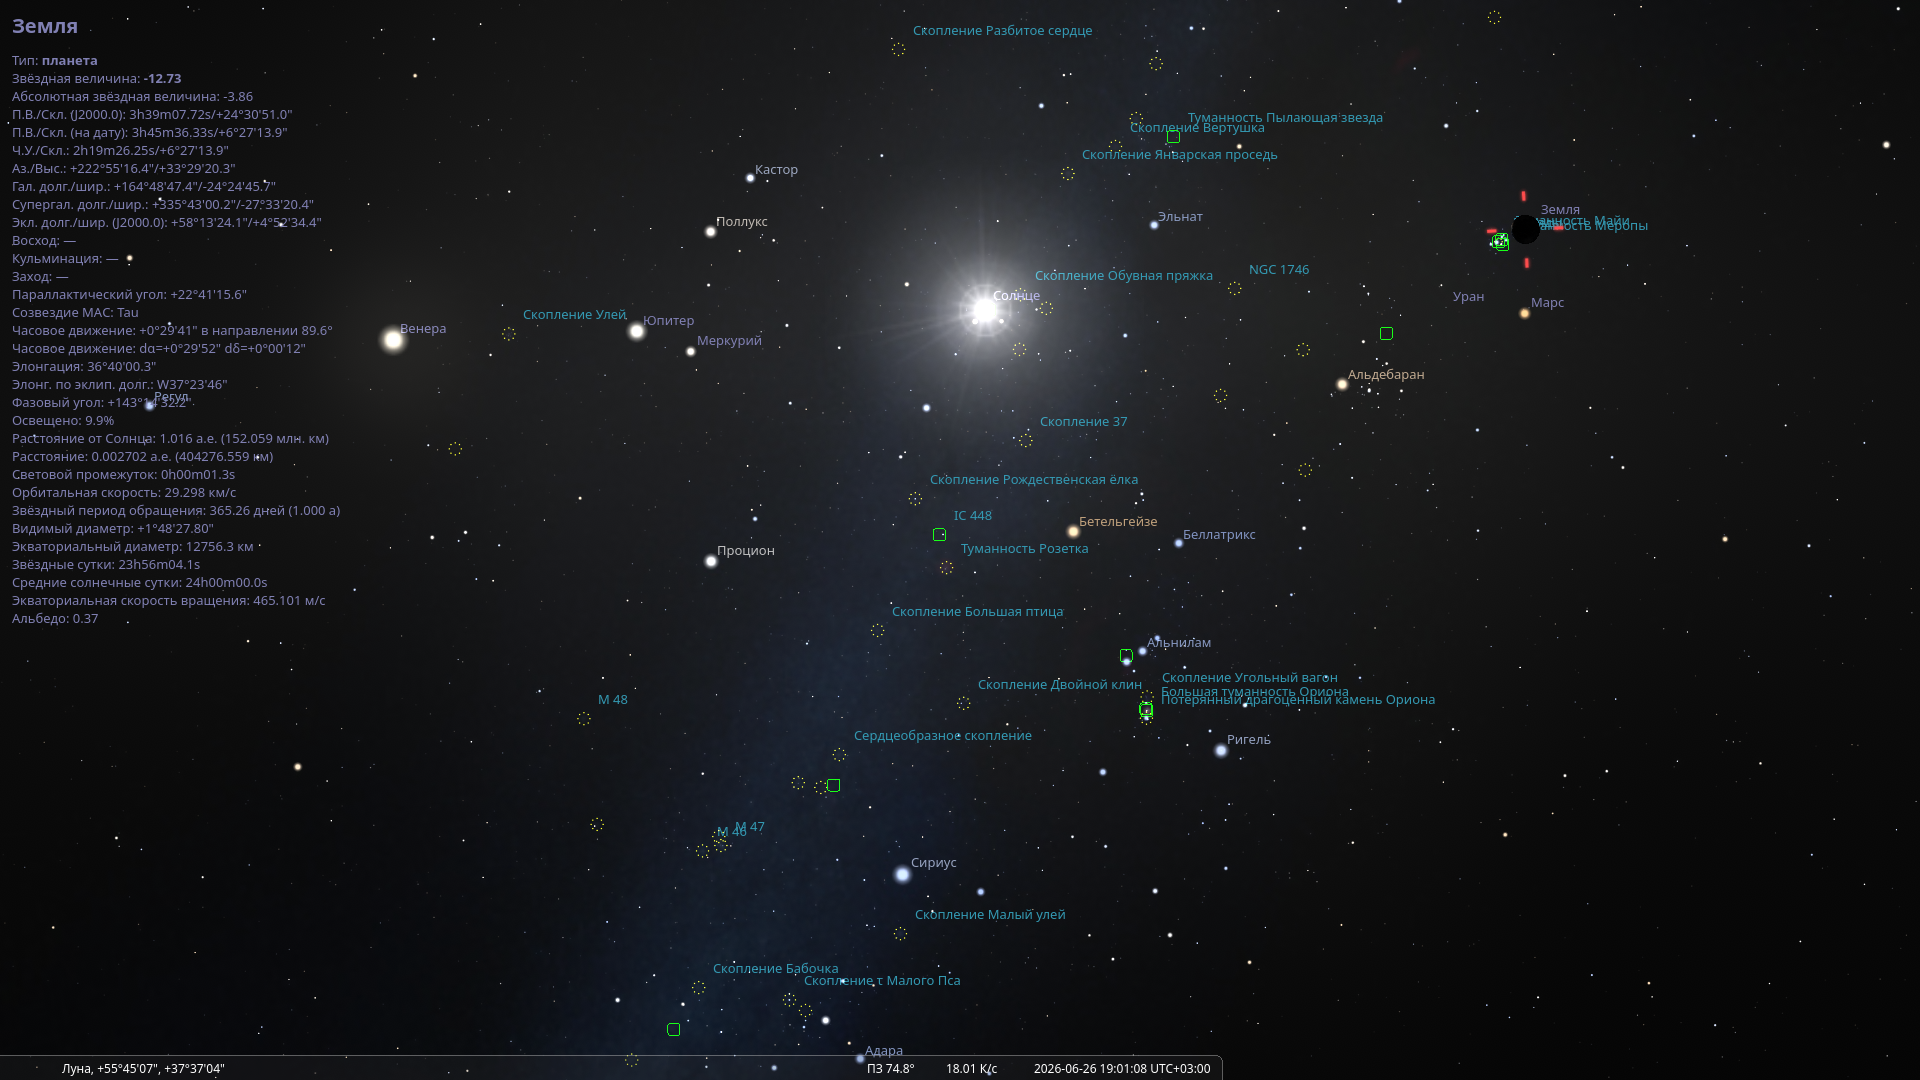
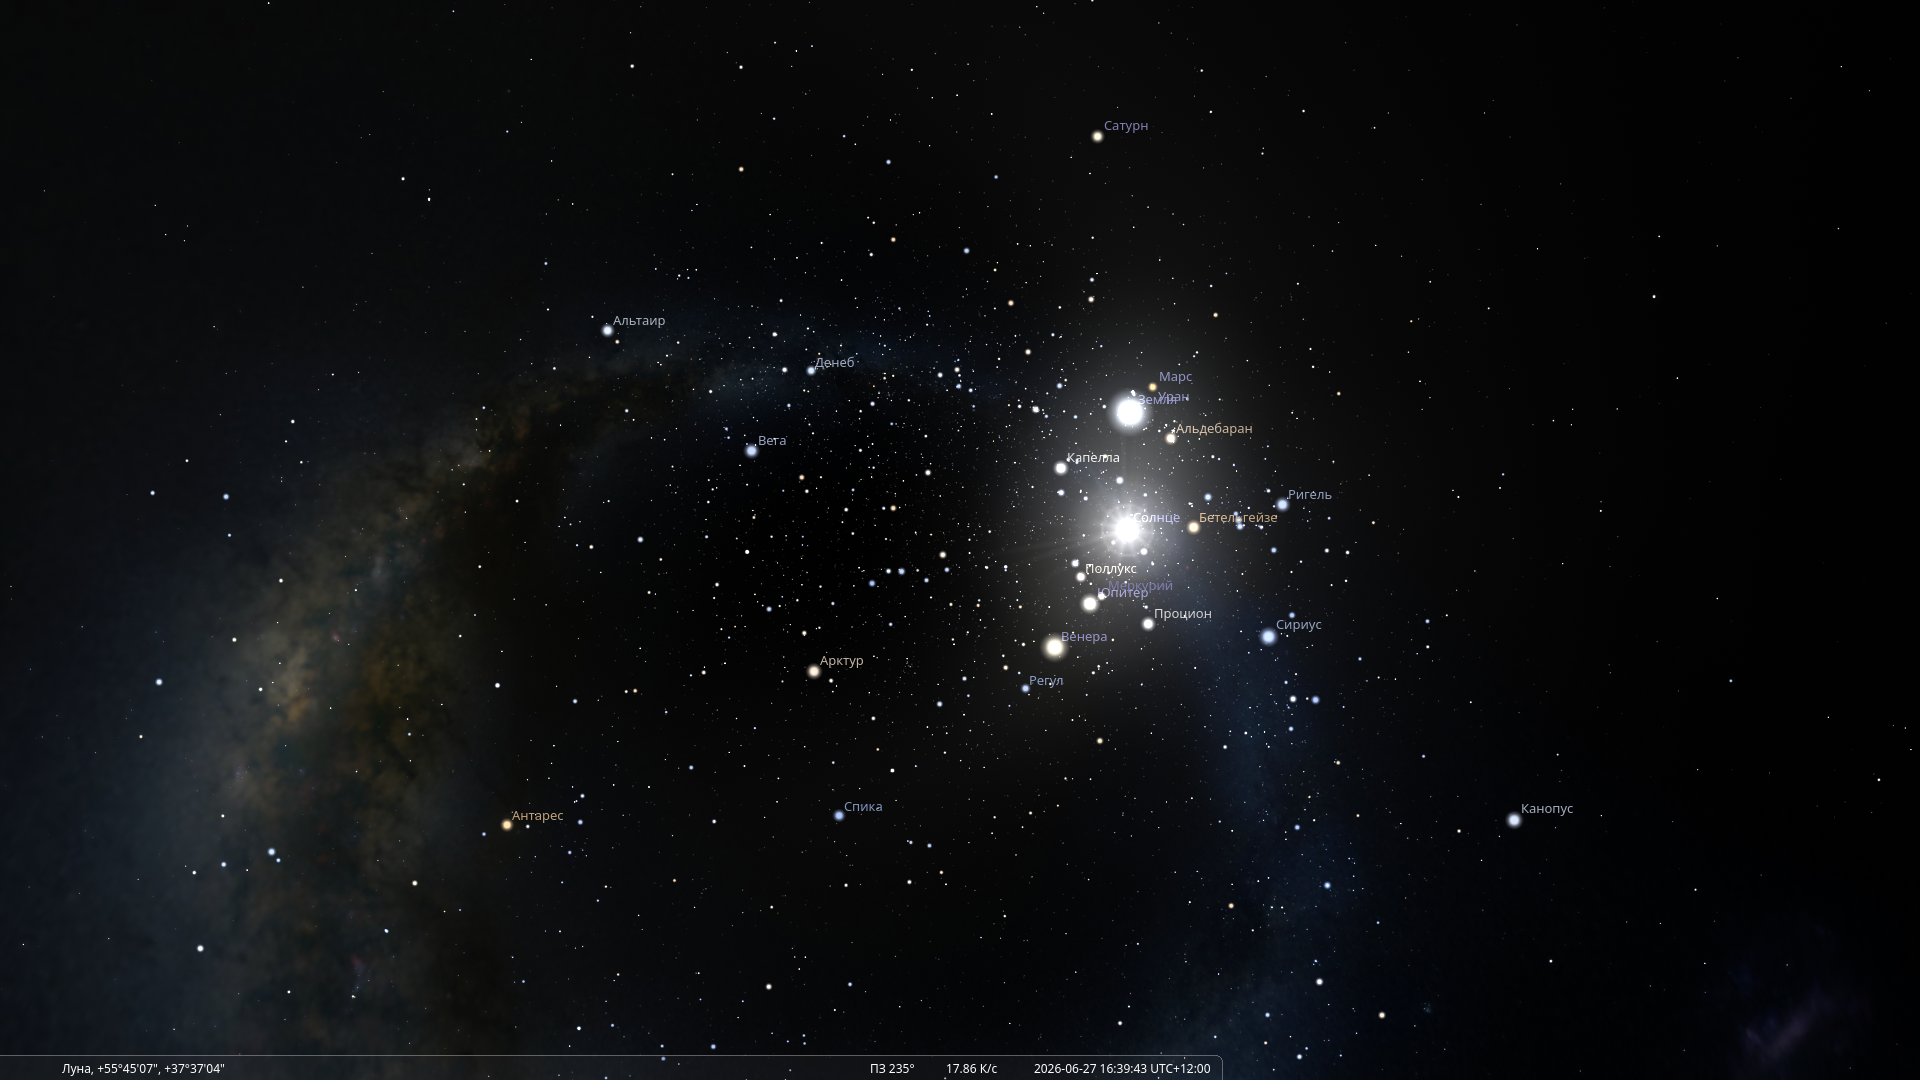
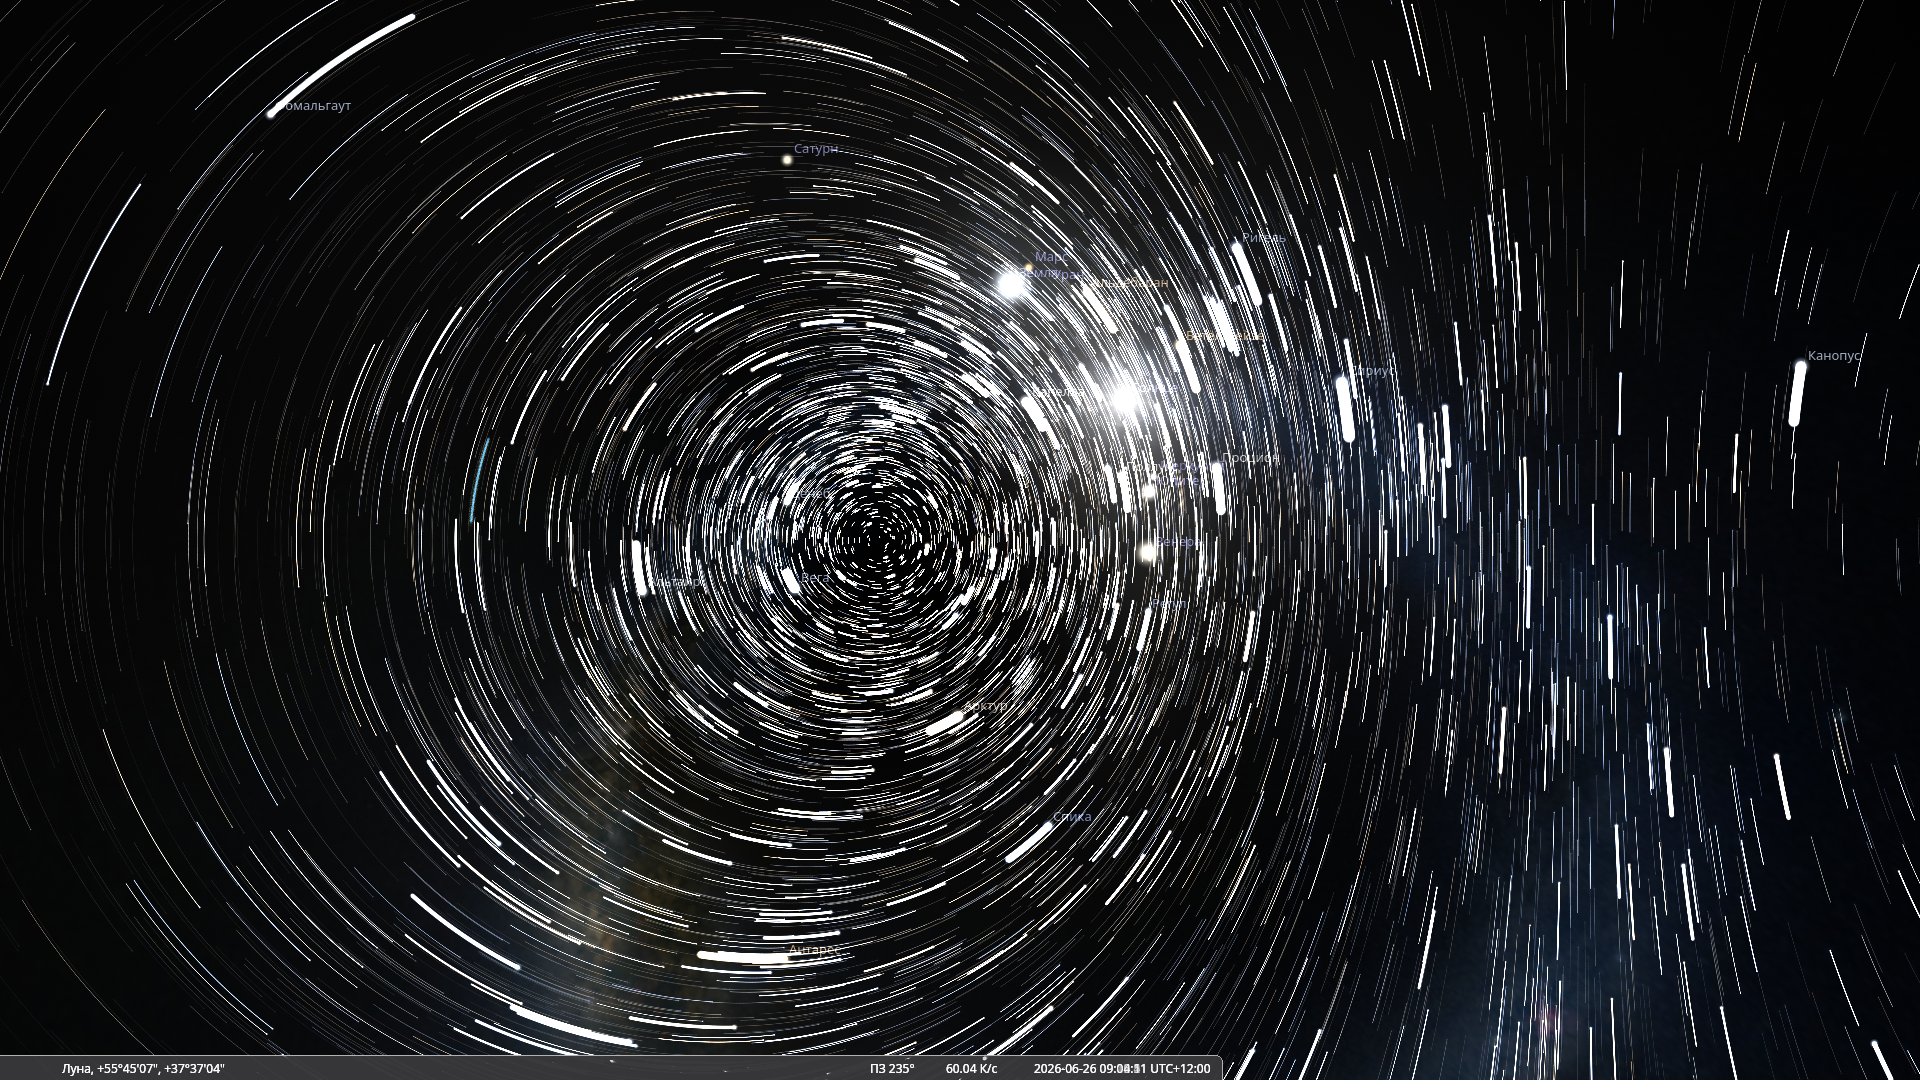
24 июня состоялся выпуск 26.2 популярного свободного кроссплатформенного планетария Stellarium — второй в этом году.

( читать дальше... )

>>> Источник: stellarium.org (stellarium.org)

dataman
()

Показывать ли в профиле количество игнорирующих?

 , ,

Для участия в опросе войдите или зарегистрируйтесь.

>>> Результаты

dataman
()

Проект rars подготовил свободную реализацию RAR с поддержкой создания архивов

 , , , ,

https://www.opennet.ru/opennews/art.shtml?num=65765:

Представлен проект rars, развивающий свободную реализацию инструментария для формата RAR, написанную на языке Rust и поддерживающую не только распаковку, но и создание RAR-архивов. Инструментарий поддерживает как ранние форматы RAR 1.3/1.4 с сигнатурой RE~^, так и последнюю версию RAR 7. Доступны такие расширенные операции, как разбиение на тома, защита паролем, шифрование заголовков, прикрепление комментариев, RARVM-фильтры, индексы для быстрого открытия и механизмы восстановления повреждённых данных. Код распространяется под лицензиями MIT и Apache-2.0. На базе библиотеки PyO3 подготовлены обвязки для языка Python, которые реализуют API в стиле rarfile для просмотра, тестирования и извлечения архивов, а также API в стиле RarBuilder для создания или перепаковки архивов.

Особенность проекта в том, что он реализует работу с форматом RAR без использования кода утилиты unrar, распространяемой под несвободной лицензией, которая запрещает использовать код unrar для воссоздания алгоритма сжатия RAR или разработки RAR-совместимого архиватора. Из-за данного ограничения большинство свободных архиваторов ограничивались лишь функциями распаковки RAR-файлов, а для создания RAR-архивов приходилось использовать проприетарный инструментарий от RARLAB.

Отдельно создан репозиторий rar-research в котором опубликованы спецификации для форматов RAR 1.3/1.4, RAR 1.5-4.x и RAR 5.0/7.0, а также заметки по используемым алгоритмам, фильтрам, методам проверки и восстановления целостности, шифрованию, разбиению на тома и механизмам защиты. Так как на момент создания проекта rars официальной полноценной спецификации не существовало, документация была воссоздана по коду распаковщиков, старым реализациям, тестовым архивам и анализу бинарных версий RAR для DOS и Windows.

Реализация была создана с использованием AI-инструментов OpenAI Codex 5.5 и Claude Opus 4.7 в свободное от работы время примерно за пять недель. На первом этапе модели применялись для систематизации информации о формате и восполнения пробелов в описании, после чего по восстановленной спецификации был сгенерирован код на языке Rust. Для уточнения спецификации и оттачивания реализации использовалась проверка работы на реальных архивах и сравнение с эталонными реализациями.

Отмечается, что AI-инструменты хорошо справились с переносом формального описания в код и с рутинной реализацией большого объёма функциональности, но не смогли обеспечить архитектурный контроль. Без жёсткого надзора AI-модели были склонны обходить тесты, усложнять код и пропускать очевидные проблемы, влияющие на удобство работы. По оценке автора, в проекте такого масштаба тесты, документация и комментарии стали не только инструментами проверки, но и способом направлять генерацию кода в нужное русло.

Форсировать разработку удалось после появления в OpenAI Codex режима /goal, позволяющего AI-агенту длительное время работать над одной задачей, сжимая контекст и продолжая выполнение после его переполнения. В таком режиме Codex несколько раз работал больше чем 6 часов и один раз около 16 часов, реализуя значительную часть оставшейся функциональности, такой как восстановление данных, шифрование и многотомные архивы. С учётом значительной субсидии на токены было потрачено 40 фунтов стерлингов.

По уровню сжатия rars в среднем на 5-10% отстаёт от WinRAR. По скорости сжатия и распаковки rars существенно медленнее WinRAR из-за отсутствия полноценных оптимизаций. При этом в проекте уже имеется режим --features fast, применяющий оптимизации на основе SIMD-инструкций для ускорения сжатия и распаковки, но завязанный на экспериментальный API std::simd, доступных только в тестовых сборках инструментария Rust. Также реализован режим --features parallel, использующий библиотеку Rayon для распараллеливания сжатия отдельных файлов.


Евгений Рошал, создатель RAR, прокомментировал использование обратного инжиниринга старых бинарных файлов RAR при разработке rars, что запрещено лицензионным соглашением. По словам Евгения, он пока не определился, что с этим делать и намерен дождаться мнения компании win.rar GmbH.

dataman
()

fooyin 0.11.0 и 0.11.1

 , , , ,

Группа Мультимедиа

22 июня состоялись выпуски 0.11.0 и 0.11.1 fooyin — музыкального плеера, ориентированного на индивидуальную настройку. Он предоставляет множество виджетов для управления и воспроизведения локальной коллекции музыки. Плеер обладает широкими возможностями расширения благодаря системе плагинов и включает в себя FooScript — язык сценариев для расширенной настройки виджетов.

Вы можете полностью настроить пользовательский интерфейс, перейдя в режим редактирования макета: начав с нуля или воспользовавшись готовым.

( читать дальше... )

>>> Документация

>>> Исходный код

>>> Источник: CHANGELOG.md (raw.githubusercontent.com)

dataman
()

Рекомендации по использованию AI при разработке открытого кода

 , , , ,

https://www.opennet.ru/opennews/art.shtml?num=65754:

Правозащитная организация Software Freedom Conservancy (SFC), предоставляющая юридическую защиту свободным проектам и отстаивающая необходимость соблюдения лицензии GPL, подготовила список рекомендаций по использованию AI-систем на базе генеративных моделей машинного обучения при подготовке кода для открытых проектов. Рекомендации касаются юридических, этических и социальных особенностей применения AI при разработке кода под открытыми и свободными лицензиями, а также отражают взаимодействие разработчиков c AI, учитывая противоположные мнения в сообществе о допустимости применения AI в открытых проектах. Рекомендации пытаются свести к минимуму проблемы, которые могут возникнуть из-за использования AI-систем по своей инициативе или по требованию работодателя.

  1. Сообщество должно поддерживать, а не просто терпимо относиться к участникам, выступающим против применения генеративных AI-систем.
  2. Каждый участник имеет право на самоопределение в вопросах использования AI и никто не должен вынуждать применять подобные системы под давлением. Принятие политики недискриминации в отношении тех, кто отказывается от AI, и недопустимость принуждения работников компаний к использованию AI.
  3. Открытые проекты не должны отталкивать участников, применяющих AI, даже если проект ввёл запрет на принятие созданного через AI кода. В подобных проектах созданные через AI патчи следует рассматривать как слабую пробу пера и корректно отклонять их, приветствуя при этом само желание участвовать в разработке и вежливо объясняя, почему проект не принял патч.
  4. В случае создания материалов через AI, участник обязан потратить время на рецензирование, разбор сути и внесение доработок. Разработчики должны полностью понимать суть изменений и разбираться в передаваемом коде.
  5. Раскрытие в примечании к коммитам информации об использовании AI при подготовке изменений с детализацией уровня участия AI, используемых AI-систем и их версий.
  6. Код, сгенерированный AI-системой на основе промпта и не прошедший проверку человеком, допускается отправлять только в специально оговорённых случаях. Если возможность передачи подобного непроверенного кода не обозначена, то его следует считать нежелательным.
  7. Разработчики должны подробно и точно документировать своё взаимодействие с AI-моделью в процессе генерации кода и сохранять информацию о промптах наравне с исходным кодом.
  8. Юридические нормы, связанные с лицензированием и авторским правом на код, генерируемый при помощи AI, ещё находятся на стадии становления, поэтому не следует делать поспешные заключения о допустимости переписывания кода при помощи AI для замены лицензии с копилефт на пермиссивную или смены имущественных прав на код.
  9. Обрабатываемые в AI входные данные влияют на лицензирование результата. Вопросы влияния лицензий на код, используемый при обучении модели, пока остаются не решёнными. Но при генерации кода не «с нуля» (на основе голого промпта), а при работе с существующей кодовой базой, например, при подготовке патча или доработке кода, результат должен распространяться под копилефт-лицензией, если он создан при обработке кода c копилефт-лицензией.
  10. В качестве наиболее безопасного и жизнеспособного варианта рекомендуется использование копилефт-лицензий для нового кода, создаваемого при участии AI. Подобный подход снижает риски нарушения копилефт-лицензий на код, использованный при обучении AI-моделей. Судебных решений в этой области ещё не было и пока не сложилась юридическая практика, определяющая влияние на результат лицензий, под которыми распространяются материалы, используемые при обучении AI-моделей.
  11. Использование AI-систем, включая проприетарные, рассматривается как допустимый стратегический компромисс, если они способствуют ускорению развития открытого ПО.
  12. При разработке AI-систем рекомендуется развивать платформы, более дружественные к идеям открытого и свободного ПО.
  13. AI-системы должны расширять инструменты и опыт разработчика, а не заменять их и приводить к деградации навыков. Разработчики должны сохранять любопытство и желание разбираться в том, почему код ведёт себя так, а не иначе, и это любопытство должно распространяться на результаты работы AI.
  14. Разработчики должны осознанно подходить к использованию AI-систем, не обращаться к ним по мелочам и избегать бессмысленных вычислений, понимая, что выполнение AI-моделей приводит к значительному потреблению ресурсов и косвенно влияет на окружающую среду.
dataman
()