LINUX.ORG.RU

Сообщения question4


Зачем нужны эти порты?


Когда я пытаюсь зайти на сайт vseinstrumenti, он безуспешно лезет куда-то на локальной машине:

wss://127.0.0.1:3389/
wss://127.0.0.1:5900/
wss://127.0.0.1:5901/
wss://127.0.0.1:7070/
wss://127.0.0.1:49664/
wss://127.0.0.1:9222/

Что ему там нужно?

P.S. Firefox, Gentoo Linux. На все перечисленные запросы ошибка «connection refused», так как на этих портах у меня ничего нет.

P.P.S. Подключения наблюдал в «Мониторе сети» в Firefox (открывается по F12).

question4
()

Как положено делать паузу в JavaScript?

 , ,

Есть вот такой скрипт: https://github.com/ianoxley/open-selected-links/blob/master/open-selected-links.user.js Открывает в новых табах ссылки при их выделении с зажатым Ctrl. Судя по всему, предназначался для страницы поиска Гугла.

Большинство сайтов не любят, когда кто-то открывает десятки страниц одновременно. Поэтому между вызовами GM_openInTab в цикле в функции openSelectedLinks (строка 39) нужно сделать паузу несколько секунд.

Погуглил как делать паузу на джаваскрипте и запутался. Что такое async и await? Когда вызов setTimeout остановит скрипт, а когда — нет?

ОТВЕТ: Для паузы 10 с нужно заменить вызов GM_openInTab(selectedLinks[i].href) на setTimeout(_ => GM_openInTab(selectedLinks[i].href), 10000*(selectedLinks.length-i))

Пока получился такой скрипт:

// ==UserScript==
// @name         open-selected-links
// @namespace    http://tampermonkey.net/
// @version      2026-07-15
// @description  Opens selected links in new tabs
// @author       ianoxley
// @match        *
// @grant        GM_openInTab
// ==/UserScript==

(function() {
    'use strict';

    document.addEventListener('keydown', function(e) {
        const ctrlKeyCode = 17;
        const cmdKeyCode = 224;

        if (e.keyCode == ctrlKeyCode || e.keyCode == cmdKeyCode) {
            document.addEventListener('mouseup', openSelectedLinks, true);
        }
    }, true);

    // Remove the mousedown handler so it doesn't open links just by selecting text *without* ctrl / cmd
    document.addEventListener('keyup', function(e) {
        document.removeEventListener('mouseup', openSelectedLinks, true);
        }, true);

    function openSelectedLinks(e) {
        const selection = window.getSelection();
        if (selection) {
            const selectedLinks = selection.getRangeAt(0).cloneContents().querySelectorAll('a');

            const n = selectedLinks.length;
            for (let i = n-1; i >= 0; --i) {
                setTimeout(_ => GM_openInTab(selectedLinks[i].href), 10000 * (n - i));
            } // timers open new tabs once per 10 000 ms
        }
    }
})();

Нормально работает, если выделять текст с конца — снизу вверх справа налево. Если сверху вниз — иногда открывает ссылки в обратном порядке.

question4
()

Что здесь можно сократить?

 , ,

У одного известного сайта конфликт с черногорским(?) регистратором доменов. В результате ему пришлось срочно переехать с домена t.me, на домен telegram.me. Часть веб-страниц поломалась, т.к. пытаются качать IFRAME-ы со старого домена.

Гугло-ИИ предложил короткий скрипт, который работал, но высота IFRAME была неверной. После долгой беседы DeepSeek выдал такой скрипт:

// ==UserScript==
// @name         t.me corrector
// @namespace    http://tampermonkey.net/
// @version      2026-07-14
// @description  replace "t.me" with "telegram.me"
// @author       DeepSeek
// @match        https://telegram.me/*
// @grant        none
// ==/UserScript==

(function() {
    'use strict';

    // Функция замены домена
    function replaceDomain(url) {
        try {
            const urlObj = new URL(url, window.location.href);
            if (urlObj.hostname.includes('t.me')) {
                urlObj.hostname = urlObj.hostname.replace(/t\.me/g, 'telegram.me');
                return urlObj.toString();
            }
        } catch (_) {}
        return url.replace(/t\.me/g, 'telegram.me');
    }

    // Функция подстройки высоты одного iframe
    function autoHeightIframe(iframe) {
        // Сначала убираем прокрутку и задаём начальную высоту
        iframe.style.overflow = 'hidden';
        //iframe.scrolling = 'no'; // для старых браузеров
        iframe.style.height = '100px'; // временная, чтобы сработало

        const adjustHeight = () => {
            try {
                // Доступ к содержимому возможен, т.к. домен совпадает
                const doc = iframe.contentDocument || iframe.contentWindow.document;
                if (!doc) return;

                // Вычисляем высоту содержимого (body + margin)
                const body = doc.body;
                const html = doc.documentElement;
                const height = Math.max(
                    body.scrollHeight,
                    body.offsetHeight,
                    html.clientHeight,
                    html.scrollHeight,
                    html.offsetHeight
                );

                // Устанавливаем новую высоту с небольшим запасом (опционально)
                iframe.style.height = height + 'px';
            } catch (e) {
                // Если доступ запрещён (неожиданно) – игнорируем
            }
        };

        // Подстраиваем после полной загрузки iframe
        iframe.addEventListener('load', () => {
            adjustHeight();
            // Настраиваем отслеживание изменений внутри iframe
            //setupObservers(iframe);
        });

        // Если iframe уже загружен (например, src установлен ранее)
        if (iframe.contentDocument && iframe.contentDocument.readyState === 'complete') {
            adjustHeight();
            //setupObservers(iframe);
        }
    }

    /*
    // Настройка наблюдателей за изменениями внутри iframe
    function setupObservers(iframe) {
        try {
            const doc = iframe.contentDocument;
            if (!doc) return;

            const target = doc.body;
            if (!target) return;

            // 1. ResizeObserver – отслеживает изменение размера элементов
            if (window.ResizeObserver) {
                const resizeObserver = new ResizeObserver(() => {
                    // При изменении размера пересчитываем высоту
                    const height = Math.max(
                        doc.body.scrollHeight,
                        doc.documentElement.scrollHeight,
                        doc.body.offsetHeight,
                        doc.documentElement.offsetHeight
                    );
                    iframe.style.height = height + 'px';
                });
                resizeObserver.observe(target);
                // Также наблюдаем за html, так как изменения могут быть там
                resizeObserver.observe(doc.documentElement);
            }

            // 2. MutationObserver – отслеживает добавление/удаление узлов
            const mutationObserver = new MutationObserver(() => {
                // Пересчёт высоты после изменения DOM
                const height = Math.max(
                    doc.body.scrollHeight,
                    doc.documentElement.scrollHeight,
                    doc.body.offsetHeight,
                    doc.documentElement.offsetHeight
                );
                iframe.style.height = height + 'px';
            });
            mutationObserver.observe(target, {
                childList: true,
                subtree: true,
                attributes: true,
                attributeFilter: ['style', 'class', 'height', 'width']
            });
        } catch (e) {
            // Если доступ запрещён – игнорируем
        }
    }
    */

    // Обработка одного элемента
    function processElement(el) {
        if (el.tagName === 'IFRAME') {
            // Заменяем src у iframe
            const src = el.getAttribute('src');
            if (src && src.includes('t.me')) {
                el.setAttribute('src', replaceDomain(src));
                // После замены src запускаем подстройку высоты
                autoHeightIframe(el);
            }
            return; // Не обрабатываем другие атрибуты у iframe
        }

        // Для остальных элементов заменяем href, src, action
        const attrs = ['href', 'src', 'action'];
        for (const attr of attrs) {
            if (el.hasAttribute(attr)) {
                const value = el.getAttribute(attr);
                if (value.includes('t.me')) {
                    el.setAttribute(attr, replaceDomain(value));
                }
            }
        }
    }

    // Обработка всех существующих элементов
    function processAllElements() {
        document.querySelectorAll('[href], [src], [action]').forEach(processElement);
    }

    // Запуск после загрузки DOM
    if (document.readyState === 'loading') {
        document.addEventListener('DOMContentLoaded', processAllElements);
    } else {
        processAllElements();
    }

    /*// Наблюдаем за динамически добавляемыми элементами
    const observer = new MutationObserver((mutations) => {
        for (const mutation of mutations) {
            for (const node of mutation.addedNodes) {
                if (node.nodeType === Node.ELEMENT_NODE) {
                    processElement(node);
                    node.querySelectorAll('[href], [src], [action]').forEach(processElement);
                }
            }
        }
    });
    observer.observe(document.body, {
        childList: true,
        subtree: true
    });*/
})();

Что в нём можно сократить? Помимо вызова observer.

UPD: В итоге досокращал до:

(function() {
    'use strict';

    const elements = document.querySelectorAll('iframe');
    // console.log(elements)
    elements.forEach((frame, index) => {
        if (frame.src.startsWith('https://t.me/')){
            // console.log(frame.src);
            frame.src = frame.src.replaceAll('://t.me/', '://telegram.me/');
            const adjustHeight = () => {
                const doc = frame.contentDocument || frame.contentWindow.document;
                const height = Math.max(doc.body.scrollHeight, doc.body.offsetHeight, doc.documentElement.clientHeight, doc.documentElement.scrollHeight, doc.documentElement.offsetHeight);
                frame.style.height = height + 'px';
            };
            frame.addEventListener('load', () => {
                adjustHeight();
            });
        };
    });
})();

Ничего важного не потерял?

question4
()

Скачать все версии одного файла


Есть проект на Гитхабе, там файл со справочной таблицей в CSV, старые версии которой могут быть полезны. Может ли git как-то выкачать все коммиты для заданного файла, не качая всё остальное? Нагугленные рецепты требуют клонировать всё.

Адрес не называю, чтобы не не начали обсуждать проект, и тему не потёрли как оффтопик.

Пока предложили следующее:

git clone --filter=blob:none --no-checkout https://github.com/{owner}/{project}
cd {project}
git sparse-checkout set <path/to/file>
git checkout

Хеши коммитов: git log --pretty=format:"%h" path/to/file > hashes.txt

И файл для каждого: git show $hash:path/to/file > $hash.txt

Но извлечение по одному файлу по хешу через git show получается довольно медленно — ~55 файлов в минуту. Хотелось бы побыстрее.
UPD: Чем старее коммит, тем медленнее. 30 000-е извлекаются со скоростью ~14 файлов в минуту, хотя файлы на порядок меньше объёмом.

UPD2: Создание *.patch файлов: git format-patch --root -o /path/to/patches-directory path/to/file — работает гораздо быстрее и надёжнее. Но для больших объёмов нужно увеличить параметр ядра vm.max_map_count: sysctl -w vm.max_map_count=... от рута. (По умолчанию 65530.)

question4
()

Ремейк FF6

 , , ,

Искал трейлеры Final Fantasy 6 для 1-й PlayStation (хотел узнать, выпустили ли всего 1 или больше), наткнулся на датированные маем 2026 превью ремейка в современном 3D от третьего лица (оригинал был последним в серии тайловым). Вот все 4 (Celes, Locke, Terra и Kefka) в одном видео: https://www.youtube.com/watch?v=0vsyXzAjhDU (заблокирован)

Выглядит отлично, хотя дизайн персонажей не вполне устоялся, например король то совсем худой, как девушки, то шириной плеч несильно уступает брату-каратисту. Графика не то, чтобы супер, но явно не требующая топового железа. Неоднозначно выглядит идея добавить прошлое финального злодея с ним в качестве игрового персонажа.

А под видео написано, что сгенерировано ИИ :(

question4
()

Вышла ZLUDA 6, независимая реализация CUDA

 , ,

Группа Hardware and Drivers

Вышла очередная версия ZLUDA — прослойки совместимости для параллельных вычислений на графических процессорах не-Nvidia, нацеленная на полную совместимость с CUDA. Соответствует версии CUDA 13.1. Пока поддерживаются только AMD (версия ROCm до 7.2), планируется и Intel. Написана на Rust.

Заявлена начальная поддержка работы поверх ZLUDA физического движка PhysX и 3D-редактора Blender.

О названии. Cuda по-польски — «чудеса», złuda — «иллюзия». Автор говорит, что не вкладывал глубокого смысла, просто взял первое попавшееся слово созвучное с CUDA, чтобы сменить название notCUDA.

>>> GitHub

>>> Краткий чейнджлог

>>> Полный чейнджлог

>>> Новость на opennet.ru

>>> Новость на официальном сайте (vosen.github.io)

question4
()

USB tethering отваливается каждые несколько минут

 ,

Проводной интернет обещают починить только в среду. Мегафон, безлимитный тариф, телефон HUAWEI MNA-LX9, Gentoo с OpenRC. «USB tethering» при втыкании кабеля не появляется, нужно искать его глубоко в настройках телефона. Network Manager не работает, поэтому от рута перезапускаю /etc/init.d/net.enp14s0f4u1. После этого выдаёт IP из диапазона 192.168.. интернет работает, иногда долго, иногда ~3 минут, после чего связь обрывается, ping выдаёт «From 169.254…….. icmp_seq=… Destination Host Unreachable», и повторные перезапуски net.* выдают адрес в диапазоне 169.254... Если выключить-включить «USB tethering» на телефоне и перезапустить net.*, связь восстановится. dmesg ничего в моменты пропадания связи не показывает.

Прошлым летом была схожая проблема, но тогда вообще не выдавало рабочий IP. После нескольких апдейтов прошивки USB-модем заработал. С апрельской прошивкой не работал вообще, после обновления до новейшей — работает как описал.

С зарядкой телефона обрывы не коррелируют. Отваливалось и до полной зарядки, и после. С работой TOR и I2P тоже не коррелируют. С гашением экрана телефона тоже. Энергосбережение на телефоне отключено.

Кто-нибудь может объяснить, что происходит? Лечится? (помимо смены телефона)

Дополнение: Техподдержка Huawei посоветовала держать постоянно включённой отладку по USB. В результате я увидел, как выключатель «USB tethering» сам собой переключается туда-сюда, от чего связь через несколько секунд восстанавливается. Но итог тот же — в какой-то момент это перестаёт помогать, и связь отрубается. Хуже того, иногда переключатель перестаёт реагировать на нажатия, помогает только физически перетыкать кабель.

Какие проблемы создаёт режим отладки по USB?

question4
()

Кто как вводит иероглифы?

 , , , ,

Кто пользуется китайским или японским языком, как вы вводите иероглифы, произношения которых не знаете? Перепробовал много чего, но всё в итоге требует произношения. Кроме Kanjipad, но он мой почерк вообще не понимает.

P.S. Совсем забыл: есть поиск по радикалам в Kiten. Но там странно выглядят сокращённые варианты ключей (например, для 水 汁 вместо 氵, 水 вместо 氺), и редкие иероглифы могут отсутствовать (из ~20 иероглифов с 氺 есть всего 2). И рисовать было бы быстрее.

Какие приложения в современном десктопном Линуксе позволяют опознать нарисованный иероглиф или найти его по ключам? Без подключения к интернету.

UPD2: Вот тут хорошо распознаёт: https://kanji.sljfaq.org/draw.html, есть куча наворотов: Undo, опциональный учёт порядка и направления черт, несколько удобных реализаций поиска по радикалам (включая с учётом положения). Ищу оффлайн-версию. — Всё закрыто, оффлайн-версия недоступна.

question4
()

Какой язык короче?


Кто-нибудь пытался сравнивать объёмы исходников на разных языках?

Я понимаю, что разные языки удобнее для одних задач, и неудобнее для других. Где-то хорошее матичное умножение, где-то работа со строками, где-то GUI, где-то обвязка для БД, где-то удобнее писать ветвящиеся условия, а где-то мегабайты бойлерплейта и неприемлемо длинные ключевые слова.

Хорошо бы, если бы заодно сравнивали читаемость по каким-нибудь объективным критериям.

Кто-нибудь пытался анализировать статистику?

question4
()

Как лучше конвертировать HTML в текст?

 ,

Требуется превратить много файлов в формате HTML в формат TXT. С сохранением разбиения на абзацы. Как это лучше сделать?

Копирование текста из браузера плохо поддаётся автоматизации. elinks -dump рубит абзацы по 76 символов и вставляет номера гиперссылок (ширину можно менять, но тогда вставляет много пробелов в отцентрированный текст, и ширина ограничена). w3m -dump объединяет абзацы.

Что есть ещё?

Ответ: pyhtml2text -b 0 --ignore-links ....htm даёт желаемый результат.

question4
()

Эмодзи в цитатах не показываются при отключённом JavaScript

 ,

question4
()

Программа gallery-dl ушла с GitHub на Codeberg из-за DMCA

 , , ,

Группа Open Source

gallery-dl — программа для автоматического скачивания картинок с сайтов: Reddit, VK, X/Twitter… Вдохновлена youtube-dl (ныне yt-dlp) и тоже написана на Питоне.

Как и yt-dlp, она может использоваться для нарушения авторских прав. В конце марта Fakku LLC — крупный издатель переводных порнографических комиксов, игр и мультфильмов — потребовал удалить из программы возможность скачивать с 28 пиратских сайтов. И удалить соответствующие модули из истории git.

В обсуждении пользователи возмущаются, что Fakku тоже начинал как пиратский сайт, а теперь устроил крестовый поход против пиратов. И что некоторые из удаляемых модулей относятся к сайтам, которые уже удалили весь контент Fakku.

Автор программы обратился за советами в EFF и поддержку GitHub, но ответов не получил. В итоге в апреле перенёс на Codeberg полную версию программы и выполнил требования в отношении GitHub.

Багтрекеры работают и на GitHub, и на Codeberg, не синхронизируясь.

>>> Объявление о переносе в багтрекере на GitHub (github.com)

question4
()

Куда пропала кнопка предварительного просмотра постов?


Сабж. Для создания тем кнопка «Предпросмотр» есть, для ответов — нету. Чёрная тема, JavaScript отключён.

P.S. Как-то можно из Links сделать предпросмотр?

question4
()

Неверное число новостей в неподтверждённых


Прямо сейчас в неподтверждённых https://www.linux.org.ru/view-all.jsp?section=1 2 новости — Релиз Mesa 26.1, свободной реализации OpenGL и Vulkan и OpenZL 0.2.0 Но на странице неподтверждённых и на главной показывает «3». Аналогично на странице «Все» https://www.linux.org.ru/view-all.jsp показывает 24 вместо 23. Числа опросов и статей верные.

question4
()

Как объединить замену и транслитерацию?

 , ,

Как в sed (или vim) объединить в одну операцию выделение фрагмента строки и замену символа в этом фрагменте? Или как провести замену не в строке, а в подстроке, когда неизвестно, сколько замен произвести и сколько пропустить?

Есть набор URL-ов вида:

http://drabadan.ord/drabadan-1/cover/  
http://drabadan.ord/drabadan-1/pg1-1/  
http://drabadan.ord/drabadan-1/pg1-4/2/  
http://drabadan.ord/drabadan-again/pg5-1/  
http://drabadan.ord/list/  

Нужно преобразовать его в скрипт вида:

curl -LR http://drabadan.ord/drabadan-1/cover/ -o drabadan-1.cover.htm
curl -LR http://drabadan.ord/drabadan-1/pg1-1/ -o drabadan-1.pg1-1.htm
curl -LR http://drabadan.ord/drabadan-1/pg1-4/2/ -o drabadan-1.pg1-4.2.htm
curl -LR http://drabadan.ord/drabadan-again/pg5-1/ -o drabadan-again.pg5-1.htm
curl -LR http://drabadan.ord/list/ -o list.htm

То есть повторить исходную строку, затем вывести её же без «http://drabadan.ord/» и с заменой всех оставшихся «/» на «.» (заранее неизвестное число раз).

В итоге я всё сделал через регулярные выражения на Питоне. Можно через paste. Но можно ли тут обойтись однострочником на sed?

question4
()

Как сравнить звуковые файлы?

 ,

Есть 2 файла MP3. Вроде бы, в них одно и то же, но как узнать точно? Размер отличается на несколько процентов. Если запустить их одновременно в MPV, заметно отставание одного от другого, но если один немного сдвинуть по времени в Audacity, совпадут очень хорошо.

Если бы это были картинки JPEG, я бы вычел одну из другой, и смотрел, останется ли что-то заметное. А как вычесть звук? Файлы не настолько совпадают, чтобы можно было инвертировать один в Audacity и вычесть. Можно ли вычесть Фурье-образы, и какая программа так умеет?

Или как лучше вычесть один звуковой файл из другого?

question4
()

Переместить выпавший кусок окна

 , ,

Avidemux сжимает фильм. Я его свернул в трей. Время от времени открываю посмотреть оценку «Time remaining». В очередной раз превью фильма вылезло из основного окна и осталось висеть на экране после сворачивания в трей.

Это «окно» отображается поверх всех остальных. Переключиться в него по Alt-Tab невозможно. Переключиться в него из другого окна Avidevux по Alt-~ — тоже. Обрамления нет, нажатия мыши обрабатываются нижележащими окнами, поэтому выбрать его мышью или вызвать меню невозможно.

Как его переместить на другой монитор?

Дополнение: Левый верхний угол выпавшего «окна» находится там же, где был левый верхний угол превью на момент запуска Avidemux. По мере обработки фильма кадры в окне меняются (раз в несколько десятков минут), его размер меняется при изменении ширины окна Avidemux (с таким же запаздыванием). Я уже нашёл 2 способа убрать превью — изменить расположение мониторов, чтобы превью оказалось за видимой областью либо порядка часа не открывать Avidemux из трея. Но я хотел бы на будущее узнать способ двигать такие окна через xdotool или подобные утилиты.

Дополнение 2: «Окно» не видно xdotool, либо его положение не привязано к видимым xdotool координатам. На скриншотах Spectacle не отображается.

Дополнение 3: Превью исчезло при загрузке другого фильма.

Дополнение 4: Закрытый x11-drivers/nvidia-drivers-590.44.01

question4
()

10 петабайт — это много или мало?


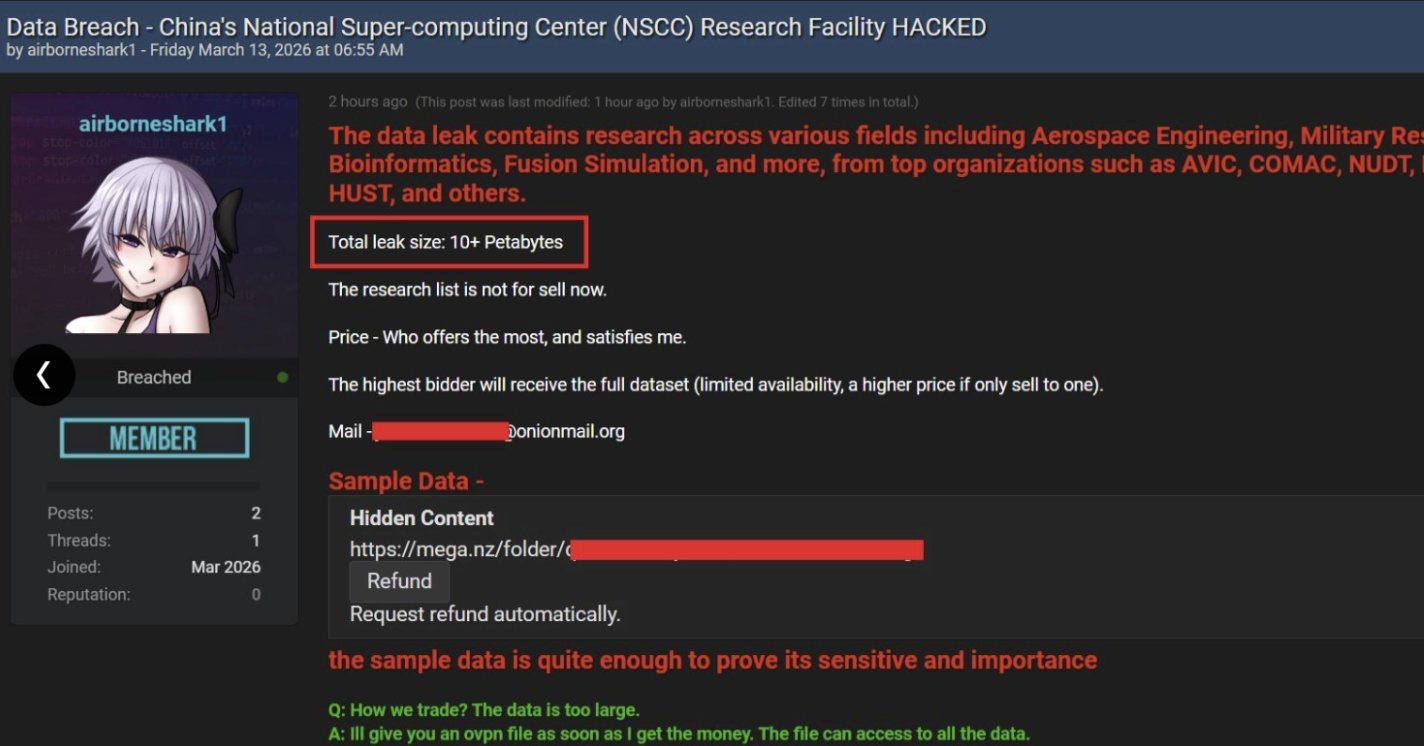
https://www.infowatch.ru/analytics/utechki-informatsii/krazha-konfidentsialnoy-informatsii-iz-tsentra-superkompyuterov
https://www.gazeta.ru/tech/news/2026/04/08/28229191.shtml
https://substackcdn.com/image/fetch/$s_!LwlW!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Fb4a18e63-ccb6-4e02-9b19-7f9a031b805e_1424x746.jpeg

Неизвестный, пишущий по-английски с ошибками, утверждает, что влез в Национальный Центр Суперкомпьютеров Китая (в Тянцзине) через дырявый VPN и за полгода скачал 10 петабайт данных. Говорит, что там — секретные результаты моделирования пробития бронированных целей, ядерного синтеза, что-то аэрокосмическое и биоинформационное, и т.п. Выставил на продажу в середине марта. За просмотр оглавления берёт 10 монеро (~$3000).

И я подумал: если моделировать сплавы клеточными автоматами, каждое зерно 25 мкм³ сделать отдельным автоматом, выделить на него 1 байт, то для моделирования столкновения танка (10 м³ стали) со стеной понадобится 10/(25e-18)=4e17 байт для каждого состояния. То есть 400 петабайт.

Каковы типичные объёмы данных при моделировании сплошных сред на суперкомпьютерах?

question4
()

TTS: какими голосами пользуетесь?

 , ,

Когда-то давно, во времена Festival, я пробовал прогонять через него книги. С английским языком получалось неплохо, если не забывать про экспоненциальное(?) замедление штатного скрипта и резать на главы. Единственный найденный голос для русского вымораживал своим затяжным «нееет», поэтому я потерял к нему интерес.

Сейчас попробовал несколько программ и остановился на piper. Из английских голосов нормально отработал первый же опробованный — Amy. Далее из 20 голосов половина отсеялась как неразборчивые или вызывающие желание прокашляться, но выбор есть. Самый заметный недостаток — иностранные имена странно произносят.

А что с русским языком?

Я нашёл 4 голоса. 2 совсем хриплые и неразборчивые. irina и ruslan понять можно, но ударения ставят как попало (слушать про короля, живущего в замкЕ забавно, но надоедает), путают е и ё (причём в обе стороны), часто игнорируют мягкий знак.

Кто чем пользуется из оффлайновых?

question4
()

Компилятор Си в виде shell-скрипта

 , ,

Группа Open Source

На Гитхабе выложен компилятор C89 в ELF64 на языке shell (sh, не bash). 7796 строк, лицензия ISC (isc.org) (эквивалентна MIT).

>>> Новость на opennet.ru

>>> Скрипт на GitHub (github.com)

question4
()