LINUX.ORG.RU

Заготовка для 3D оконного менеджера

 bevy, , , ,


1

1
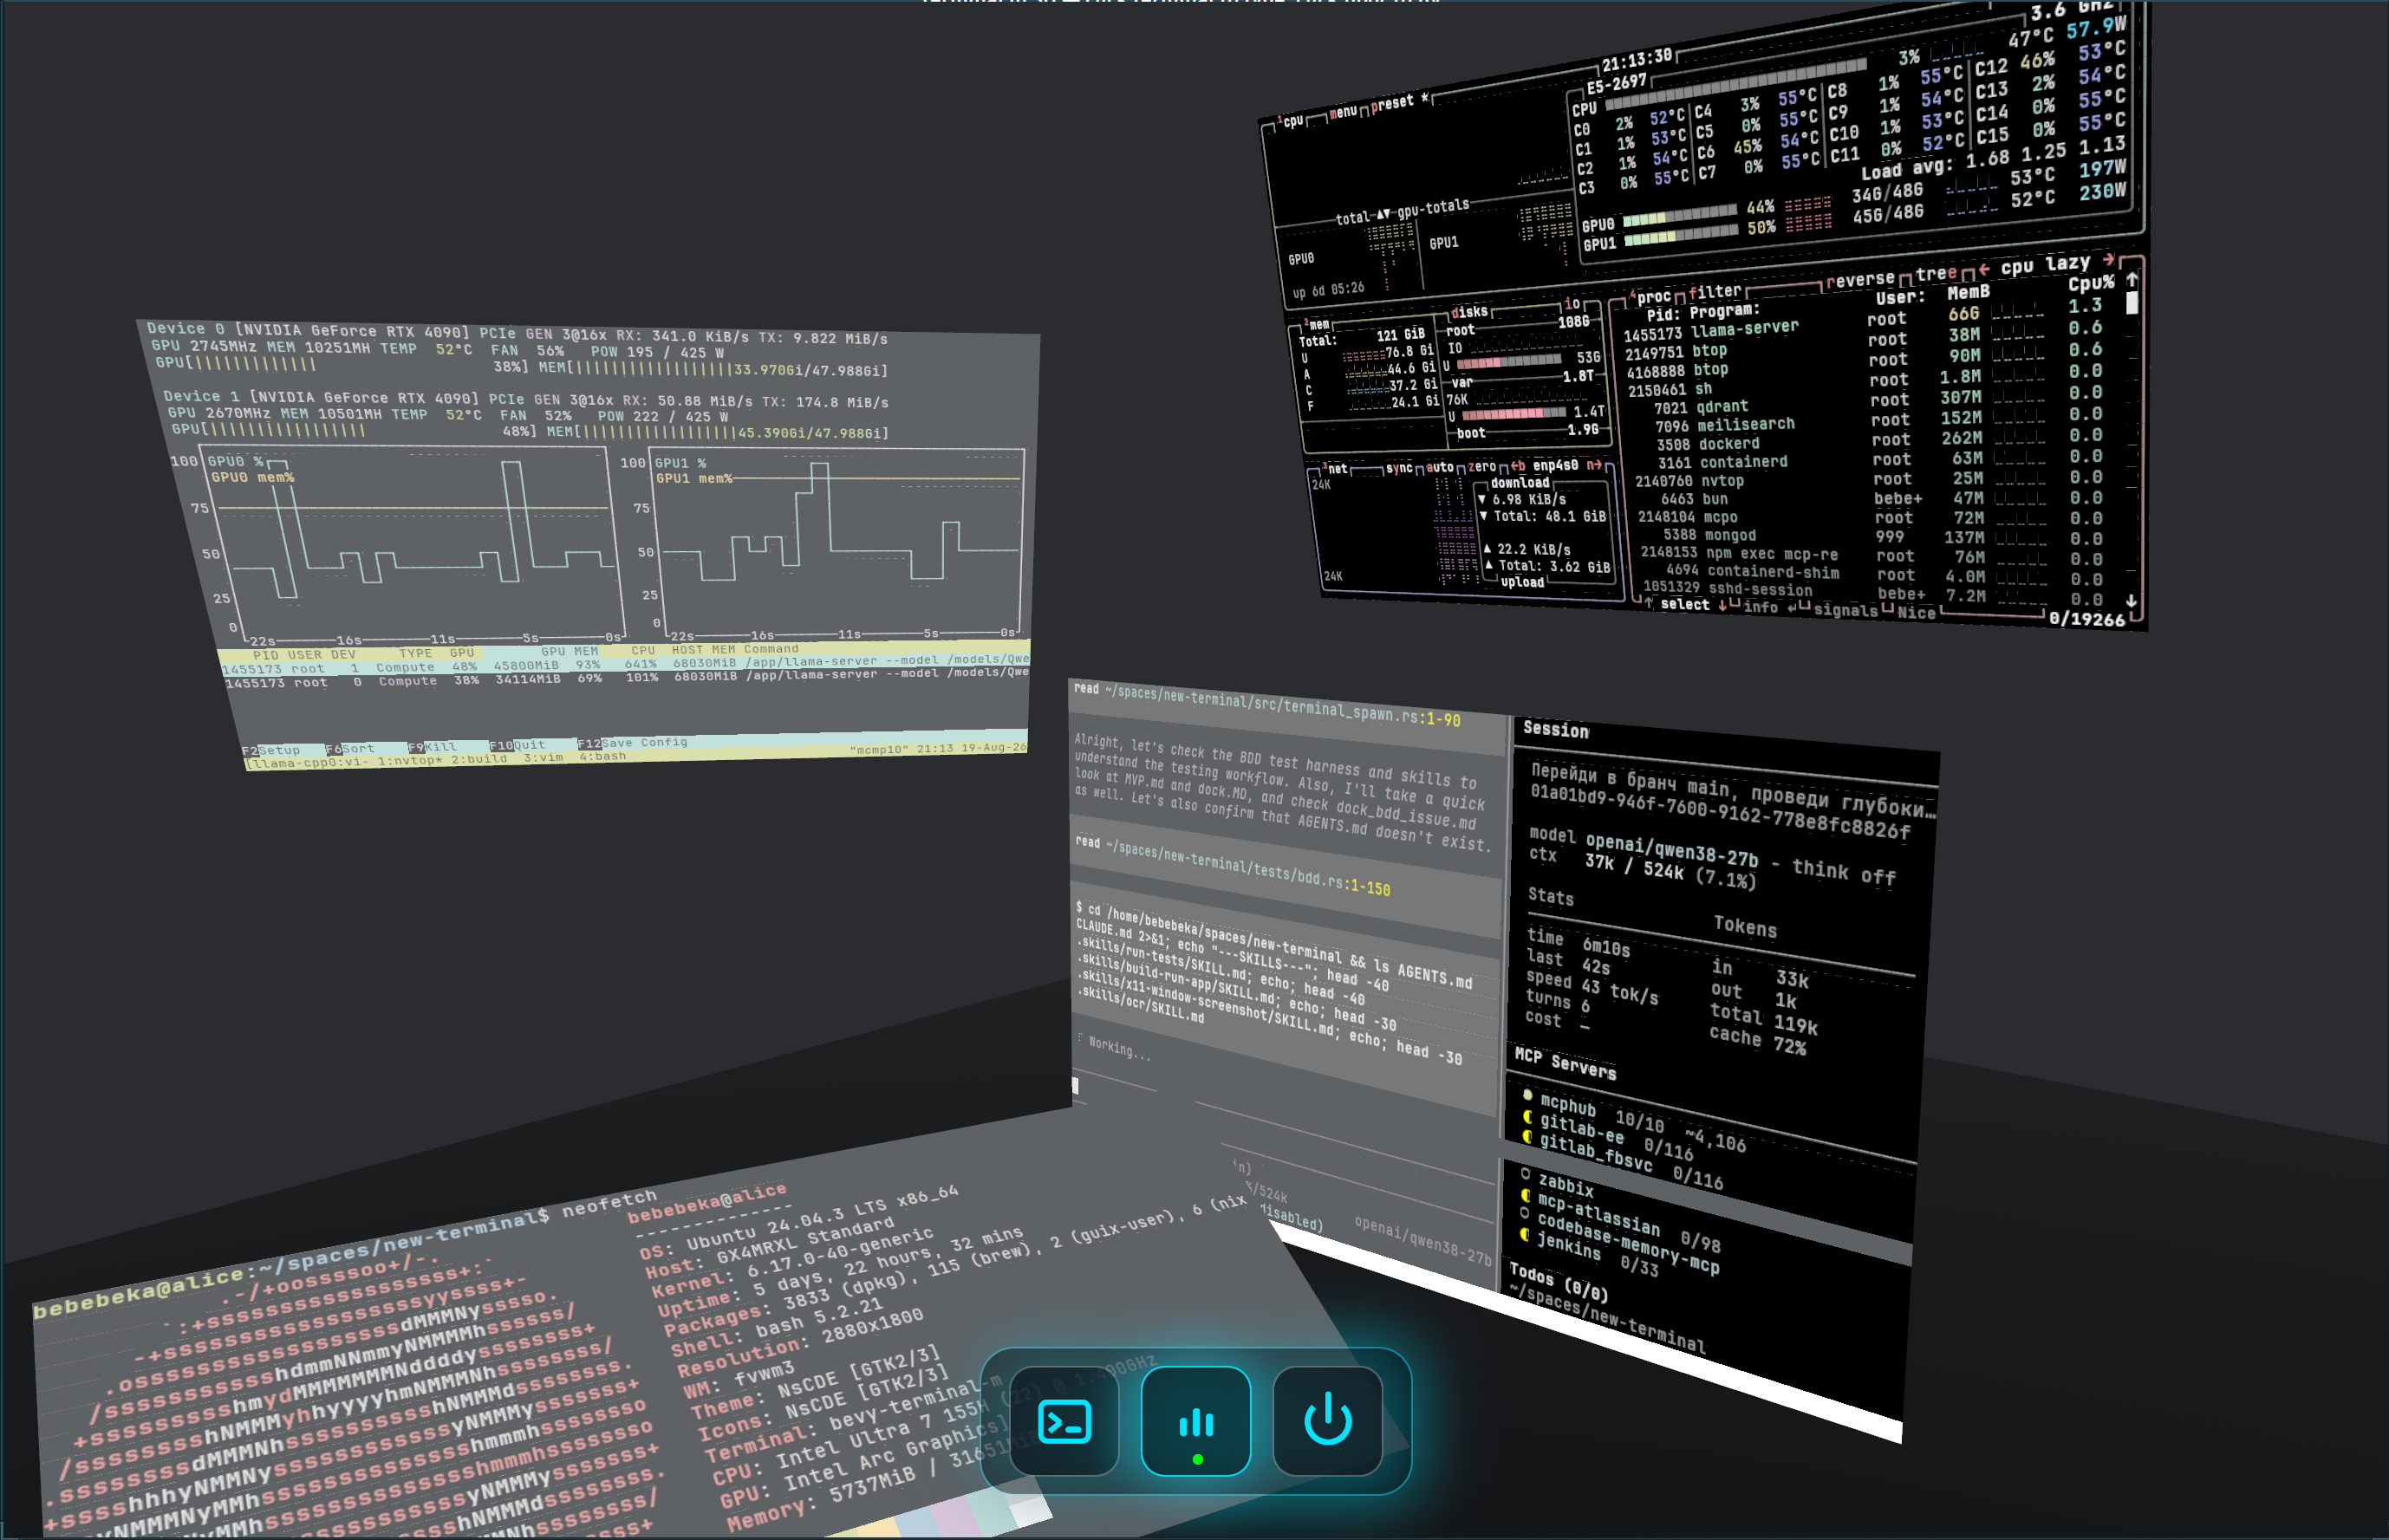
  • Слева вверху запущена nvtop, показывает характеристики и метрики двух видеокарт rtx 4090 48gb mod, на которых крутятся LLM.

  • Справа вверху — утилита btop, запущенная на той же машине (с видеокартами): Dual xeon CPU E5-2697 v4, 128GB DDR4, 2TB NVMe (под модели), 128GB SSD (под систему)

  • Пониже запущен tmux, в котором работает агент pi.dev, через который собственно и производится вайбкодинг (для локальных LLM советую именно pi.dev)

  • Ну и на первом плане neofetch с моего ноутбука, где запущена графическая среда

Модели, которые кодируют код:

  • Deepseek v4 flash 0731 IQ3_XXS (хорошо, но к сожалению не умеет CV (компьютерное зрение))

  • Недавно вышедший Qwen3.8-27B Q8 - тоже хорош, с поддержкой CV, что внезапно оказалось критичном при разработке UI приложений

Стек технологий в тегах.


Проверено: cetjs2 ()
Последнее исправление: cetjs2 (всего исправлений: 4)
Ответ на: комментарий от gagarin0

У меня тоже проект в разработке (нет, не тот, про который я новости писал), но наличию репы на гитхабе это никак не мешает.

Помимо прочего, интересующиеся могут потыкать проект палочкой и задуматься, не принять ли участие.

hobbit ★★★★★
()
Последнее исправление: hobbit (всего исправлений: 1)
Ответ на: комментарий от Bad_ptr

С современными нейронками это даже можно визуализировать

einhander ★★★★★
()
Ответ на: комментарий от ethylkode

«Нормальность» генерации кода сильно больше зависит от работы с моделью, чётких, понятных модели и reproduceable пунктов DoR/DoD/Goal в плане, вообще наличие нормального пошагового плана работы, эффективной работой со скиллами и субагентам, и чтобы не загаживать общий контекст.

Обычно херакнули несколько промтов, и сказали «ой какая-то тупая модель, галики пошли, наверное надо по-дороже оплатить».

shahid ★★★★★
()
Ответ на: комментарий от ethylkode

на мое удивление, модель себя ведет себя очень достойно, я полностью ей покрываю администрирование своей домашней лабы (10 нод)

gagarin0
() автор топика
Ответ на: комментарий от einhander

для локальной LLM практически во всем (если мы говорим об opencode и pi.dev из коробки)

gagarin0
() автор топика

Жду когда выйдет в общий доступ! Хорошая работа, коллега по вайбкодингу!

dsalin
()
Ответ на: комментарий от dsalin

коллега по вайбкодингу!

раньше было понятие «вебмакакинг», теперь, видимо, в ходу будет «вайбмакакинг» :)

DrRulez ★★★★★
()
Последнее исправление: DrRulez (всего исправлений: 1)
Ответ на: комментарий от shahid

я сегодня bonsai-27b q1 попробовал и был приятно удивлен тому как сносно оно пишет код. Qwen 9b q4 с той же задачей справляется заметно хуже. Просто чат, просто абстрактная задача без конкретики.

Интересно было бы узнать пайплайн автора топика.

ethylkode
()
Ответ на: комментарий от ethylkode

выхлоп от чатгопоты, от себя добавлю просто попробуй установить pi.dev и поработай с ним, «разницу» почувствуешь сразу

Pi не обязательно «умнее» OpenCode. Его преимущество для local LLM в другом: он гораздо меньше стоит модели в терминах context и agent overhead.

Pi изначально сделан как minimal harness: маленький system prompt, базово всего несколько tools, а дополнительные skills/capabilities можно подгружать по необходимости. OpenCode — batteries-included: LSP, больше встроенной логики, tools, search, agents и т. д. Это удобно, но всё это тоже становится частью того, что модель должна видеть и понимать.

Есть даже оценка system prompt: около ~900 tokens у Pi против ~7k+ у OpenCode, хотя эту цифру надо воспринимать как приблизительную — OpenCode сильно зависит от версии и конфигурации. Сам Pi официально позиционирует minimal system prompt и ручной context engineering как одну из основных своих особенностей.

На cloud-модели с быстрым inference и огромным context это может быть почти незаметно. Но на локальной 27B/35B/DeepSeek, где каждый лишний prompt token реально надо прогнать через GPU/CPU, разница уже становится практической.

Например, в независимом тесте одной Qwen 3.6 27B на одной задаче получилось:

Pi: 4 requests / 4,853 tokens / 3:03 OpenCode: 4 requests / 6,974 tokens / 3:37

То есть модель одна и та же, количество LLM calls одинаковое, но Pi использовал примерно на 30% меньше output tokens и закончил быстрее. При этом OpenCode на некоторых web-задачах давал лучший результат благодаря встроенному web search — поэтому это не история «Pi всегда лучше».

Есть и более крупный тест Composio с DeepSeek V4 Flash на 30 agentic workflows:

Pi: 20/30 — 66.7% OpenCode: 14/30 — 46.7%

Runtime token processing: Pi ≈ 559k/task OpenCode ≈ 665–692k/task

Median time: Pi — 132.2 s OpenCode — 129.7 s

То есть OpenCode был на пару секунд быстрее по wall-clock, но Pi выполнил существенно больше задач и прогонял меньше context через модель. Caveat: Pi в этом benchmark использовал немного отличающийся reasoning setting/provider, поэтому считать его идеальным apples-to-apples benchmark нельзя. Но разница достаточно большая, чтобы обратить внимание.

Есть ещё свежий пользовательский тест Qwen 3.8 27B + llama.cpp, где обе программы подключены к одному и тому же llama-server. Автор пишет, что с Pi модель использует меньше tokens, меньше зависает и значительно позже делает compaction. При 100k context в его конфигурации OpenCode начинает compact примерно около 67k, а Pi — около 90k. Другой человек в комментариях независимо написал, что попробовал сначала OpenCode, затем Pi и Pi оказался заметно лучше с local Qwen.

Поэтому я бы сформулировал так:

Для frontier cloud models OpenCode и Pi — скорее вопрос UX/features. Для local LLM архитектура harness уже непосредственно влияет на качество модели.

У локальной модели ограничены intelligence, context и inference speed. Чем больше harness забивает ей prompt собственными инструкциями/tools/state, тем меньше остаётся «attention budget» для твоего кода и самой задачи.

Поэтому минимализм Pi здесь — не косметическая фича. Для local LLM это вполне реальное техническое преимущество.

Но OpenCode всё ещё имеет сильные стороны: гораздо больше возможностей out-of-the-box, LSP, web/search и более готовый workflow. Если правильно его настроить и убрать ненужный context/tool overhead, разрыв может сильно уменьшиться; есть пользователи, которые после настройки OpenCode получают на Qwen 3.8 более точные результаты, чем в Pi.

Так что мой вывод не «OpenCode плохой», а:

для локальных моделей я бы начинал с Pi, потому что он даёт модели максимально лёгкий agent loop и оставляет больше context самой задаче. А функциональность добавлял бы только тогда, когда она действительно нужна.

https://grigio.org/local-harness-benchmark-pi-coding-agent-vs-opencode/

https://www.reddit.com/r/LocalLLaMA/comments/1tjbhjk/same_task_in_githubcopilot_pi_claudecode_and/

gagarin0
() автор топика
Последнее исправление: gagarin0 (всего исправлений: 2)
Ответ на: комментарий от amd_amd

большого опыта у меня нет, но внезапно это удобно если нужно сделать «dashboard» экран, т.е. например где идет какой-то процесс (в моем случае обработка LLM запроса), и показываются метрики видеокарт и компьютера которые участвуют в его обработке, раньше мне постоянно приходилось делать alt-tab, или переключиться в другое tmux окно, а тут все как на ладони

gagarin0
() автор топика
Ответ на: комментарий от ethylkode

Интересно было бы узнать пайплайн автора топика.

локальным LLM я покрываю следующие задачи:

  1. администрация железа домашней лабы и k8s кластера (gitops репозиторий можно посмотреть тут https://github.com/metacoma/shitcluster2/pulls?q=is%3Apr+is%3Aclosed)

использую mcp агенты: grafana, k8s, hound, artifact_last_version

  1. задачи по разработке ПО для своих «пет» проджектов

  2. Задачи по работе

использую mcp агенты: zabbix, jira/confluence, grafana, codebase-memory-mcp

gagarin0
() автор топика
Ответ на: комментарий от Bad_ptr

«Я трогаю шар под определённым вектором и вызываю причину его качения, ура я сделал необративное действие, это шаротрон.»

Спасибо, прослезился :D

Gonzo ★★★★★
()
Ответ на: комментарий от UriZzz

Верно жрущая ванлервафля?

Особо не замерял, ноутбук тянет без проблем

Что за видюха, что не написали?

будьте внимательнее, видюхи есть в выоде neofetch

GPU: Intel Arc Graphics

gagarin0
() автор топика
Ответ на: комментарий от gagarin0

Да, это самое, я уже поправил сообщение… В глаза долблюсь:)

Железо мощное. Не знаю как по современным меркам, но по моим точно=)

UriZzz ★★
()
Последнее исправление: UriZzz (всего исправлений: 1)

rtx 4090 48gb mod

А расскажи подробности эксплуатации. Ну, покупка, корпус, шум... Я хочу сделать внешний бокс и подсоединять проводом, например...

Shadow ★★★★★
()
Ответ на: комментарий от gagarin0

но внезапно это удобно если нужно сделать «dashboard» экран

А у тебя экран тач или нет? В контексте скриншота имеет большое значение.

Shadow ★★★★★
()
Ответ на: комментарий от Shadow

А расскажи подробности эксплуатации.

Карты «турбины», это означает что в них стоят мощные кулеры которые ОЧЕНЬ громко работают, занимают 1 PCE слот, стоят в «серверной» в отдельной комнате, в загородном доме.

Ну, покупка, корпус

Покупка через авито, стоимость каждой 330к

Корпус взял LIAN LI LANCOOL III

Я хочу сделать внешний бокс и подсоединять проводом, например…

Если будешь рассматривать карты с турбиной, то их нужно ставить в отдельную нежилую комнату.

А у тебя экран тач или нет?

экран обычный

gagarin0
() автор топика
Ответ на: комментарий от gagarin0

рассматривать карты с турбиной

Создание собственной отдельной системы обдува не рассматривал?

А ещё - они в паре с одной моделью работают, или для разных?

Shadow ★★★★★
()
Последнее исправление: Shadow (всего исправлений: 1)
Ответ на: комментарий от Shadow

Создание собственной отдельной системы обдува не рассматривал?

точно нет, т.к. знал на что иду и где буду размещать

А ещё - они в паре с одной моделью работают, или для разных?

вначале экспериментировал, qwen3.6-35-a3b и qwen3.6-27b размещал на отдельных картах.

теперь использую deepseek v4 0731 IQ3_XXS3 и qwen3.8-27b Q8 с контекстом в 512к, поочередно, в зависимости от задачи (на скриншоте ты можешь увидеть сколько у меня «жрет» ресурсов qwen3.8-27b с контекстом в 512k, с контектом в 256k его можно уместить на одной карте)

gagarin0
() автор топика
Последнее исправление: gagarin0 (всего исправлений: 1)

pi.dev очень понравился. простой понятный.

ggrn ★★★★★
()
Ответ на: комментарий от ethylkode

На настолько развернутый ответ я даже не рассчитывал. Благодарю.

Решение весьма достойное было расписано, да. Но посмотри, возможно, для твоих задачь будет дешевле взять mac studio. А, учитывая, что, в дальнейшем, решение на маках, масштабируется через кластер по тб, то… Но надо учитывать задачи конечно. Может и не подойти.

DrRulez ★★★★★
()

На самом деле интересный проект. С удовольствием бы протестировал его, но пока не имею технической возможности. Успехов в разработке!

nuxster ★★★★
()
Ответ на: комментарий от DrRulez

Да, я рассматривал варианты с mac studio. Версия 64gb стоит 600, она очень заметно тише и дешевле в эксплуатации, но памяти доступно примерно столько же, а мощность ниже. Версия на 512гб уже больше 4млн.

У автора топика, как я понимаю, китайская версия rtx4090, она же rtx4090d. Штука интересная, но весь конфиг жрет немеренно. По моим подсчетам около 120 в год.

Я пока думаю.

ethylkode
()
Ответ на: комментарий от ethylkode

Да, я рассматривал варианты с mac studio. Версия 64gb стоит 600, она очень заметно тише и дешевле в эксплуатации, но памяти доступно примерно столько же, а мощность ниже. Версия на 512гб уже больше 4млн.

так соедени 2 штуки по тб в кластер. память для моделей будет суммироваться. если не сильно критична скорость, то решение более чем жизнеспособное. до 5 штук в кластер объеденить можно. а по цене… ну не обязательно-же в ресторе покупать :)

DrRulez ★★★★★
()
Последнее исправление: DrRulez (всего исправлений: 1)
Ответ на: комментарий от ethylkode

mac studio

rtx4090d. Штука интересная,

перед вами стоит выбор, если у вас есть отдельное помещение где гул куллеров никому не будет мешать, я бы рекомендовал покупать карты (у них и производительность выше, я про decode t/s и prefill t/s), и продать их потом будет намного проще + вариативность конфигурации, можно приобрести с материнскую плату с заделом на будущее и постепенно добавлять карты

По моим подсчетам около 120 в год.

вот этого не понял, если вы про энергопотребление, то карты максимально «жрут» 450w, но я использую LACT (underpower + undervoltage + куллер curve), в итоге теряю 5% «мощности», но жрут ресурсы они заметно меньше.

Так же, обращаю ваше внимание что где-то в конце весны, умельцы научились «разблокировать» карты nvidia 120 cmp (которые стоили 80-100k, сейчас уже больше) до 60-80гб VRAM, поизучайте тему (есть нюансы)

gagarin0
() автор топика
Последнее исправление: gagarin0 (всего исправлений: 1)

Больше бы скриншотов, а так не понять нужно оно или нет. А лучше видео. С одной стороны поставить два окна рядом под углом могло бы пригодиться. Но нужно тестить удобство работы с ними мышкой. А вот то, что на вашем скрине 4 свистелки и перделки - смыла нет, только перед шпаной выёживаться.

foror ★★★★★
()
Ответ на: комментарий от hobbit

Так компиз был популярен, когда в параллельном мире была виста. Не знаю, кто у кого позаимствовал идеи, но, как в винде тенденция поутихла, компиз тоже стал непопулярен.

Wapieth ★★
()
Ответ на: комментарий от Bad_ptr

Новый фундамент интерфейса, всплывающие окна, тонущие двери, мастерская идей

…, покосившаяся крыша, облупившийся потолок и много других «инсталляций» :)

My_quest ★★★★★
()
Ответ на: комментарий от I-Love-Microsoft

Аффтар не он, а ИИ. Он — промт инженер (есть подсказка — промты может писать другая модель, у ИИ с этим лучше чем у людей)

peregrine ★★★★★
()
Ответ на: комментарий от ethylkode

Bonsai - это переформатированный qwen.

Код пишет лучше, потому что 27b.

gunt3er
()
Последнее исправление: gunt3er (всего исправлений: 3)
Ответ на: комментарий от DrRulez

И даже по разделам на лоре видно: макском писал недавно по поводу web-development, что тот раздел был создан (его уже нет) для того, чтобы веб-макаки не оскорбляли своим присутствием посетителей раздела development.

А сейчас мы все видим есть раздел /ai/ и в него тоже нейрослоп из dev можно перемещать.

firkax ★★★★★
()
Ответ на: комментарий от firkax

нейрослоп

Зачем эти англицизмы? Пиши как есть: очередной иипомойщик навалил недоделанные иипомои. Так же лучше, правда?
Кстати, ТС давно нужно забанить за регулярные иипомои.

dataman ★★★★★
()

Есть такая штука «гипергеометрия». Это когда на десктопе становится «бесконечным» пространство (как во всяких рисовалках с «бесконечным холстом»), но за счет «проекции бесконечной плоскости на сферу лучами из центра сферы последующей проекцией этой сферы на ее секущую» мы получаем возможность «видеть все» (обычно «с учетом DPI» ограничивается это преобразование в разумных пределах). То что в центре видно практически без искажений, то что по краям «просто видно что оно есть» , «фокус» смещается путем перемещения «точки контакта сферы с холстом».

psv1967 ★★★★★
()
Ответ на: комментарий от psv1967

да, вы правильно поняли куда развивается этот прототип.

gagarin0
() автор топика
Ответ на: комментарий от bernd

такое то было, а вот обещанных массовых шлемов три де даже сейчас нет, а интерфйес вот в таком виде (без «сложных перепроекций») на «плоском» дисплее крайне увы «в триплексах мелькает небо и стерня»(С).

psv1967 ★★★★★
()
Для того чтобы оставить комментарий войдите или зарегистрируйтесь.