LINUX.ORG.RU

Релиз Tewi 3.0.0, текстового интерфейса для управления torrent-клиентами

 , , , ,


1

3

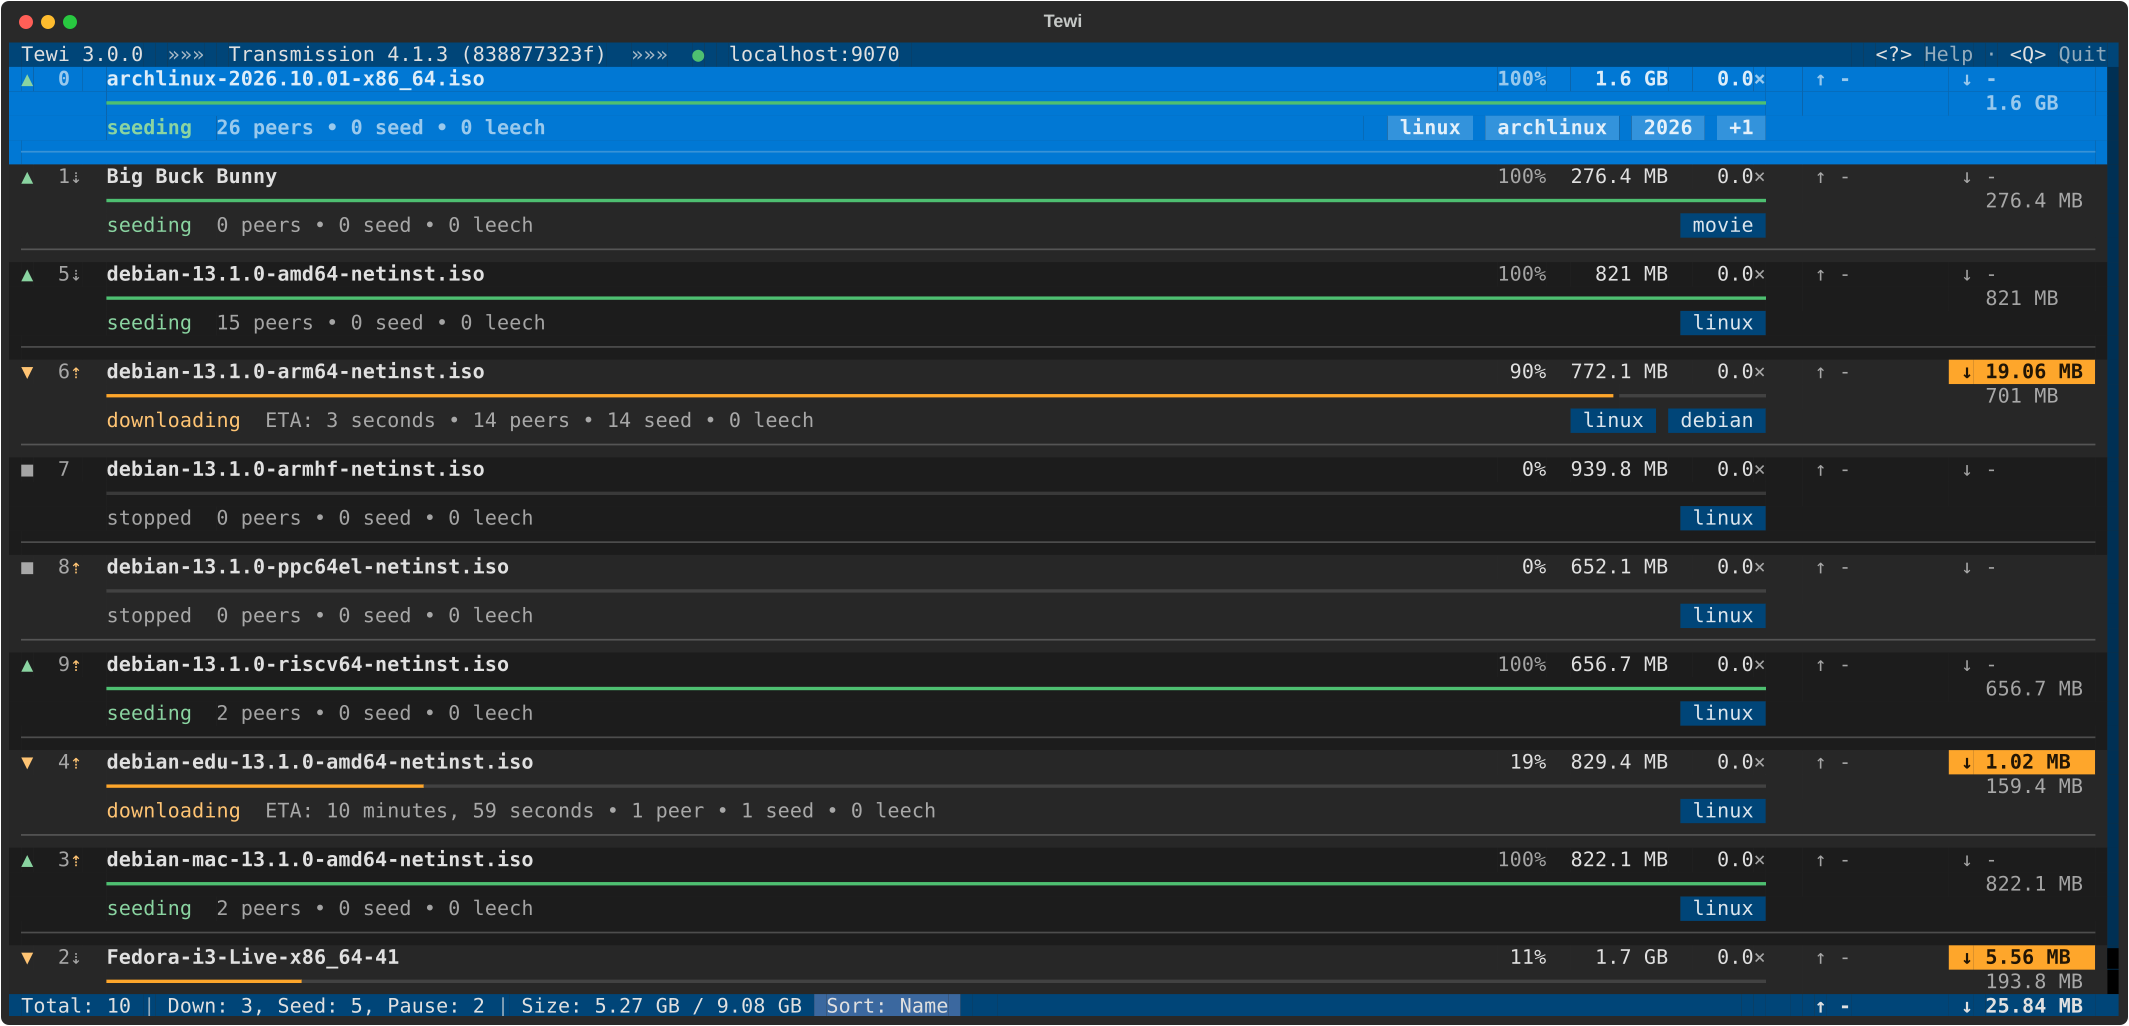
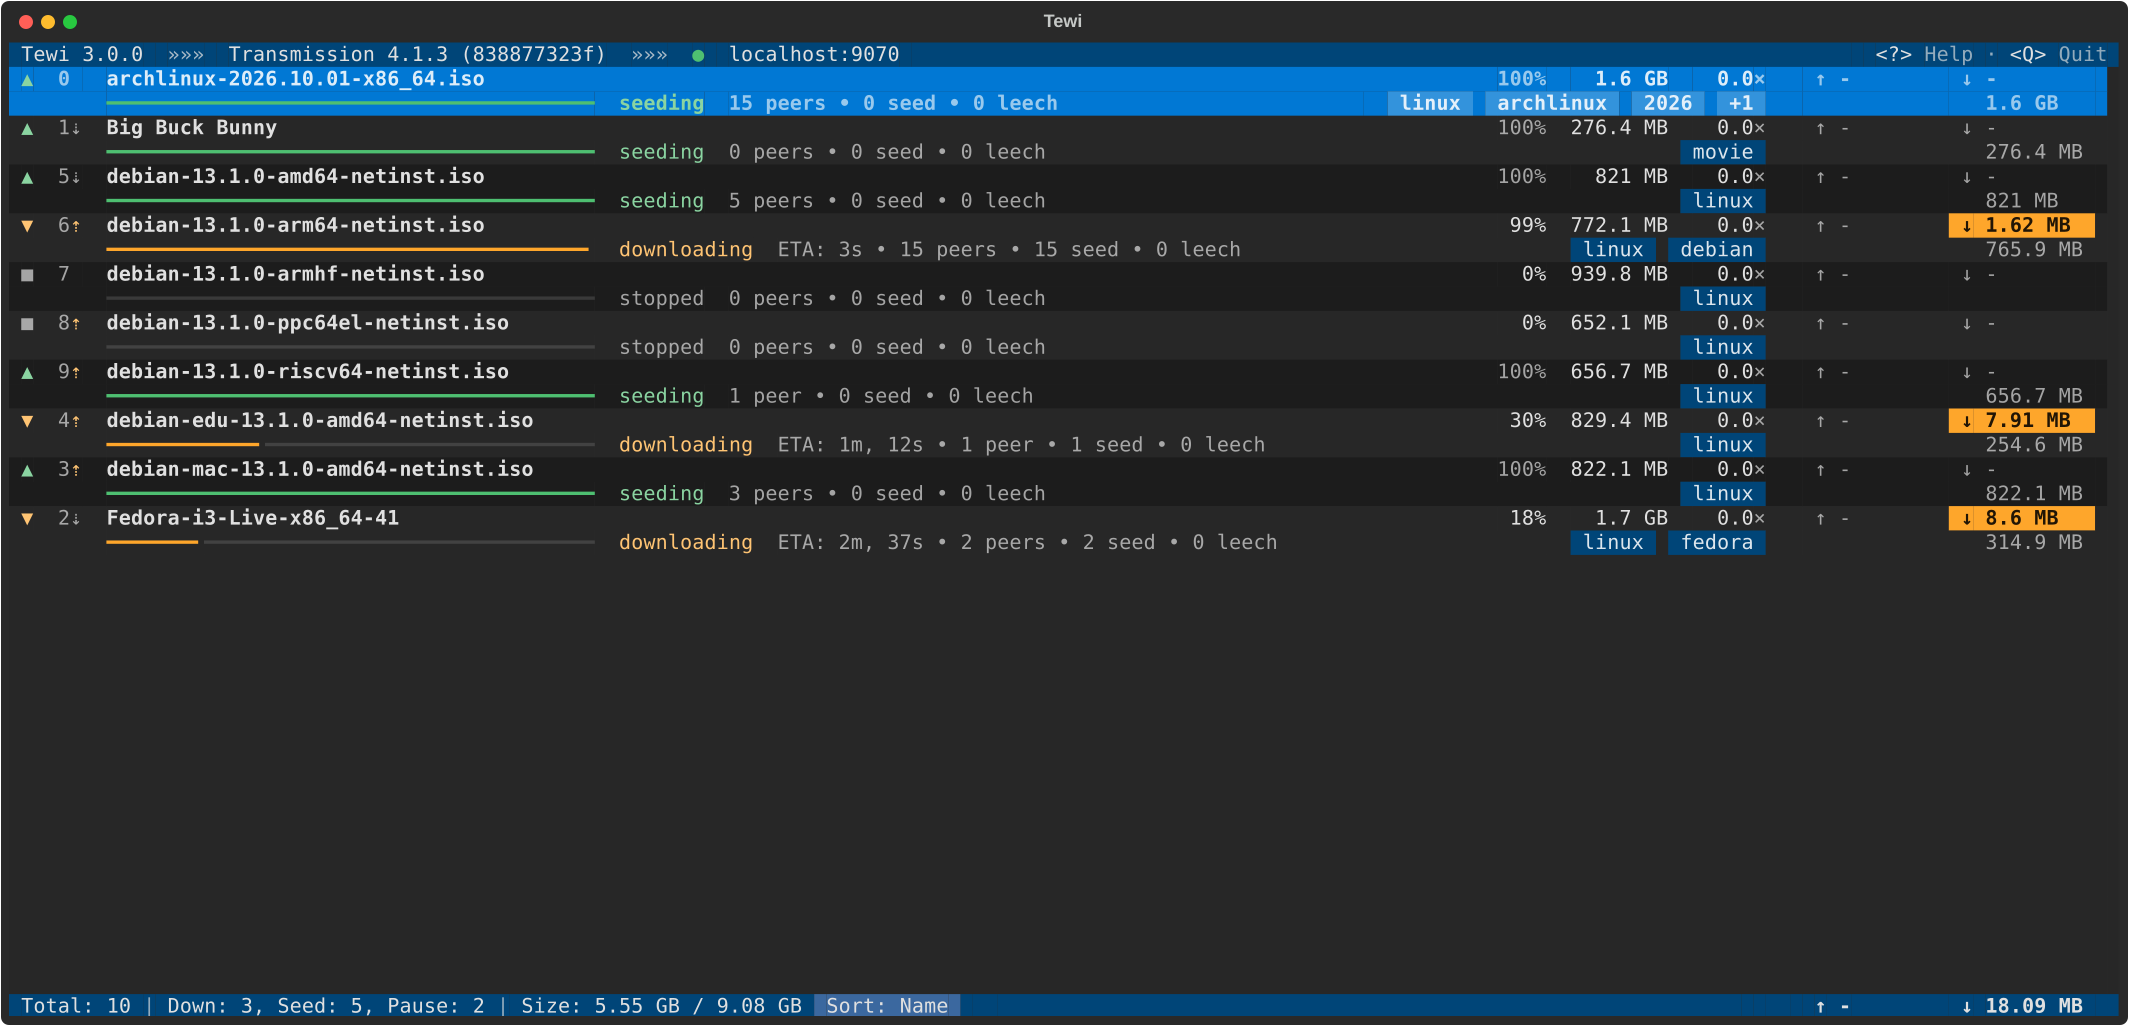
Состоялся выпуск Tewi 3.0.0 — консольного приложения с текстовым интерфейсом (TUI) для управления BitTorrent-клиентами. Программа позволяет подключаться к демонам Transmission, qBittorrent, Deluge и rTorrent, просматривать и управлять списком торрентов, добавлять новые закачки, выполнять поиск по популярным трекерам. Поддерживаются различные режимы отображения (карточки, компактный, однострочный), просмотр детальной информации о торрентах (файлы, трекеры, пиры), управление категориями и метками, переключение альтернативных лимитов скорости.

Интерфейс построен на базе библиотеки Textual. Код написан на Python и распространяется под лицензией GPLv3+.

Основные изменения с версии 2.0.0:

Поддержка клиентов:

  • Добавлена поддержка rTorrent (0.9.7 и новее): подключение напрямую через SCGI или через XML-RPC поверх HTTP (при указании --path). Поддерживаются почти все возможности остальных клиентов, кроме переключения альтернативных лимитов скорости. Категории хранятся в формате ruTorrent, поэтому совместимы с ним.

Интерфейс и управление торрентами:

  • Список торрентов переписан на Textual Line API: отрисовываются только видимые строки, поэтому загрузка, обновление и прокрутка заметно ускорены. Размер страницы по умолчанию вырос с 30 до 1000, дизайн списка обновлён.
  • Добавлена постраничная и полустраничная навигация по списку торрентов (Ctrl+F/Ctrl+B, Ctrl+D/Ctrl+U).
  • Добавлена фильтрация торрентов по имени (F) и новые фильтры по статусу: Checking и Incomplete.
  • Добавлена возможность добавить торрент по его info-хешу.
  • Добавлен множественный выбор файлов торрента для групповой смены приоритета.
  • Добавлено открытие файлов из детальной информации о торренте (Enter).
  • Добавлено отображение общих лимитов скорости клиента (в дополнение к альтернативным).
  • В строке заголовка отображается статус подключения к клиенту (отображается потеря связи с демоном).
  • Добавлен выбор тем оформления Textual: dracula, monokai, nord и др. (T, опция --theme, полный список: --list-themes).

Конфигурация и командная строка:

  • Поддержка переменных окружения (${VAR_NAME}) в файле конфигурации (например, для хранения паролей и API-ключей вне конфига.
  • Генерация скриптов автодополнения для bash, zsh и tcsh (--print-completion); в пакет PyPI включено готовое автодополнение для Bash.

Поиск торрентов:

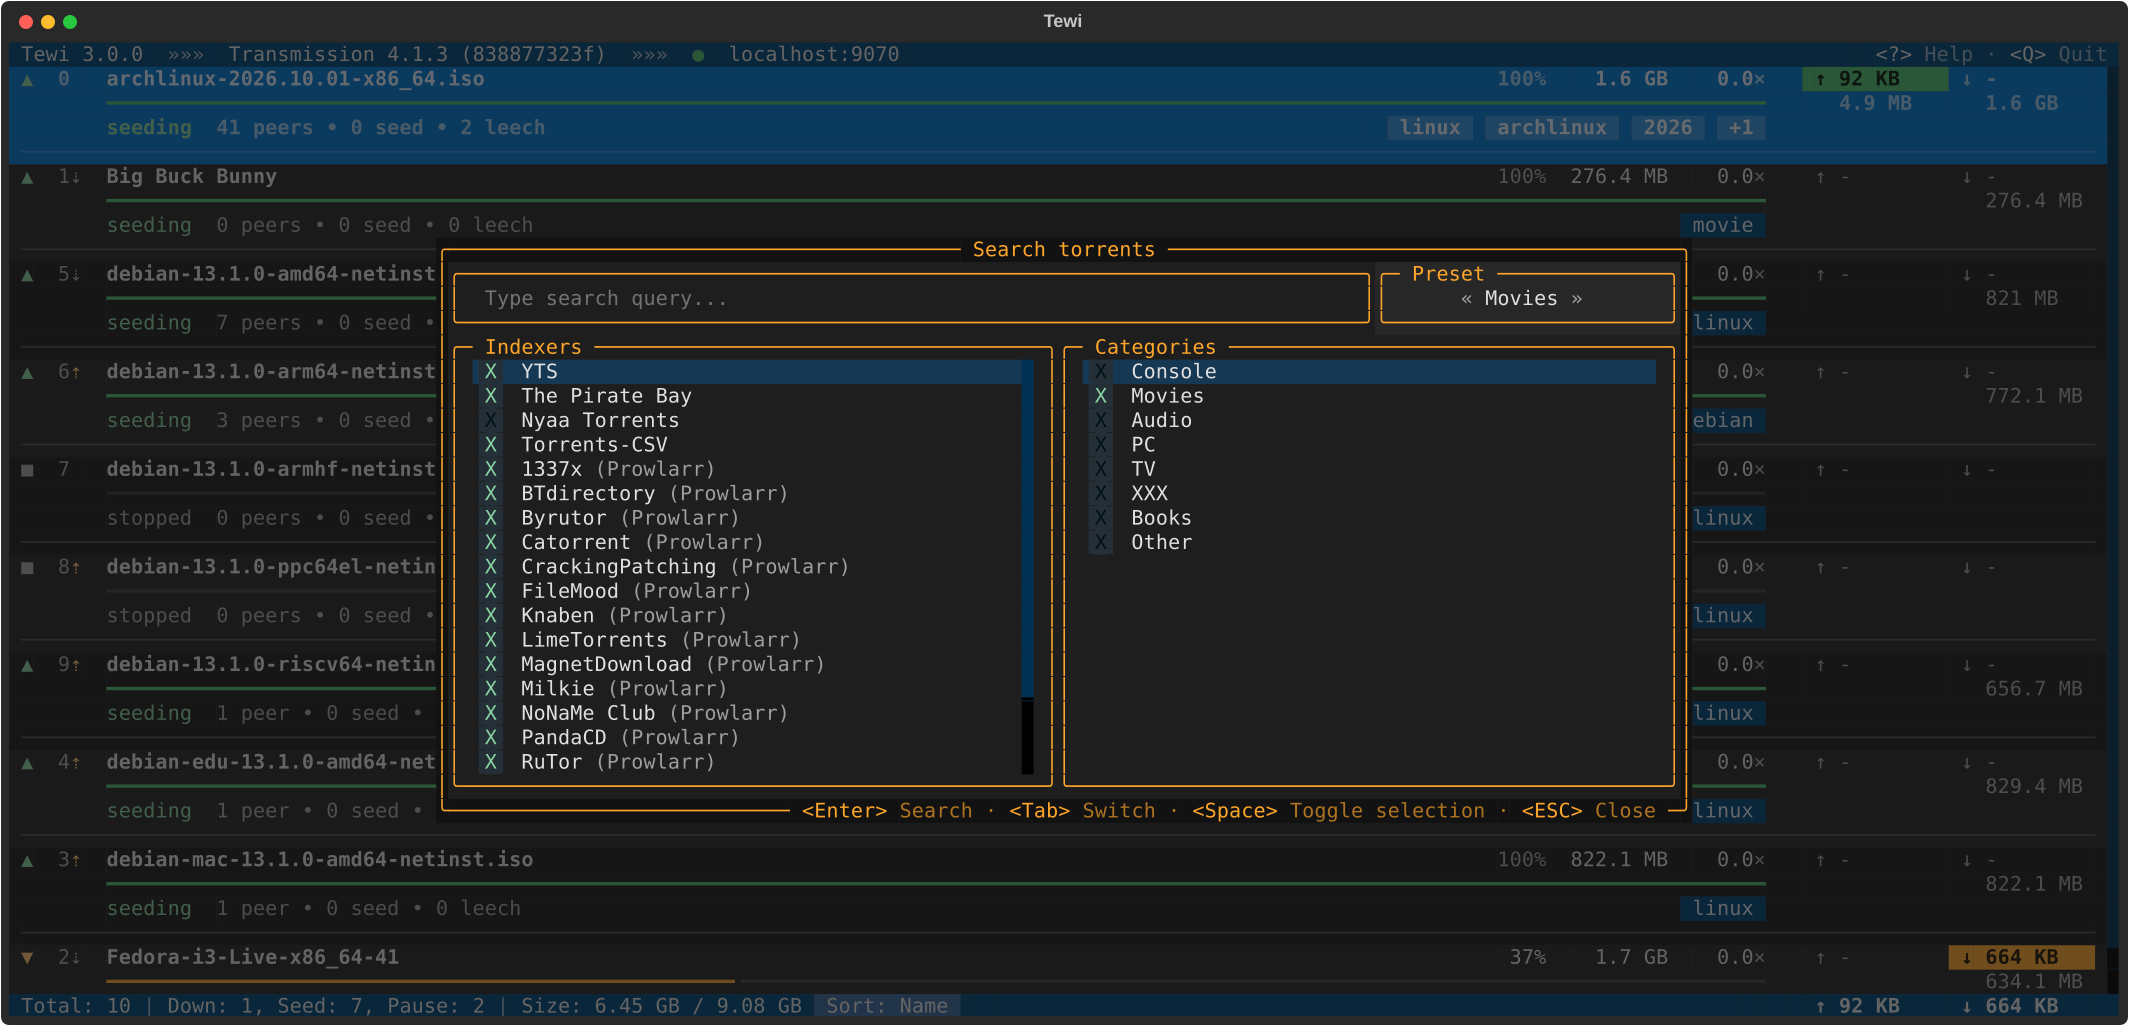
  • Добавлена поддержка Prowlarr: поиск по всем индексаторам сразу или выбор отдельных (--prowlarr-multi), индексаторы можно указывать в пресетах поиска.
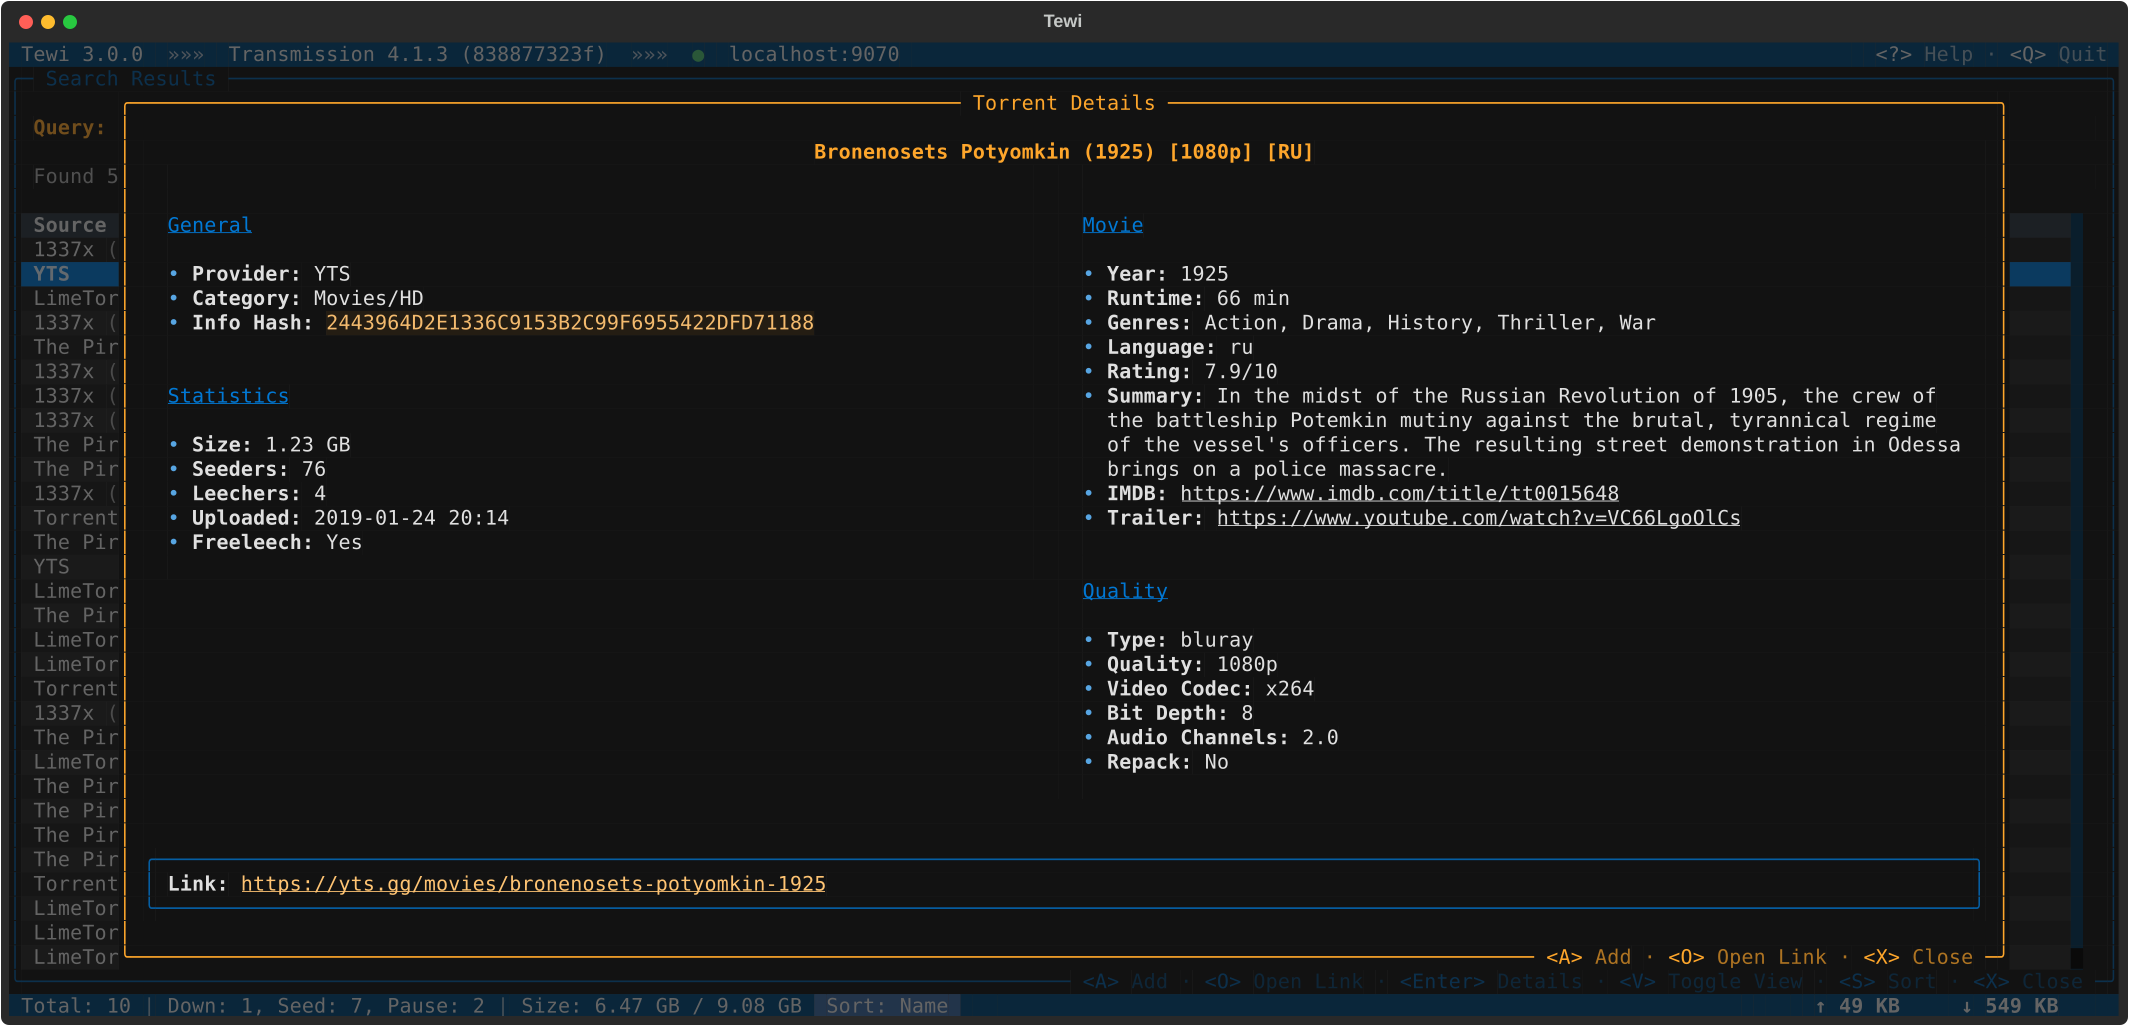
  • Добавлена поддержка Bitmagnet: self-hosted BitTorrent-индексатора и DHT-краулера. Поиск идёт через его GraphQL API, в деталях отображаются метаданные контента: тип, название, эпизоды, разрешение, кодек и источник видео.
  • Добавлены пресеты поиска - именованные комбинации поисковых провайдеров и категорий ([search.preset.NAME]).
  • Добавлена сортировка результатов поиска по различным атрибутам (s).
  • Добавлен компактный режим отображения результатов поиска с минимумом столбцов (V).
  • Отображается число скачиваний и флаг freeleech; раздачи без сидов можно скрывать (--search-hide-zero-seeders).
  • Поиск запоминает последние выбранные индексаторы и категории (W).

Установка

Внимание: пакет в PyPI переименован из tewi-transmission в tewi-torrent.

Для установки можно использовать pipx, pip или uv:

$ pipx install tewi-torrent
$ pip install tewi-torrent
$ uv tool install tewi-torrent

>>> GitHub


Проверено: CrX ()
Последнее исправление: CrX (всего исправлений: 4)
Ответ на: комментарий от shaplov

Ясно, Вы вот про что:

(source ./test_dir/venv/bin/activate; python ./test_dir/target_script.py;deactivate)
Goncha!

И ведь всё правильно написали, даже спорить не хочется. Но мы ж на форуме, так что почему бы и нет.

Я чистым venv’ом последний раз пользовался никогда. (Правда, сегодня впервые его потыкал). Но чует моя чуйка, он не менялся со времён второго питона, т.е. почти сразу как вымерли динозавры. А потому вероятность его изменения оцениваю также, как возрождение динозавров в виде зомби. Т.е. почти никакую. Но на случай, если всё же придётся отстреливаться при динозавро-зомби-апокалипсисе, сдеалал бы что-то типа:

PYTHON='./test_dir/venv/bin/python'
TARGET_SCRIPT=test_dir/target_script.py

$PYTHON $TARGET_SCRIPT

И успокоился. Чтобы можно было поправить сборку в перерывах между передёргиванием затвора.

bbc69
()
Ответ на: комментарий от bbc69

(source ./test_dir/venv/bin/activate; python ./test_dir/target_script.py;deactivate)

deactivate можно не делать. Выйдя из скобок bash забудет обо всех переменных окружения. То что в скобках на самом деле выполняется в форкнутом баше.

Но чует моя чуйка

А вот моя – не чует. Кто знает что придет в голову <s>пчелам</s> питон-программистам.

shaplov ★★★
()
Последнее исправление: shaplov (всего исправлений: 2)
Ответ на: комментарий от adn

слушай, тут PostgreSQL на rust переписали…

Во что говорит про это сам клод:


Рекомендации по переписыванию pandas на Perl (силами Claude Code)

1. Цель и границы

  • Полный клон pandas нереалистичен: огромный API, тысячи краевых случаев, годы работы.
  • Реалистичная цель: небольшая библиотека на Perl, покрывающая только нужные вам операции.
  • До начала работы выпишите список операций pandas, которые реально используются (чтение CSV, groupby, merge, сортировка и т. д.).

2. Сначала проверить готовые решения

Часть задач pandas закрывается без программирования:

ЗадачаИнструментDebian-пакет
Фильтры, группировки, агрегации над CSV/JSONMillermiller
Быстрый разбор и статистика CSVcsvkitcsvkit
SQL-запросы к табличным даннымSQLitesqlite3, libdbd-sqlite3-perl
Числовые массивы в PerlPDLlibpdl-perl

Установка:

apt-get install miller csvkit sqlite3 libdbd-sqlite3-perl libpdl-perl

Проверьте также существующие модули CPAN (Data::Frame и др.): они могут быть сырыми или малоактивными, оценить актуальность нужно до начала разработки.

3. Архитектурные решения

  • Хранилище: колоночное. Числовые столбцы на PDL, строки и даты в обычных Perl-массивах.
  • Пропуски: единая явная семантика NA (например, undef для строк и NaN/bad value в PDL). Зафиксировать правила в документе до написания кода.
  • Индексы: на первом этапе только целочисленный индекс по умолчанию; MultiIndex и автовыравнивание по меткам отложить.
  • Ввод/вывод CSV: Text::CSV_XS (libtext-csv-xs-perl).
  • Даты: Time::Piece или DateTime (libdatetime-perl).
  • Производительность: чистый Perl на больших таблицах медленный; критичные места выносить в PDL, XS только при доказанной необходимости.

4. Поэтапный план

Этап 1. Минимальное ядро (несколько дней итераций)

  • Структура DataFrame (столбцы, типы, количество строк)
  • Чтение и запись CSV
  • Выборка столбцов и строк, булевы маски
  • Сортировка
  • groupby с базовыми агрегациями (sum, mean, count, min, max)
  • merge (inner, left)

Ориентир: 3–6 тыс. строк Perl.

Этап 2. Расширение (недели)

  • Пропуски (fillna, dropna, isna)
  • Даты и строковые операции
  • pivot, melt
  • Оконные функции (rolling)

Этап 3. Не делать без веской причины

  • MultiIndex
  • Полное выравнивание по индексам
  • Совместимость «любой скрипт на pandas работает без изменений»

5. Тестирование: эталонный подход

Главный риск: код выглядит правдоподобно, но расходится с pandas на краях (NA, типы, сортировка, порядок групп).

  1. Подготовить набор входных CSV и сценариев операций.
  2. Получить эталонные результаты настоящим pandas (apt-get install python3-pandas) и сохранить в CSV/JSON. Это одноразовый шаг, единственное место, где Python оправдан; при желании эталоны можно получить и через Miller/SQLite для простых операций.
  3. Написать на Perl тесты (Test::More, запуск через prove), сравнивающие результат с эталоном.
  4. Дальше Claude Code работает в цикле: код, prove, исправление, повтор.

6. Как работать с Claude Code

  • Давать задачи маленькими модулями, а не «перепиши pandas».
  • В начале проекта создать файл CLAUDE.md с описанием: архитектура, семантика NA, соглашения по именам, правила тестов, запрет на Python в самой библиотеке.
  • Для каждого модуля: сначала тесты по эталону, затем реализация.
  • Периодически просить рефакторинг и ревью, чтобы контекст не раздувался.
  • Результаты проверять человеком, особенно работу с пропусками, типами и сортировкой.

7. Риски

  • Расхождения в семантике, незаметные без эталонных тестов.
  • Недостаточная скорость на больших данных.
  • Раздувание контекста при работе с большой кодовой базой.
  • Соблазн «довести до полной совместимости», что превращает проект в бесконечный.

8. Критерий готовности

Библиотека считается готовой, когда проходит эталонные тесты на вашем списке операций и покрывает реальные сценарии, ради которых затевался проект.


Т.е. если задача сделать pandas-подобный инструмент для новых проектов, без идеальной совместимости в краевых случаях, то все вполне реально.

shaplov ★★★
()
Последнее исправление: shaplov (всего исправлений: 1)
Ответ на: комментарий от Bakamashine

Ну, я бы пользовался, если бы не надо было через pip ставить (я с ним когда-то не сошелся в чем-то, а системный пакетный менеджер этого пакета не находит).

  • Для вебморды надо запускать браузер.
  • Мне приятно работать в эмуляторе терминала.
  • К предыдущему пункту - UI заточен на управление без использования мыши.
  • Можно запускать на машине, к которой подключился по ssh.
captain_cat ★
()
Ответ на: комментарий от shaplov

Зачем ты ЭТО сюда запостил? Лучше почитай что такое pandas. А нейронка с любым твоим утверждением согласится. Да, и почему именно perl?

adn ★★★★★
()
Ответ на: комментарий от shaplov

ващет ужо polars а по хорошему есть более лучший duckdb

ибо у пандаса тот ещё идиосинкразийный интерфейс - когда её Уэс Маккини лепил кстати почти как Уолл с перловкой очень под свои привычки - как результат у этой панды куча корнер кейсов

qulinxao3 ★☆
()
Ответ на: комментарий от qulinxao3

ващет ужо polars а по хорошему есть более лучший duckdb

Я не особо в теме к сожалению, но вроде duckdb - это sqlite на стероидах и всё на sql запросах работает.

А polars да, слышал, но он же тоже только под python.

Можно тогда целый язык R вспомнить. Но мысль была в другом - python своим синтаксисом максимально удобен для таких структур как data frame. В других языках так лаконично не получится.

у пандаса тот ещё идиосинкразийный интерфейс

Это из-за того самого языка R, функциональность которого пытались повторить.

adn ★★★★★
()
Ответ на: комментарий от adn

duckdb (по евангализирую на почве их промоушена) - это не только cli (ну и tui и repl) фильтр оно по модно молодёжному современному какчественно с python (в частности) интеропится в обе сторону

в питоне можно import duckdb потом в частности sql-магию движка утки а ответ можно как датафрейм панды либо датафрейм полярки - ну и наоборот можно сиквилить над датафреймами что панды что полярки - типо прям над ними без телефона без смс

ну и хранимые(точнее пользовательские U(ser)D(efined)F(unction) ) функции можно на в частности питоне писать которые дёргать из запроса - типо делкларативность на внешнем sql а байтообмазывание на какой императивщине(список прилагается) - и в целом у утки достаточно современный набор батареек

  • про R нотацию как инструмент мЫсля Айверсона и его apl как нотацию для всего проекта ибэмэ360

++ эээ я «кущать не смог» пандас(только какую самую простоту агрегатную) в этом смысле либо sql либо ага R - более доменно - адекватны

пандас выстрелил ( ну Уэс реально крут ) - ибо всё увеличивающаяся когорта датасатанистов не так поголовна в Эр а питон реально басяк современности

qulinxao3 ★☆
()
Последнее исправление: qulinxao3 (всего исправлений: 3)
Ответ на: комментарий от shaplov

deactivate можно не делать.

Ну ок.

Кто знает что придет в голову пчелам питон-программистам.

Нет, всё-таки у Вас какая-то фиксация на питонистах.

bbc69
()
Ответ на: комментарий от bbc69

Кто знает что придет в голову пчелам питон-программистам.

Нет, всё-таки у Вас какая-то фиксация на питонистах.

Больше, у меня фиксация на идиотах. Большую личную неприязнь испытываю.

А если серьезно. Давай еще раз повторим: виртуальное окружение это поддерево на диске и набор переменных окружения. Такой контракт. Надо следовать этому контракту, а не тому что по этому контракту давали 10 лет назад. Всех нюансов не являясь узким специалистом не учтешь, всех будущих изменений не предскажешь. Мое решение строго следует этому контракту. Ваше делает дополнительные предположения, из-за которых что-нибудь может пойти не так, либо в краевых случаях, либо в будущем.

shaplov ★★★
()
Последнее исправление: shaplov (всего исправлений: 2)
Ответ на: комментарий от shaplov

ну слу - вирт_окр это рудимент и атавизм нелёгкого пути пипона к успеху

как до сих пор теже #include в плюсах без них было бы лучше

как тот же docker который виртуалит над итак виртуалкой (а всякая оська это виртуальная машина над настоящей обобщённой через дрова железкой)

трудность именно в хрупкости и любви к хакам(коротким путям в тех или иных метриках)

когда опираешся на реализацию(включая всякие недокументированности) оно упрочняет привязку - и опять дилема где выбрать баланс «компиляции(вычисление) времени сборки VS вычисление скомпилированой уже VS вычисление самой формулы прежде чем вычислить значение только что вычисленной формулы и всё это (как минимум двух-уровневое вычисление)в рантайме»

+иишная нейрудиция:

Закона Хайрама: «При достаточном количестве пользователей API не важно, что зафиксировано в контракте: любой аспект поведения системы будет кем-то использоваться»

qulinxao3 ★☆
()
Последнее исправление: qulinxao3 (всего исправлений: 1)
Для того чтобы оставить комментарий войдите или зарегистрируйтесь.