LINUX.ORG.RU

В процессорах Loongson для Linux-систем обнаружили аппаратную утечку данных из L1-кеша

 , ,

В процессорах Loongson для Linux-систем обнаружили аппаратную утечку данных из L1-кеша

2

1

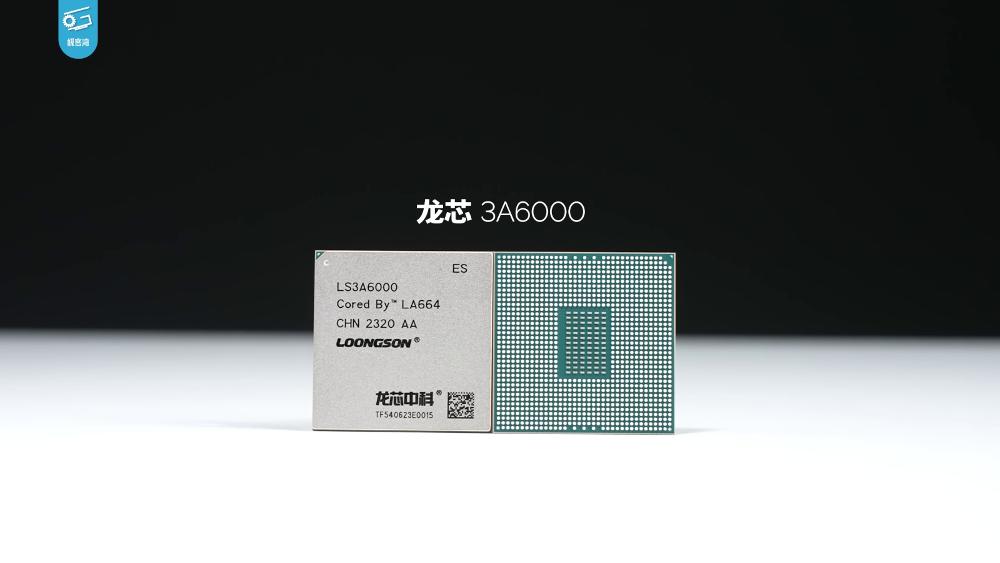
Исследователи из немецкого Центра информационной безопасности имени Гельмгольца CISPA представили на конференции USENIX Security 2026 аппаратную уязвимость LoongLeak, обнаруженную в китайских процессорах Loongson 3A5000 и Loongson 3A6000. Непривилегированная программа может использовать её для извлечения оставшихся в кеше первого уровня данных других процессов, ядра операционной системы и гипервизора. Атака также возможна из контейнера или гостевой виртуальной машины.

Практическое значение уязвимости связано прежде всего с Linux и другим свободным ПО. Для LoongArch существует отдельный порт в основном ядре Linux, а Debian уже включил loong64 в число официальных архитектур с планом выпуска в составе Debian 14. Поддержку архитектуры также развивают другие Linux-дистрибутивы и проекты открытого системного ПО.

Официальной версии Windows для LoongArch при этом нет. В перечнях поддерживаемых Microsoft процессоров для Windows 11 фигурируют решения AMD, Intel и Qualcomm, а установочные образы операционной системы выпускаются отдельно для x64 (microsoft.com) и Arm64. Поэтому компьютеры и серверы на Loongson на практике ориентированы прежде всего на Linux и открытый программный стек. Сама LoongArch, однако, является собственной архитектурой Loongson, поэтому речь идёт именно об открытости используемых операционных систем и программного окружения, а не о полной открытости процессора по модели RISC-V.

LoongLeak связана с особенностями выполнения инструкции FLD.S. В соответствии с руководством по архитектуре LoongArch она загружает из памяти 32-разрядное значение в 64-разрядный регистр с плавающей точкой, оставляя его старшие 32 бита в «неопределённом» состоянии. При использовании 256-разрядного векторного расширения LASX неопределёнными оказываются уже 224 бита, или 28 байт.

Исследователи установили, что в этих разрядах могут появляться не случайные значения, а данные, оставшиеся после предыдущих операций в кеше L1D. Атакующий способен подготовить внутреннее состояние процессора и выбирать нужный набор кеша, смещение внутри кеш-линии и один из её путей. Полученная информация непосредственно попадает в архитектурно доступные регистры.

Этим LoongLeak отличается от Spectre, Meltdown и большинства классических атак по сторонним каналам. Для извлечения информации не требуются спекулятивное выполнение, высокоточный таймер или анализ задержек обращения к памяти. Авторы работы классифицируют LoongLeak как архитектурную ошибку: процессор возвращает посторонние данные в результате штатного выполнения инструкции.

В лабораторных условиях средняя скорость извлечения информации достигла 315,8 Мбайт/с, а необработанный поток данных — 483,3 Мбайт/с. В более реалистичных сценариях, требующих переключения процессов или виртуальных машин, скорость снизилась до 6,2 и 4,5 Мбайт/с соответственно. Для проведения атаки злоумышленнику необходимо запустить непривилегированный нативный код на уязвимой системе, причём атакующий и жертва должны последовательно или одновременно выполняться на одном физическом ядре.

Для демонстрации последствий исследователи извлекли из памяти ядра Linux полный 512-разрядный мастер-ключ тома, зашифрованного при помощи LUKS и AES-XTS. В другом эксперименте с Loongson 3A6000 через общий для двух SMT-потоков кеш удалось получить первые 32 байта записи пользователя root из /etc/shadow, включая полную соль и девять байт хеша пароля.

LoongLeak также позволила получить значения ASLR и stack canary, используемые для усложнения эксплуатации ошибок памяти. Кроме того, исследователи продемонстрировали возможность пересечения границ виртуализации: код внутри гостевой системы способен извлекать данные другой виртуальной машины или самого гипервизора. Это делает проблему особенно существенной для многопользовательских серверов, облачных платформ и систем виртуализации на базе Linux и KVM.

Полностью исправить уязвимые процессоры обновлением Linux, микрокода или другого программного обеспечения нельзя, поскольку первопричина находится в аппаратной реализации. В качестве временной защиты предлагается вытеснять содержимое L1D-кеша несекретными данными при переходе из ядра в пользовательское пространство. В тестах исследователей максимальное замедление от такой меры составило 1,4%, а в большинстве тестов падение производительности не превышало 0,1%.

На Loongson 3A6000 дополнительно необходимо отключить один логический поток каждого физического ядра, фактически отказавшись от SMT. Другой вариант — перехватывать и программно эмулировать инструкции с плавающей точкой, LSX и LASX, однако в тестах с интенсивным использованием плавающей арифметики это приводило к замедлению в 10–21 раз.

Исследователи сообщили Loongson об уязвимости 23 июля 2025 года. Компания воспроизвела проблему и попросила сохранить сведения о ней в тайне на один год. Впоследствии производитель устранил утечку в новой аппаратной ревизии Loongson 3A6000. Владельцам ранее выпущенных 3A5000 и 3A6000 остаётся использовать программные меры снижения риска либо заменить процессор. Специальных средств, позволяющих обнаружить уже проводившуюся атаку LoongLeak, пока нет.

>>> Источник

★★★★★

Проверено: cetjs2 ()
Последнее исправление: cetjs2 (всего исправлений: 1)
Ответ на: комментарий от firkax

Нет, они не «знали про багу», они считали это фичей и сделали специально, см. выше.

Так я и посмотрел выше, где вы пишете, что это они о производительности думали. Нет, производительность тут не при чём: доп такт для зануления не нужен.

anonmyous ★★★
()
Ответ на: комментарий от firkax

Скорее всего причина была именно в этом, и там действительно вообще не подумали о том, что отдавать мусор из левого кеша - это утечка данных.

То есть, у них нет ни здравого смысла, ни желания ознакомиться с аналогичными проблемами, типа espfix/espfix64? Крайне странная теория, всё же проц не дворники клепают.

anonmyous ★★★
()
Ответ на: комментарий от firkax

так у них данные с прошлой операции в защелках висели и инструкция их читала. защелки прямо в кэше, потому что массив регистров Nх64бит обладает поганой особенностью. даже двумя.

  1. во-первых емкость подключенных транзисторов к линии - N штук. очень быстро сбрасывают скорость.

  2. во-вторых, они текут. Ion/Ioff ~ 100, и падает с уменьшением техпроцесса. Поэтому для N=128 и 90nm уже ток всех закрытых транзисторов больше тока открытого.

поэтому большие SRAM рубят на мелкие блоки, по 16-32 элемента. и их данные защелкивают прямо где-то рядом с этими блоками. а из защелок уже выбирают то что надо. можно даже на двойной частоте.

вот из этих защелок и потекло.

ckotctvo
()
Ответ на: комментарий от anonmyous

Это не espfix. Там была ошибка уровня микрокода. Вернее даже не так: в х86 при 32битной записи в 64битный регистр верхние 32бита нулятся, а при записи 16бит в 32битный - нет. Надо было нулить их и писать 16 бит. Вообще кстати непонятно, почему IRET так себя вел - ну похерь на стэке лишние биты в ноль и retайся.

А тут прям четко схалявили. Они походу решили в экономию энергии поиграть: инструкция читает данные из одного банка где проблем нет. Там 2 этапа, поскольку физически нельзя в один шаг прочитать из большого SRAM-файла. Я чуть выше расписал отчего так. Походу первую стадию они подавили по всем неактивным банкам кэша.

Но вторая стадия выборки срабатывает по всем остальным банкам кэша и читает данные от предыдущих команд.

ckotctvo
()
Ответ на: комментарий от ckotctvo

Надо было нулить их и писать 16 бит.

Там нулить было не обязательно. На стеке-то полное значение лежало. Можно было просто полностью его и загружать, а, вместо этого, ЗАГРУЖАЛАСЬ ЛИШЬ ЧАСТЬ. Не знаю, сделали они, в итоге, нуление, или полноценную загрузку, но нуление там было не панацеей.

непонятно, почему IRET так себя вел - ну похерь на стэке лишние биты в ноль и retайся.

Зачем??? Как раз на стеке лежали ВАЛИДНЫЕ биты, но инструкция их скипала, и, при этом, НЕ НУЛИЛА. То есть, 2 ошибки в 1 флаконе.

Но вторая стадия выборки срабатывает по всем остальным банкам кэша и читает данные от предыдущих команд.

Я полагаю, что там мультиплексор стоит, который должен выбрать нужную кеш-линию по тегу, когда таковой придёт от ММУ. Если замаскировать часть его входов, то он как раз и сможет разбить чтение из 1й кеш-линии на чтения из нескольких сразу.

anonmyous ★★★
()
Ответ на: комментарий от anonmyous

Я полагаю, что там мультиплексор стоит, который должен выбрать нужную кеш-линию по тегу, когда таковой придёт от ММУ. Если замаскировать часть его входов, то он как раз и сможет разбить чтение из 1й кеш-линии на чтения из нескольких сразу.

Вы практически угадали. Только не мультиплексор а буфер с дифф.выходом и output-enable и один из этих буферов будет активен.

Vipt-кэш работает на опережение mmu, массово читая все возможные подходящие строки и сохраняя их в регистры. Регистры прямо рядышком с небольшими банками памяти. А потом уже из этих регистров идет выборка. Читая свою линейку командой загрузки 32байтного вектора одновременно триггеришь чтение других линеек. А потом можно ходить и собирать застрявшие объедки этого первого чтения.

ckotctvo
()
Ответ на: комментарий от ckotctvo

Vipt-кэш работает на опережение mmu, массово читая все возможные подходящие строки и сохраняя их в регистры.

Мешанина какая-то. Кеш ни с какими регистрами не работает вообще. А если речь о том, как ядро из него читает, то совершенно не в кассу фраза «Vipt-кэш работает на опережение mmu», так как кеш в данном случае вообще не работает, у него другие задачи. А работает тот, кто из него пытается данные считать. И это вполне может быть просто мультиплексор.

И если даже представить, что я «понял» эту вашу наикривейшую фразу, то я всё равно не представляю, зачем там ещё 1 слой буферов городить.

anonmyous ★★★
()
Ответ на: комментарий от anonmyous

вы посмотрите как вообще устроен non-aliasing vipt-cache.

вот держите образовательную ссылку:

https://www.geeksforgeeks.org/computer-organization-architecture/virtually-indexed-physically-tagged-vipt-cache/

я всё равно не представляю, зачем там ещё 1 слой буферов городить.

потому что не заработает вообще. никак. ни за какие деньги. это физические ограничения: утечки транзисторов, которые суммируются, паразитная емкость которая суммируется и т.д.

поэтому ни один быстрый регистровый файл в «один ход» не работает.

ckotctvo
()
Ответ на: комментарий от ckotctvo

вы посмотрите как вообще устроен non-aliasing vipt-cache. вот держите образовательную ссылку:

Отлично. Теперь потрудитесь цитату привести, как «Vipt-кэш работает на опережение mmu, массово читая все возможные подходящие строки и сохраняя их в регистры» или хоть сколько-то похожий бред из статьи по ссылке. Вы ведь отвечаете за слова, правда? Тогда жду цитату, а не ещё 10 абстрактных ссылок, никак не подтверждающих вашу муть выше.

это физические ограничения: утечки транзисторов, которые суммируются, паразитная емкость которая суммируется и т.д.

Снова что-то крайне маловыразительное. Ну есть у транзисторов утечки, и ёмкости затвора у них есть. Как это мешает мультиплексором выбирать нужную кеш-линию по приходу тега - ума ни приложу.

поэтому ни один быстрый регистровый файл в «один ход» не работает.

Так и мультиплексор можно заранее настроить, спекулятивно. А, по приходу тега, он перенастраивается, если не угадал. Да вот беда: данная инструкция маскирует часть его входов - все, что выше 64 бит.

anonmyous ★★★
()
Ответ на: комментарий от anonmyous

Как это мешает мультиплексором выбирать нужную кеш-линию по приходу тега - ума ни приложу.

что-то мне подсказывает, что вы нихрена не понимаете в электронике. поэтому вам ничего и не мешает

ckotctvo
()
Ответ на: комментарий от ckotctvo

что-то мне подсказывает, что вы нихрена не понимаете в электронике. поэтому вам ничего и не мешает

Уж не знаю, что и где подсказывает вам, а вот мне - свои собственные глаза подсказывают, что вы, в течении всего трида, писали лишь всякую муть (не только мне писали), и ни разу не удосужились снизойти до конкретных разъяснений своей позиции. Что, как бы, намекает.

Так что, вместо банального «слив засчитан», ещё раз призываю вас нормально ответить на вопросы, или показать, где и в чём я был не прав.

anonmyous ★★★
()
Ответ на: комментарий от anonmyous

В статье же для нубов расписано, с картинками. VIPT-кэш читает данные параллельно с проверкой тэгов. Читает все потенциальные ячейки в регистр.

Вот гляди как это сделано в эльбрусе: http://www.mcst.ru/files/556f68/da0cd8/50e82c/000001/g.v._kristovskiy_yu.l._pogrebnoy_yu.m._potovin_s.a._soin_novyy_podhod_k_fizicheskomu_proektirovaniyu_kesha_pervogo_urovnya_dlya_mikroprotsessorov_serii_elbrus.pdf

Вон там регистр REG, за ним MUX. В нормальных процессорах, а не курильщика бабаяна таких блоков {память-регистр} много.

А в вообще нормальных, даже мультиплексора нет. Наверно всё дело в том, что в интернете описания регистровых файлов гуглятся только самые простые и сложно понять как работает современная быстрая SRAM. Отсюда вылезают какие-то мультиплексоры. Алё, так никто не делает если нужна скорость.

Нельзя просто взять схему из учебника, тупо напихать еще больше ячеек и сказать что это будет работать на 2ггц хотя бы. Потому что не будет. 100 закрытых транзисторов = 1 открытому.

Вот например как делают: https://shanbhag.ece.illinois.edu/publications/Ram-JSSCC2002.pdf

Картинка номер 7.

16 регистров х 16 банков. В каждом банке local bit line, которая работает как динамический регистр. В статье эти LBL уходят в блок похожий на ANDN, но его можно заменить на footless domino logic and, которая будет работать как мультиплексор но эти транзисторы будут собраны не в одном месте а вдоль линии.

и вуаля: кэш работает быстрее, но в нем застревают на проводах LBL предыдущие значения. И их можно считать если не обновить.

ckotctvo
()
Ответ на: комментарий от ckotctvo

Вон там регистр REG, за ним MUX.

Именно что, ЗА. В итоге, в регистр АЛУ это попадает напрямую с мукса, о чём я и говорил. Что внутри банков кеша ещё и внутренние буферники есть - ну окей, этой детали я не знал, но она ни на что и не влияет, так как за ними всё равно стоит мукс. И этот мукс можно настроить спекулятивно. И от него зависит значение, попавшее в регистр АЛУ.

А в вообще нормальных, даже мультиплексора нет.

У вас есть инсайды по лонгсону? И у меня нет.

Отсюда вылезают какие-то мультиплексоры. Алё, так никто не делает если нужна скорость.

А ельбрусу она совсем не нужна? :)

Вот например как делают:

Each LBL (1 per read port)
supports 16 bitcells and a two-way merge via a static NAND
gate. Data from the storage cell is read by two access transistors
per word (M1 and M2) on each LBL and thus forms a dynamic
16-way NAND–NOR

Ну отлично, но мне кажется, что, по сути, они просто расписали их мега-быстрый мукс. Как я понял, сначала ЭНДами сигналы гейтуют, а потом объединяют на монтажном ИЛИ.

которая будет работать как мультиплексор но эти транзисторы будут собраны не в одном месте а вдоль линии.

Ну хорошо, но это - физическая реализация. На картинке мы нарисуем тот же мукс, только напишем «very fast mux, consult schematic for details». Суть-то не меняется: именно этот девайс, как бы вы его ни называли, как раз и приводит к тому, что чтение становится не атомарным по 1й кеш-линии, а происходит сразу из нескольких, из-за спекулятивной пред-настройки, и последующей маскировки части входов этого девайса/мукса.

anonmyous ★★★
()
Ответ на: комментарий от anonmyous

Вообще то что вы называете мультиплексором если в схемах которые в вузах показывают. И которые вообще уродливы и бесполезны irl. А то что я привел по научному называется шина с предзарядом, поттяжкой к питанию и выходами с открытым коллектором. Из вредности сообщаю.

Но все таки радует что в целом я кажется смог донести механизм возникновения утечки. Как устроен китаепроц я не знаю но окромя вышеописанного подхода быстрых и компактных решений попросту нет.

Или так или никак. Что касается Эльбруса то это проц курильщика бабаяна. Они SRAM компилятором срама «dolphin» делают а нормальные люди из кастомных ячеек набирают. Поэтому у них на 28нм всего полтора гигагерца. А у интела на 130нм 6гигагерц а на 90 7.5ггц

ckotctvo
()
Последнее исправление: ckotctvo (всего исправлений: 1)
Ответ на: комментарий от ckotctvo

и выходами с открытым коллектором. Из вредности сообщаю.

Ну и не правильно сообщаете. Вам тут не ТТЛ-логика, и по этому там открытый сток, а не открытый коллектор.

Но все таки радует что в целом я кажется смог донести механизм возникновения утечки.

Да вам ещё в самом начале трида кто-то сказал, что есть «нечто между ними», что делает доступ к кеш-линии не атомарным. Вы его послали, хотя детали о том, мукс это, или что-то ещё - они вообще вторичны.

Что касается Эльбруса то это проц курильщика бабаяна.

Да он там миллион лет уже не работает. Он вообще-то в Интел, у которой «7.5ГГц» (с)

anonmyous ★★★
()
Ответ на: комментарий от anonmyous

Он вообще-то в Интел, у которой «7.5ГГц»

это понтование мцстшников. IRL они в жопе, причем именно потому, что делают не как все нормальные люди, а чудачат.

ckotctvo
()
Ответ на: комментарий от anonmyous

Я кстати поленился искать статью от МЦСТшников как они сам SRAM делали. Прикол в том, что они вообще не идут в многостадийную домино-логику, как интеловцы, а точно также порубили регистровый файл на кусочки по 16, но оставили дифференциальный выход. то есть нет подтяжки уровня на LBL, и между LBL и GBL стоит тупо nmos. это блин звездец. им в голову не приходит, что бедный дохлый транзистор в ячейке памяти должен шатать LBL и через проходной транзистор GBL в одно рыло. Чо ж оно 1.5ггц на 28нм-то тянет, а не как в врагов по 3 с чем-то…

ckotctvo
()
Ответ на: комментарий от ckotctvo

это понтование мцстшников. IRL они в жопе, причем именно потому, что делают не как все нормальные люди, а чудачат.

Кто-то говорит, что они из-за VLIW в жопе… Сколько людей, столько и мнений. И только они себя в жопе не считают. Тоже мнение.

но оставили дифференциальный выход.

Да я думаю, им лвдс за глаза хватает на данном этапе, ещё учитывая, что вообще непонятно, где теперь изготавливать. Думаю, простые и проверенные решения им сейчас важнее, чем оптимизация на уровне отдельных транзисторов.

anonmyous ★★★
()
Ответ на: комментарий от anonmyous

Сколько людей, столько и мнений. И только они себя в жопе не считают. Тоже мнение.

Ну, им оттуда явно виднее... ;))

Somebody ★★★★
()
Для того чтобы оставить комментарий войдите или зарегистрируйтесь.